Быстрые данные и доки
USB4 v2 и Thunderbolt 5 передают данные, PCIe и видео по одному кабелю. Скорость зависит от распределения полосы и возможностей устройств.
Что происходит после 80 Гбит/с?
От порта на ноутбуке до связей между ускорителями: как меняются скорость, устройство кабеля и сама задача соединения.
Накопитель передаёт файлы, монитор получает изображение, ускорители обмениваются результатами вычислений.
Выбор соединения зависит от объёма данных, задержки, длины линии и энергопотребления.
Внешний SSD и группа ускорителей требуют разной задержки и дальности. Одной скорости для выбора стандарта мало.
Чтобы сравнить скорости, уточните единицу измерения и направление передачи. Число может относиться к линии, порту, всем связям GPU или целому коммутатору.
У USB4 v2 симметричный режим даёт до 80 Гбит/с в каждом направлении. Если оба устройства поддерживают асимметричный режим, доступны до 120 Гбит/с в одну сторону и 40 Гбит/с в другую. Это полоса линии, а не скорость копирования файла.
Это пересчёт битов в байты. Служебный обмен и ограничения устройств снижают реальную скорость.
800GbE указывает скорость порта в одном направлении. Число физических линий зависит от режима.
В карточке NVIDIA это сумма направлений всех связей GPU. В более ранней статье указаны 3,6 ТБ/с.
На рабочем столе новые интерфейсы нужны для накопителя, монитора, связи двух компьютеров и внешней видеокарты.
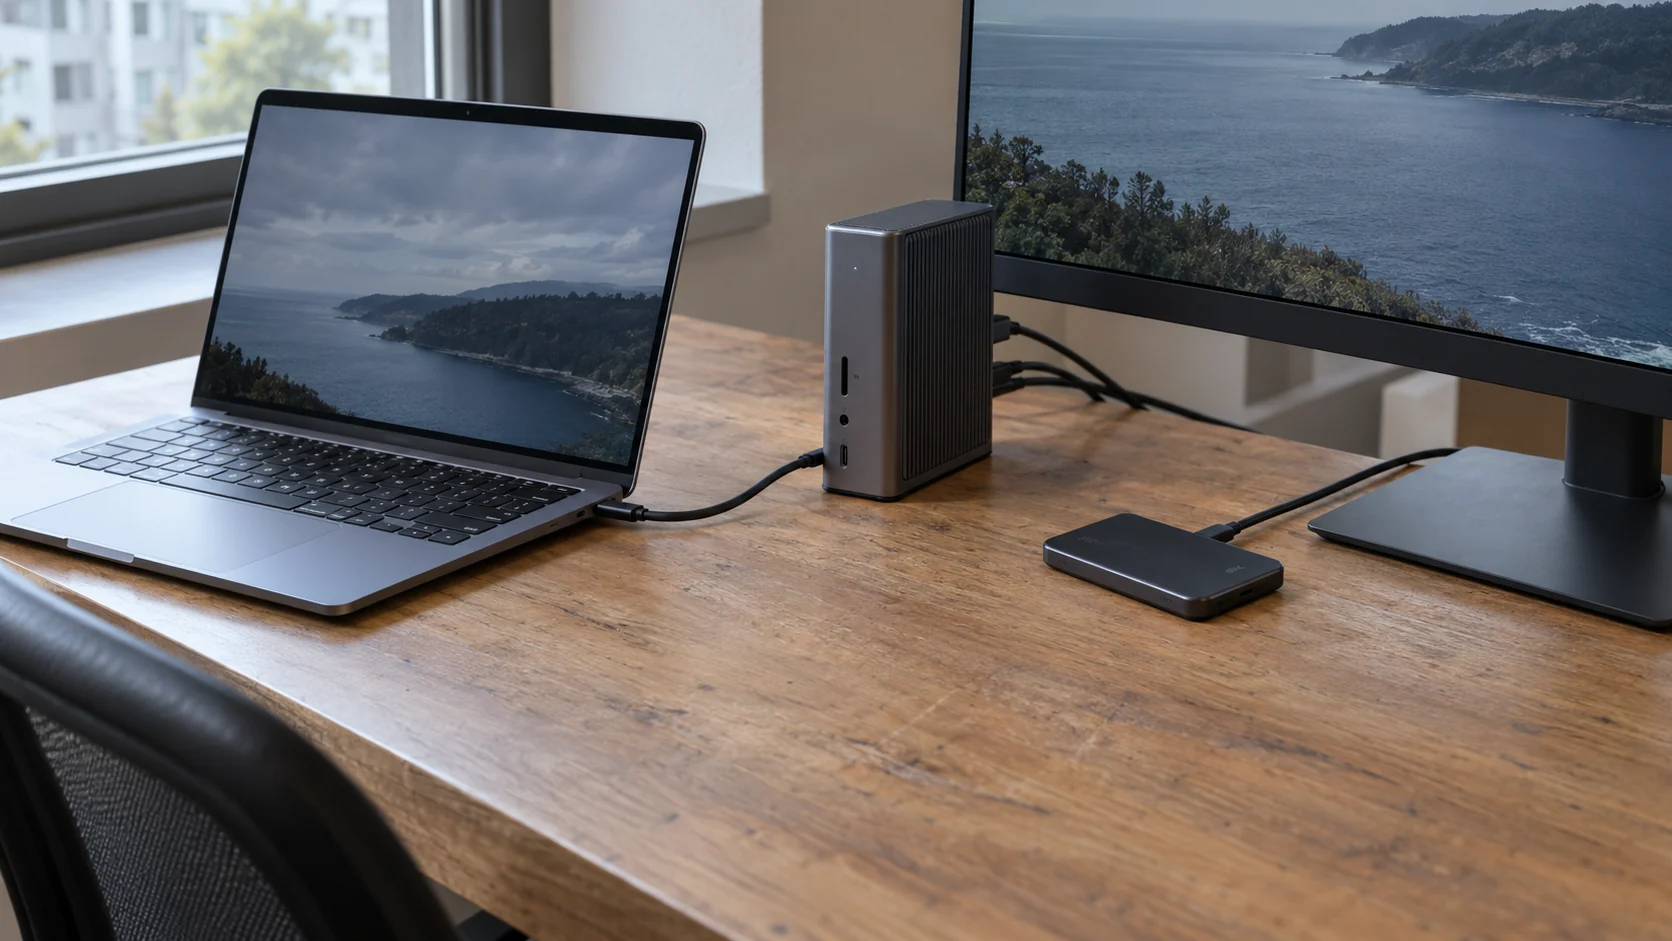
На скорость и доступные функции влияют порт компьютера, кабель и устройство на другом конце.
USB4 v2 и Thunderbolt 5 передают данные, PCIe и видео по одному кабелю. Скорость зависит от распределения полосы и возможностей устройств.
Для DisplayPort 2.1b, HDMI 2.2 и GPMI важны возможности порта, кабеля и экрана.
Thunderbolt networking / Share, Ethernet и прямое PCIe через OCuLink решают разные задачи.
Форма USB-C сама по себе не говорит о поддержке GPMI. Чтобы получить заявленные полосу и питание, проверьте порт, кабель и устройство.
Когда скорость растёт, передать электрический сигнал по длинному кабелю становится сложнее. Поэтому появляются активные кабели и оптические сборки, а оптику размещают ближе к чипу.
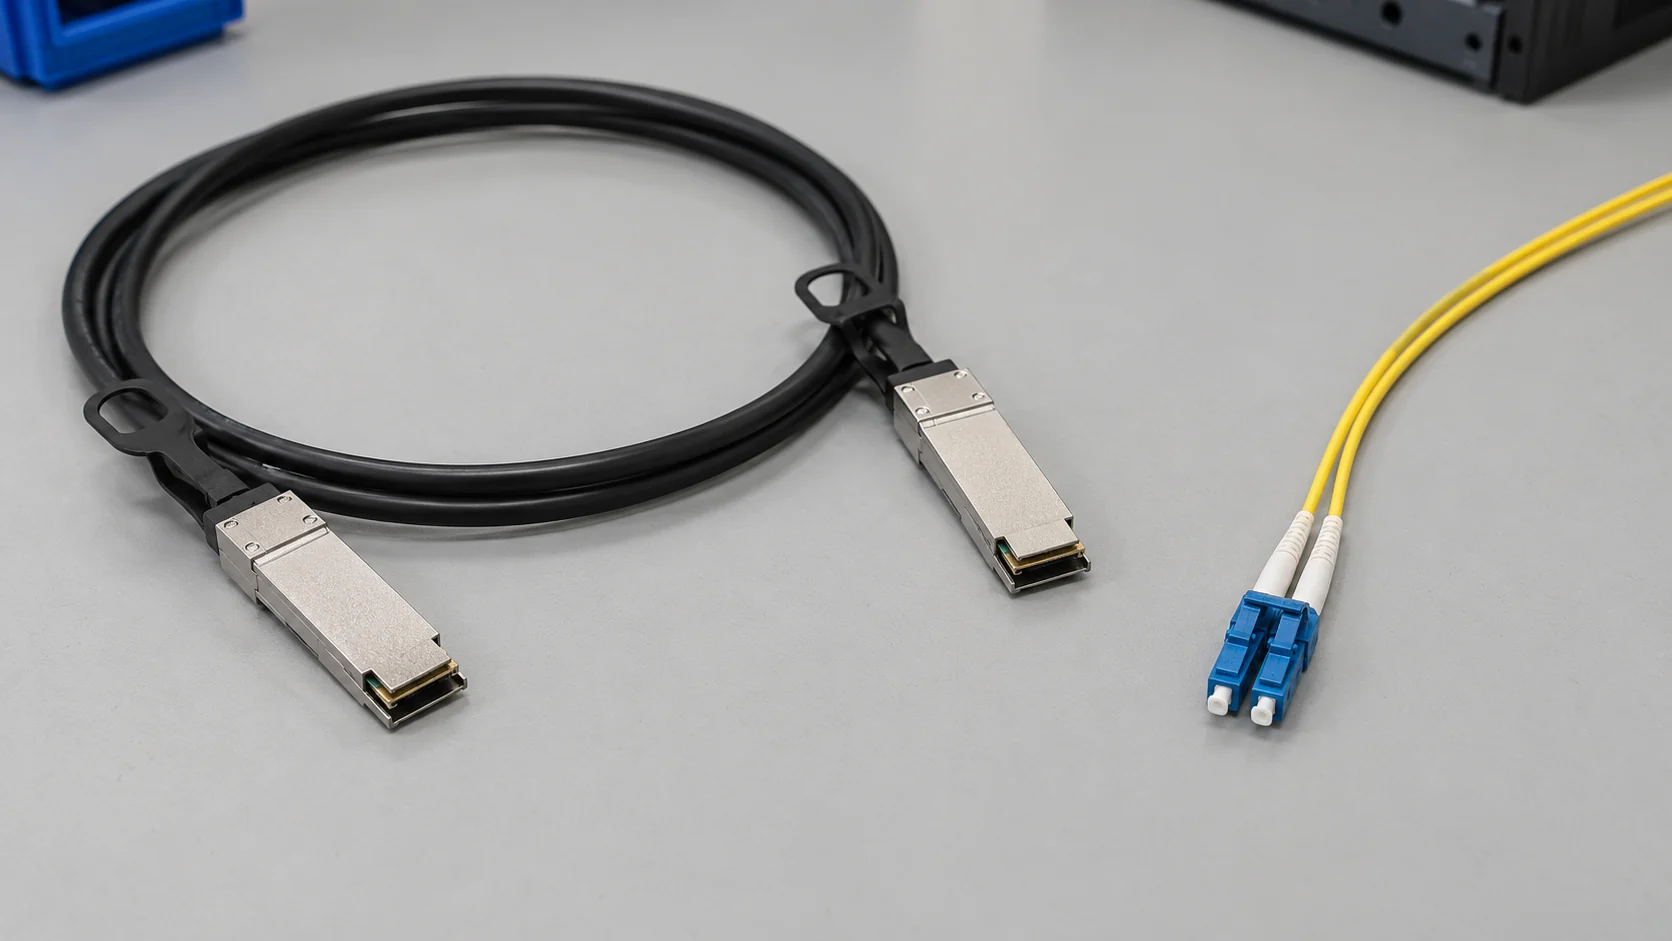
Пассивный DAC передаёт электрический сигнал по короткому кабелю. В ACC, LACC и AEC сигнал обрабатывает активная электроника. В AOC и оптических модулях он преобразуется в свет на концах линии.
В атласе можно сравнить OSFP, QSFP-DD, LC и MPO по форме и назначению.
Атлас разъёмов ↗У модуля и волоконного коннектора разные характеристики. При выборе учитывают корпус, число линий, протокол, тип оптики и тепловое исполнение.
В LPO иначе обрабатывается сигнал внутри модуля. При CPO оптический движок размещают ближе к чипу. OCI описывает общий оптический физический интерфейс.
Когерентные 400ZR, 800ZR и 1600ZR связывают удалённые площадки. Для 1600ZR указано до 120 км на усиленном DWDM-тракте.
Между двумя роутерами может быть соседняя стойка, другой корпус здания или целый город. Во всех случаях нужно передать данные, но длина линии меняет выбор оборудования. Разберём оптическое соединение: как электрический сигнал становится светом, что подключается к волокну и почему одинаковая скорость ещё не означает одинаковый кабель.
У сетевого устройства есть порт для сменного модуля. В него вставляют трансивер, то есть передатчик и приёмник в одном корпусе. Передатчик преобразует электрический сигнал в свет, приёмник на другом конце превращает свет обратно в электрический сигнал. Такая пара работает и в роутерах, и в коммутаторах.
В обычном дуплексном соединении одно волокно передаёт сигнал от первого устройства ко второму, а другое несёт сигнал в обратном направлении. Бывают и одноволоконные линии BiDi: встречные сигналы разделены по длинам волн. В этом случае два модуля образуют согласованную пару передатчиков и приёмников.
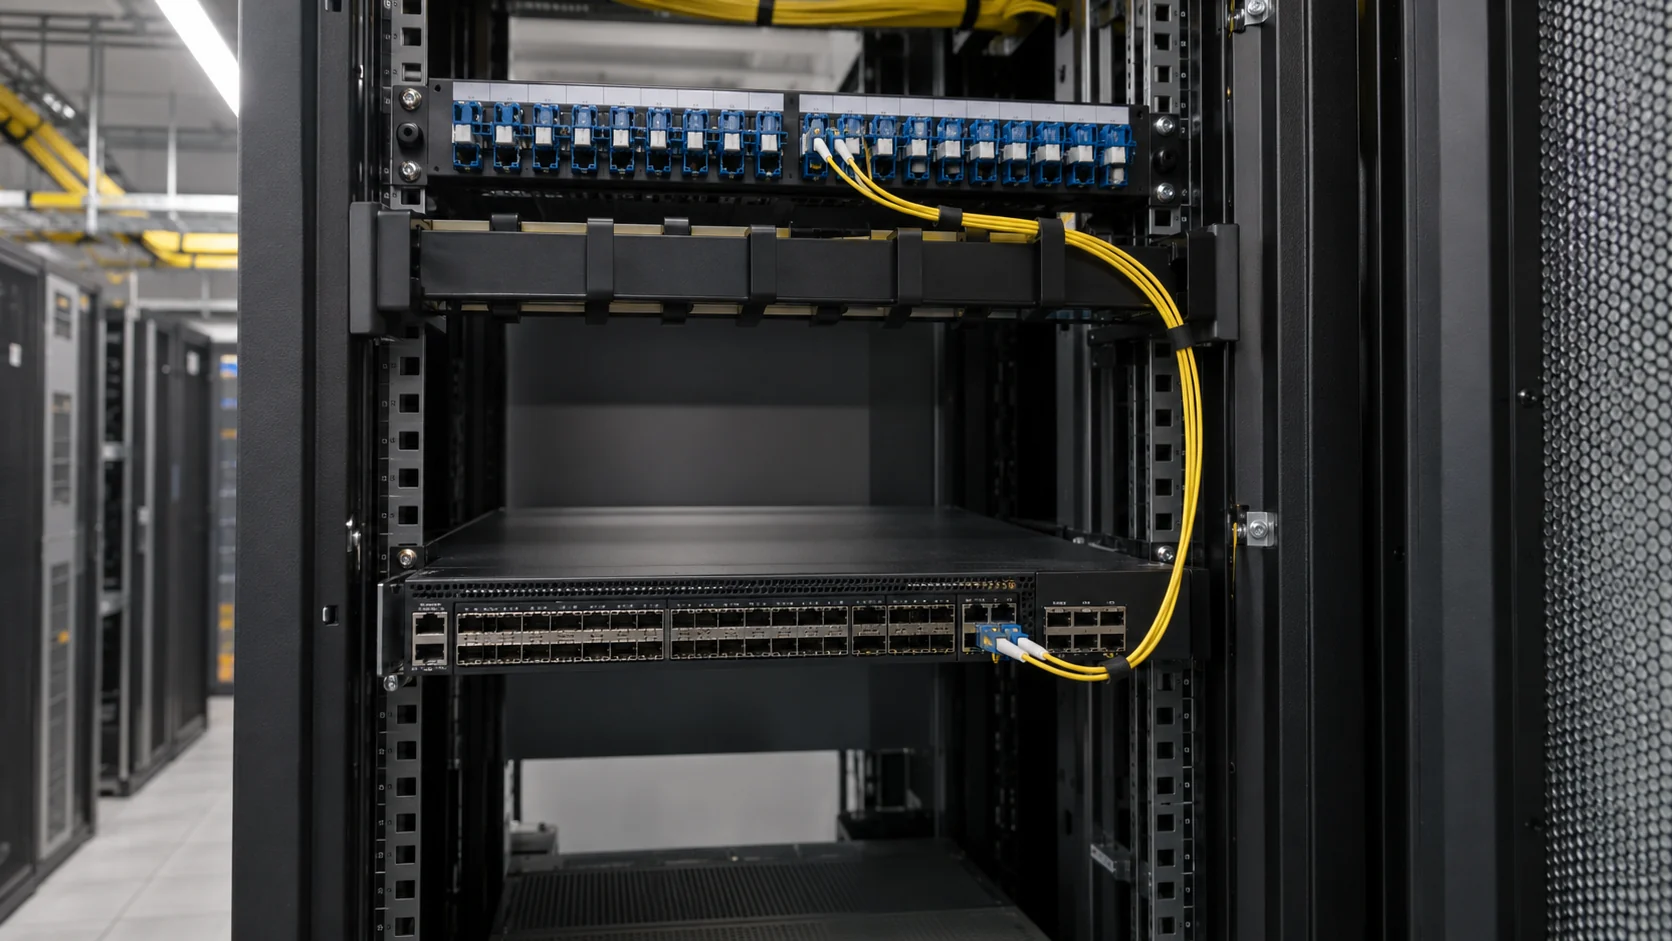
Эти названия описывают, как модуль подключается к оборудованию: его размеры, электрические контакты и конструкцию. Они помогают определить подходящий порт. Дальность и вид оптики задаёт конкретное исполнение трансивера.
LC соединяет отдельные волокна; два LC часто объединены в дуплексную пару. MPO объединяет несколько волокон в одном коннекторе. Такое окончание нужно, например, для параллельной передачи по нескольким оптическим линиям. Оно подключается к трансиверу со стороны кабеля.
Полное обозначение, например 10GBASE-SR или 100GBASE-DR, описывает физический режим Ethernet. Он определяет требования к сигналу и волокну. Поэтому при одинаковой скорости два трансивера могут использовать разные лазеры, число волокон и дальность.
Внутри каждой группы ниже скорость одинакова: 10 или 100 Гбит/с. Меняется способ передать этот поток. Многомодовые линии удобны для коротких трасс в здании; одномодовые исполнения позволяют соединять более удалённые точки. OM3 и OM4 обозначают классы многомодового волокна, от которых зависит допустимая длина линии.
| Режим | Волокно и окончание | Дальность по указанным модулям Cisco |
|---|---|---|
| 10GBASE-SR | Многомодовое OM3 / OM4, LC | До 300 / 400 м |
| 10GBASE-LR | Одномодовое G.652, LC | До 10 км |
| 10GBASE-ER | Одномодовое G.652, LC | До 40 км; требуется соблюдение оптического бюджета и допустимой мощности на приёмнике |
| 100GBASE-SR4 | Многомодовое OM3 / OM4, MPO-12 | До 70 / 100 м |
| 100GBASE-DR | Пара одномодовых волокон, LC | До 500 м |
| 100GBASE-FR1 | Пара одномодовых волокон, LC | До 2 км |
| 100GBASE-LR1 / LR4 | Пара одномодовых волокон, LC; одна / четыре длины волны | До 10 км для QSFP-100G-LR-S и QSFP-100G-LR4-S |
Конкретные режимы и условия: Cisco 10GBASE SFP+ ↗ · Cisco 100GBASE QSFP ↗.
Для линии 100G между соседними стойками может подойти SR4 по многомодовому волокну с окончанием MPO. Если трасса проходит между зданиями и достигает километра, пример FR1 из таблицы использует пару одномодовых волокон и LC. Скорость остаётся 100 Гбит/с; меняются модули и кабельная система. Переход с SR4 на FR1 требует пересмотреть оба конца и всю трассу.
Трасса включает соединители, сварки и иногда патч-панели. На каждом участке часть света теряется. Оптический бюджет показывает, какие суммарные потери допускает пара передатчика и приёмника. Именно поэтому дальность в километрах описывает условия применения модуля, а не обещает работу любого кабеля такой длины.
Между удалёнными площадками применяют когерентную оптику: приёмник учитывает амплитуду и фазу светового сигнала, что позволяет передавать больше информации в одном канале. DWDM позволяет передавать несколько каналов разных длин волн по одному волокну. 400ZR и последующие ZR-интерфейсы относятся к этому классу. Дальность такой системы зависит также от усилителей, фильтров и устройства магистрали.
Сначала определяют скорость и расстояние. Затем выбирают совместимый режим на двух концах, подходящее волокно и окончания. Корпус трансивера связывает эту оптику с портом оборудования. Так из отдельных названий SFP, LC и LR складывается понятная конструкция соединения.
Если добавить к задаче ещё сто ускорителей, она не обязательно закончится в сто раз быстрее. Ускорители должны получать данные, обмениваться результатами и ждать друг друга. Быстрая связь нужна, чтобы время вычислений не терялось в ожидании передачи.
Ускоритель, например GPU, выполняет множество вычислений параллельно и хранит данные в собственной памяти. Большую модель можно распределить между несколькими такими устройствами. Тогда результат одной части вычисления становится входом для другой, и данные приходится передавать между ускорителями.
Другой пример возникает при обучении: несколько GPU обрабатывают разные части набора данных, а затем объединяют вычисленные поправки к параметрам модели. Операция AllReduce сводит значения от участников и возвращает общий результат каждому. Согласованный шаг обучения требует завершить этот обмен; задержавшийся участник может заставить остальных ждать.
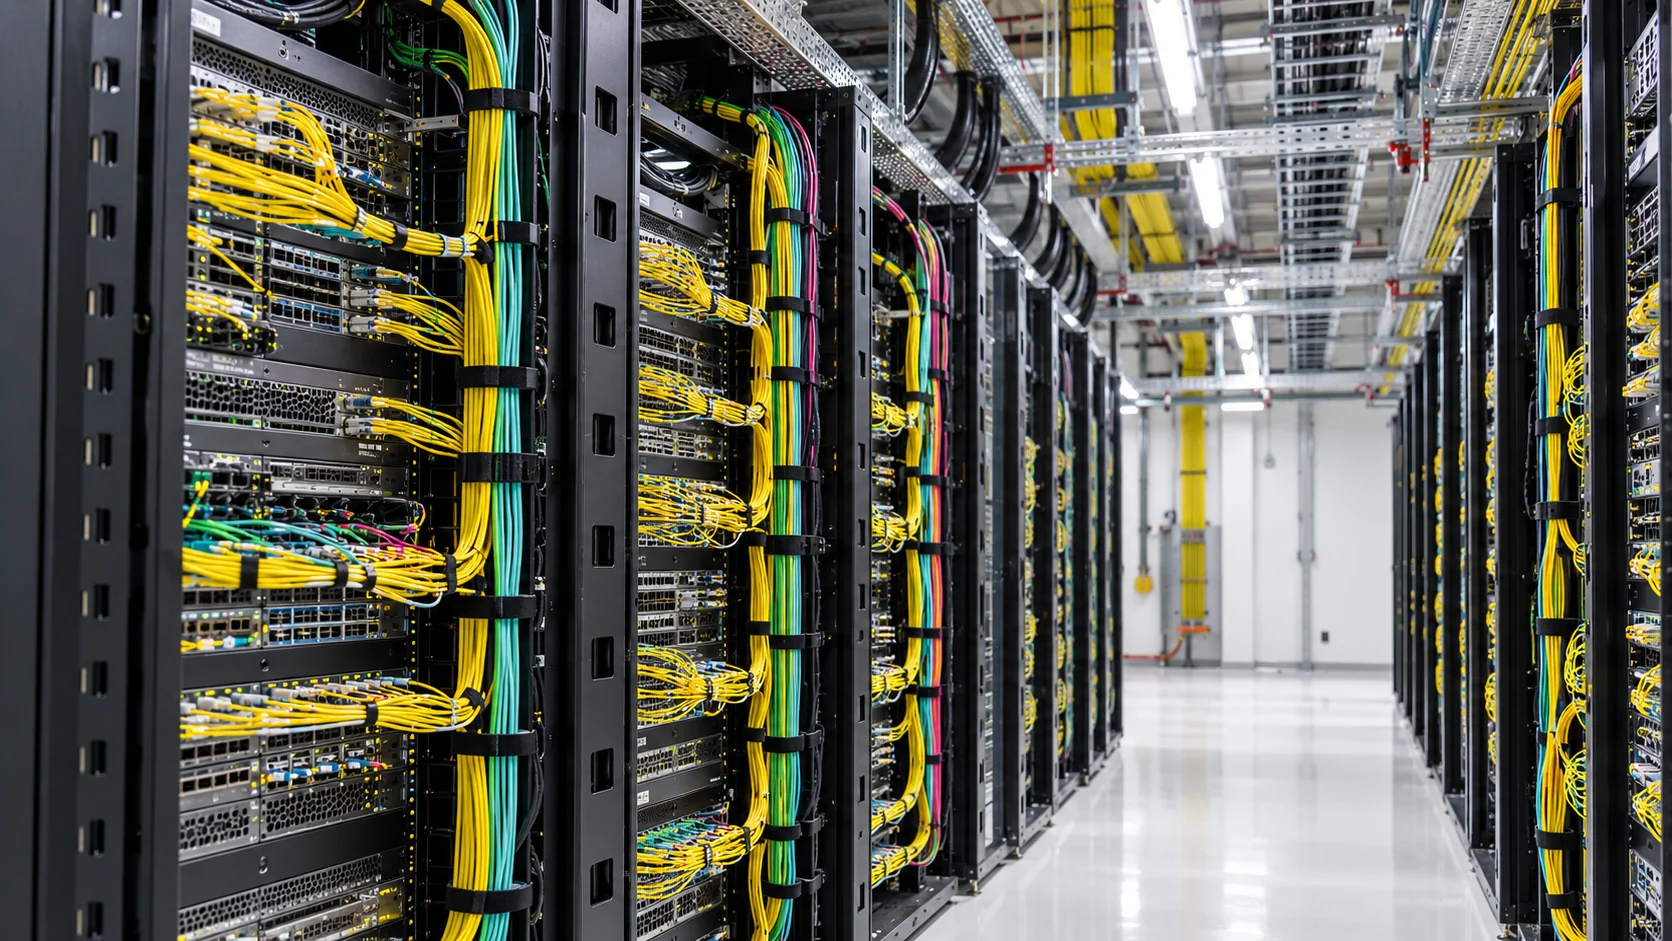
Scale-up связывает ускорители внутри группы, а scale-out соединяет группы через сеть. Такая группа может занимать больше одной стойки.
Внутри такой группы обмен идёт часто, а отдельные сообщения могут быть небольшими. Здесь важны короткая задержка и высокая пропускная способность между ускорителями. NVLink, Infinity Fabric и UALink решают эту задачу разными способами. Группа может включать несколько серверов; граница определяется архитектурой, а не только стенками стойки.
Узел объединяет процессоры, память, ускорители и сетевые адаптеры. Когда задача растёт, такие узлы связывают через коммутаторы. На этом уровне применяют Ethernet или InfiniBand. Сеть должна обслуживать одновременный обмен множества узлов и сохранять предсказуемую работу при перегрузке отдельных направлений.
RDMA означает удалённый прямой доступ к памяти. Сетевой адаптер переносит данные между заранее подготовленными областями памяти без участия удалённого CPU в самом копировании. Это снижает накладные расходы. RoCE переносит RDMA по Ethernet; GPUDirect RDMA позволяет включить в такой обмен память GPU на поддерживаемых платформах.
Пропускная способность показывает объём данных за секунду. Задержка показывает, как быстро доходит отдельное сообщение. Для большой передачи важна первая величина; для цепочки коротких взаимозависимых операций особенно важна вторая. Поэтому две сети с одинаковыми портами 800G могут по-разному выполнять одну задачу.
Есть и общая нагрузка: если многие узлы одновременно отправляют данные одному получателю, очередь возникает перед его портом. Управление перегрузкой регулирует передачу, а выбор маршрутов распределяет потоки по доступным путям. Новые сетевые спецификации для ИИ развивают именно эти механизмы вместе с увеличением скорости.
Пользователь отправляет запрос в сервис, который распределяет работу по вычислительным узлам. Обмен между этими узлами может влиять на время ответа и число запросов, которые система обслуживает одновременно. Это зависимость от устройства сервиса: ускорение отдельной линии помогает тогда, когда передача данных ограничивает выполнение задачи.
Смысл новых соединений в том, чтобы ускорители больше времени вычисляли и меньше ждали данные. Поэтому сравнение систем включает время обучения или ответа, нагрузку на CPU, расход энергии и устойчивость к сбоям наряду со скоростью портов.
NCCL: коллективный обмен ↗ · Как работает RDMA ↗ · GPUDirect RDMA ↗
Два дата-центра могут использовать одинаковые оптические модули и при этом иметь разные сети для ИИ. Различие начинается с того, какие ускорители выполняют задачу, как они обращаются к памяти друг друга и какое программное обеспечение управляет обменом. Отсюда собственные архитектуры производителей и попытки договориться об общих стандартах.
Производителю нужно связать ускорители так, чтобы они эффективно выполняли совместную задачу. Заказчику важны время вычисления, расход энергии, надёжность и возможность расширить систему. Связь внутри группы GPU и сеть между серверами влияют на эти свойства по-разному.
Собственная архитектура позволяет согласовать ускоритель, коммутатор и программные библиотеки. Общая спецификация даёт разным компаниям единое описание интерфейса. Чтобы оборудование работало вместе, производители должны реализовать нужные версии, а затем подтвердить совместимость. Именно на этом этапе общий стандарт превращается в выбор готовых изделий.
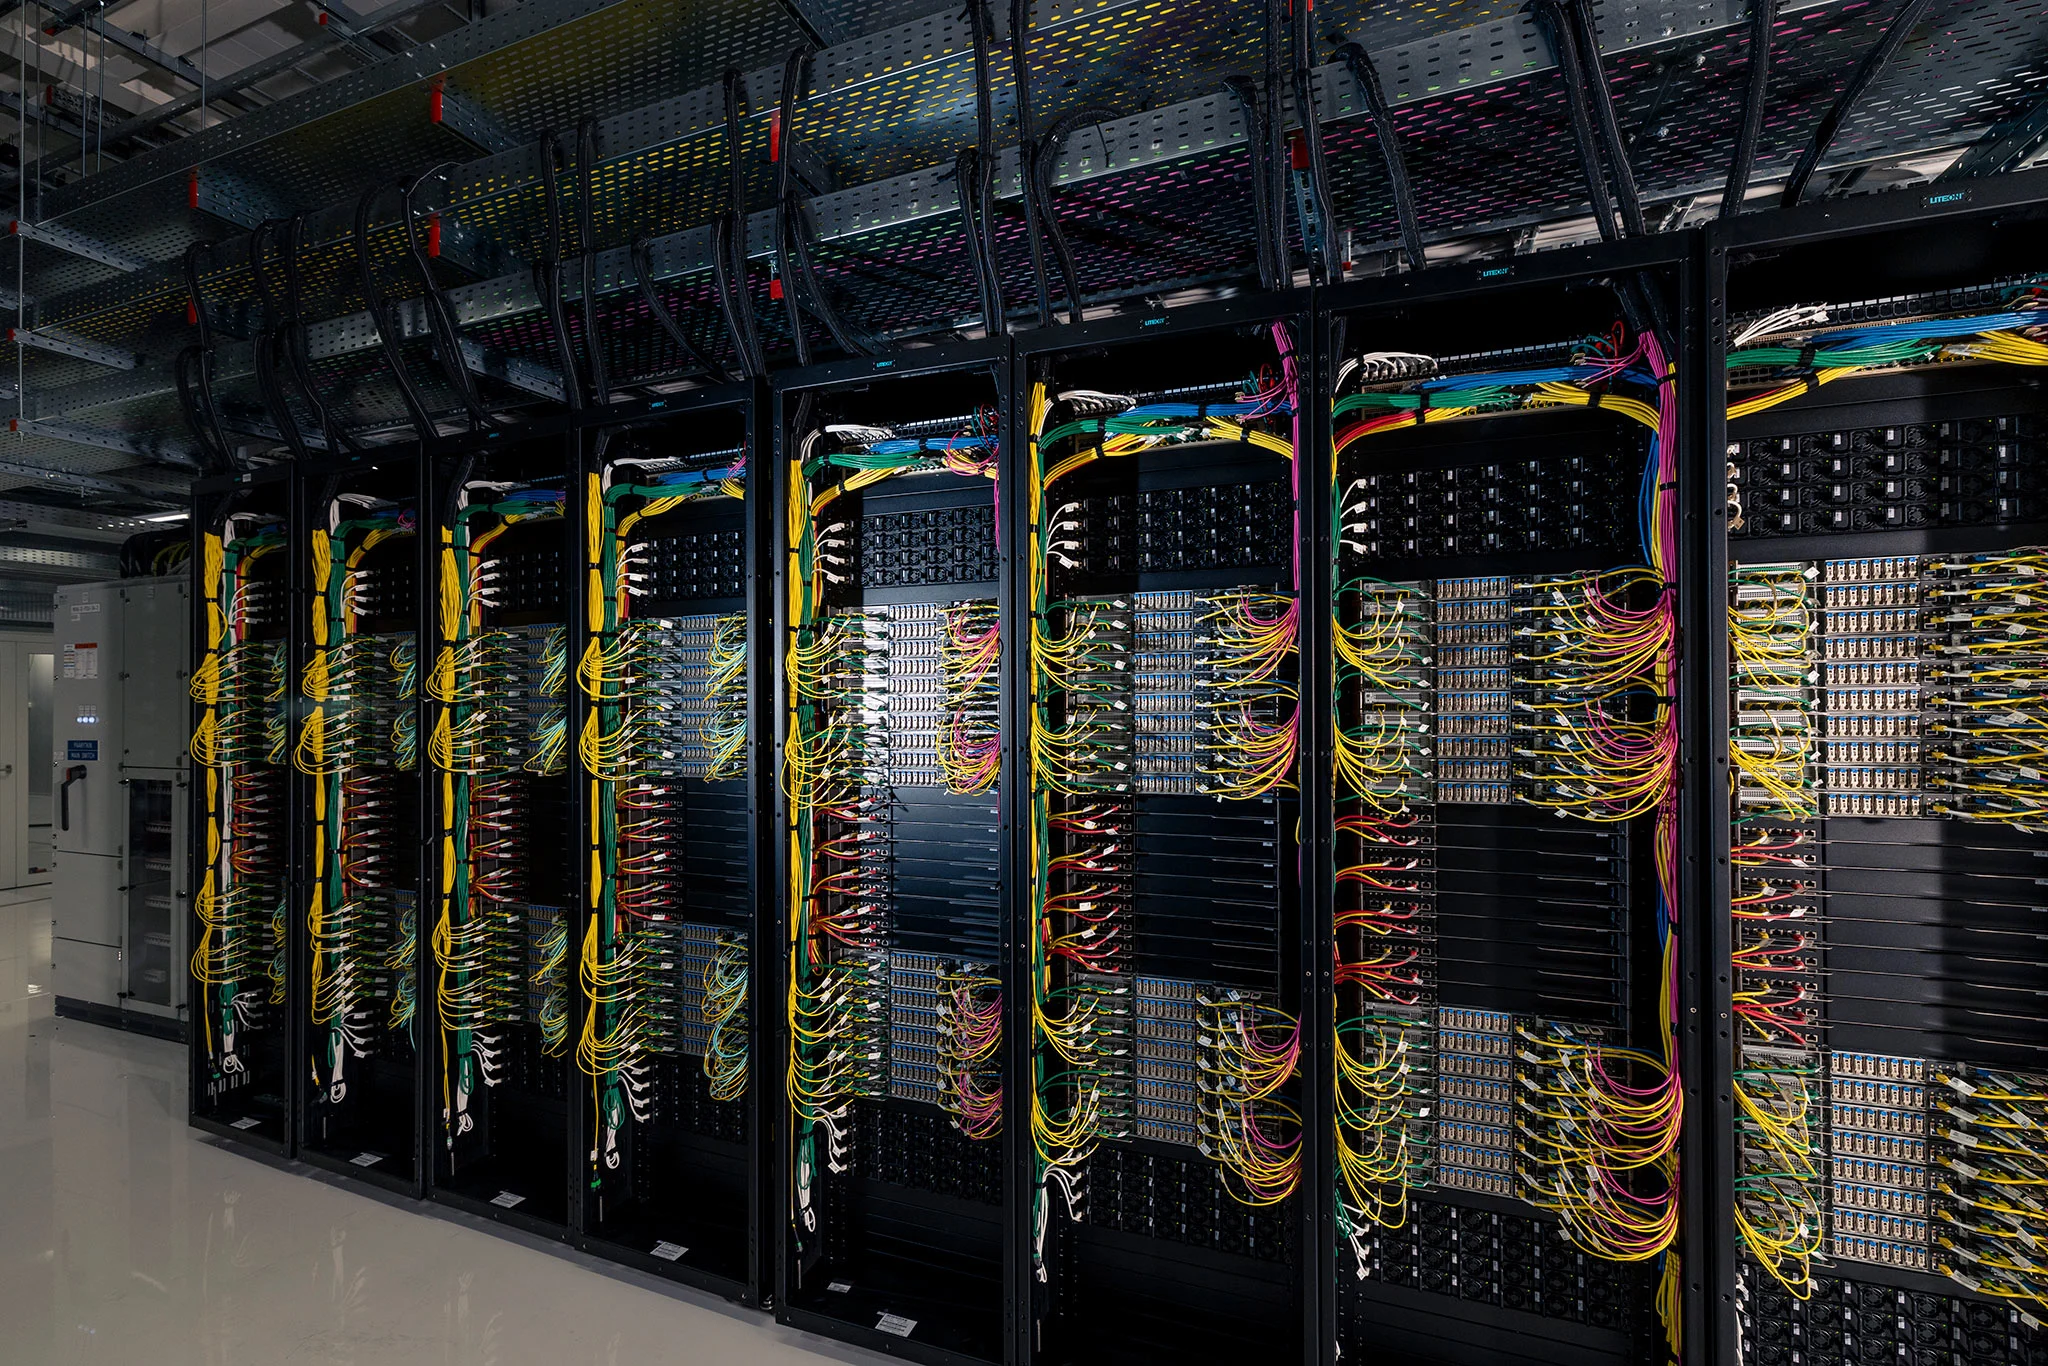
NVLink связывает GPU внутри вычислительной группы, а NVLink Switch организует обмен между ними. Для NVLink 5 на Blackwell NVIDIA указывает 1,8 ТБ/с на GPU в сумме двух направлений. Это совокупная полоса связей одного ускорителя; её нельзя напрямую сравнивать со скоростью отдельного сетевого порта.
Для сети между узлами NVIDIA предлагает Spectrum-X на базе Ethernet и RoCE, а также Quantum на базе InfiniBand. Это два варианта сетевой инфраструктуры, которые дополняют NVLink.
NVLink Fusion расширяет участие партнёров: они могут разрабатывать ASIC или CPU для совместной работы с архитектурой NVLink. Это отдельная программа интеграции, со своими требованиями к оборудованию.
В платформах MI300 и MI350 связи ускорителей построены на Infinity Fabric/XGMI. Для Helios с MI455X AMD описывает UALoE, то есть UALink over Ethernet. В этом решении Ethernet служит транспортом для обмена внутри группы GPU.
В описании Helios от июля 2026 года AMD говорит о группе из 72 MI455X. Для сети между группами предназначен адаптер Vulcano 800; Pollara 400 относится к сетям существующих кластеров. Внутренняя связь группы и её внешние сетевые адаптеры выполняют разные функции.
Поэтому название «AMD Instinct» само по себе не определяет интерфейс: у нескольких поколений одной линейки могут быть разные способы соединения ускорителей.
Google объединяет TPU через ICI, Inter-Chip Interconnect. В TPU7x связи между чипами образуют трёхмерную сетку, а сеть дата-центра вынесена в отдельный уровень. Такая топология определяет, как данные перемещаются между соседними ускорителями и более крупными вычислительными группами.
AWS использует NeuronLink и NeuronSwitch в системах Trainium. Trn3 UltraServer объединяет до 144 чипов Trainium3; в описании AWS указана полоса NeuronLink до 2 ТБ/с на чип. Системы далее объединяются в UltraCluster. Для разработчика важны также инструменты AWS Neuron, через которые программа использует эту архитектуру.
В обоих случаях заказчик получает вычисления через облачный сервис. Он выбирает тип ресурса и программную среду, а физическое устройство внутренних связей определяет поставщик облака.
Google TPU7x ↗ · AWS Trn3 UltraServers ↗
Общая сеть состоит из нескольких уровней. Можно согласовать оптическую передачу сигнала и сохранить разные правила обмена данными. Можно развивать единый транспорт и использовать разные ускорители. Поэтому участие NVIDIA, AMD или облачной компании в консорциуме не отменяет её собственной архитектуры.
| Направление | Кто участвует | Что оно определяет |
|---|---|---|
| UALink ↗ | AMD, Broadcom, Google, MicrosoftСостав инициативыИнициаторы: AMD, Broadcom, Cisco, Google, HPE, Intel, Meta, Microsoft | Обмен внутри группы ускорителей. Документы описывают общие операции, канальный и физический уровни, чиплеты и управление |
| Ultra Ethernet ↗ | AMD, Arista, Meta, MicrosoftСостав инициативыОснователи: AMD, Arista, Broadcom, Cisco, Eviden, HPE, Intel, Meta, Microsoft; NVIDIA вступила позднее | Сетевой стек для ИИ и высокопроизводительных вычислений, включая транспорт UET |
| ESUN / SUE-T ↗ | Meta, Microsoft, NVIDIA, OpenAIСостав инициативыOCP; инициативу ESUN основали в том числе AMD, Arista, Arm, Broadcom, Cisco, HPE Networking, Marvell, Meta, Microsoft, NVIDIA, OpenAI и Oracle | ESUN описывает сеть scale-up, SUE-T транспорт конечных устройств |
| OCI ↗ | AMD, Broadcom, NVIDIA, OpenAIСостав инициативыОснователи: AMD, Broadcom, Meta, Microsoft, NVIDIA, OpenAI | Оптический физический интерфейс для передачи сигналов между чипами |
UALink описывает обмен ускорителей внутри вычислительной группы. Ultra Ethernet развивает сетевой стек для ИИ и высокопроизводительных вычислений; его транспорт называется UET. ESUN формулирует требования к Ethernet-сети для тесно связанных ускорителей, а SUE-T относится к транспорту конечных устройств. OCI сосредоточен на оптическом физическом интерфейсе. Эти названия описывают разные задачи, поэтому они могут встречаться в одной системе.
Huawei развивает UnifiedBus для связи вычислительных ресурсов. Это дополнительное направление наряду с NVLink, UALink и облачными архитектурами. Конкретный набор операций и поддерживаемое оборудование определяется документами UB и моделью системы.
Нужно понимать, какие данные устройства передают и как обращаются к памяти. Затем рассматривают транспорт и физическую линию. Одинаковые OSFP или Ethernet-порты описывают лишь часть этой цепочки. Полная система включает ускорители, сеть и программные средства обмена.
Запрос к модели ИИ должен добраться до вычислительного сервиса, а внутри сервиса ускорители обмениваются данными для обучения и ответа. Colossus и Starlink показывают эти задачи на разных масштабах: сеть дата-центра связывает вычислители, спутниковая сеть соединяет пользователей и наземные сети через орбиту.
xAI, разработчик Grok, вошла в SpaceX 2 февраля 2026 года. Объединение компаний сделало тему связи между ИИ и космической инфраструктурой особенно заметной. Чтобы понять её технический смысл, рассмотрим отдельно работающую сеть Colossus, действующий спутниковый транспорт и планы орбитальных вычислений.
В описании первого Colossus, опубликованном NVIDIA в октябре 2024 года, речь идёт о 100 тысячах ускорителей Hopper. Для их сетевого обмена xAI выбрала Spectrum-X, коммутаторы SN5600 и адаптеры BlueField-3. RDMA помогает передавать данные между подготовленными областями памяти с меньшим участием CPU в копировании.
Сервер с ускорителями BlueField-3 оптическая линия 400GbE коммутатор SN5600
Линия передаёт данные между сервером и коммутатором. Коммутатор направляет их к другим серверам; сетевые механизмы регулируют одновременную передачу большого числа участников.
Материал Supermicro о той же установке описывает оптические подключения 400GbE. У SN5600 максимальная скорость порта составляет 800 Гбит/с. Эти числа относятся к разным характеристикам: фактическому серверному соединению и возможностям коммутатора. У Supermicro также описана отдельная сеть для CPU и других ресурсов кластера.
Такой пример показывает, зачем дата-центру несколько сетей. Обмен данными ускорителей, доступ к хранилищу и обслуживание остальных серверных ресурсов создают разные потоки. Приведённые параметры относятся к описанию 2024 года; последующие расширения Colossus требуют собственных технических данных.
NVIDIA: Colossus, 2024 ↗ · Supermicro: серверы и сети ↗
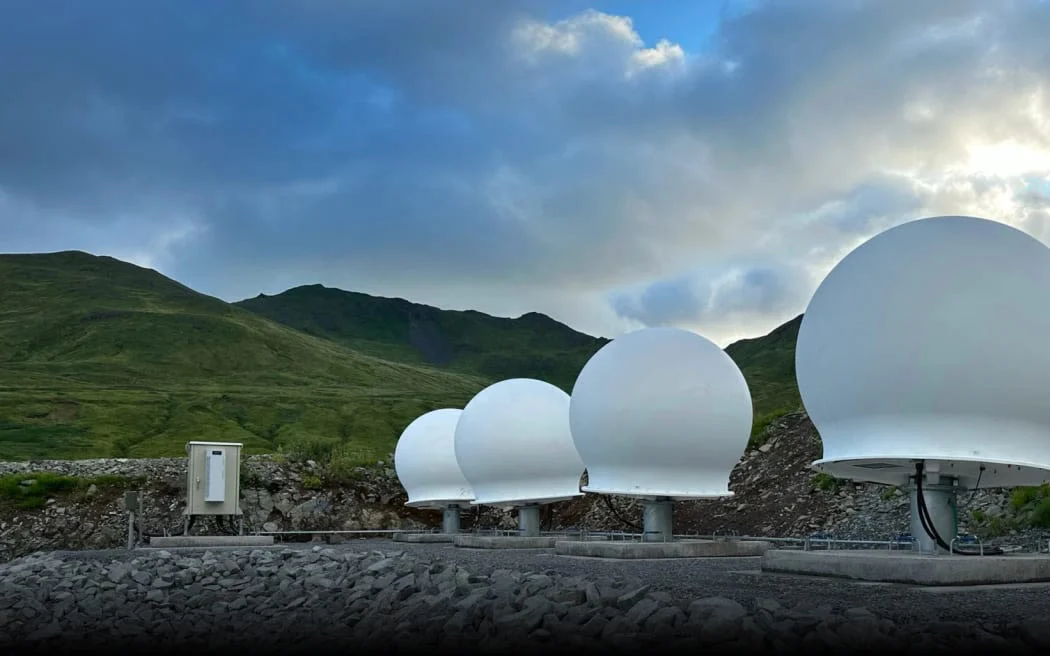
У Starlink физическая линия меняется по ходу маршрута. Терминал на Земле работает по радио, спутники могут передавать трафик между собой лазерами, а наземная инфраструктура связывает спутниковую систему с внешними сетями. Поэтому у каждого участка свои оборудование, пропускная способность и ограничения.
Абонентский терминал передаёт и принимает радиосигнал в диапазоне Ku. Он устанавливает связь со спутником, который движется относительно наблюдателя. Этот участок определяет возможности доступа абонента вместе с нагрузкой сети и условиями сервиса.
ISL означает межспутниковую связь. В опубликованном описании Starlink для оптической линии указано до 200 Гбит/с. Лазерный терминал направляет луч на другой спутник, чтобы передать трафик по орбитальной сети. Это характеристика межспутникового участка; абонент получает отдельную полосу сервиса.
Шлюзовые станции используют радиолинии, в том числе Ka. Далее данные идут по наземной инфраструктуре к точкам присутствия, PoP, где сети обмениваются трафиком. Конкретный маршрут зависит от доступных спутников, шлюзов и состояния сети.
Dedicated Service, прежде называвшийся Community Gateway, предназначен для корпоративных и операторских подключений. В варианте Bonded Gateways Starlink объединяет несколько шлюзовых антенн и заявляет до 20 Гбит/с на приём и на передачу. Четыре антенны поддерживают до 10 Гбит/с; для большей полосы нужны дополнительные антенны. В состав решения входит маршрутизатор агрегации.
У такого соединения практическая задача: дать внешнюю связь местной сети. Дальше оператор распределяет пропускную способность между её пользователями. Поэтому характеристику всей шлюзовой установки читают отдельно от скорости домашнего терминала и от скорости одного спутникового лазера.
Технологии Starlink ↗ · Dedicated Service и Bonded Gateways ↗
SpaceX описывает орбитальные вычисления как будущую программу. В проспекте от июня 2026 года компания называет 2028 год возможным началом развёртывания вычислительных спутников. Предполагается использовать солнечную энергию и Starlink для глобальной связи; сроки и экономический результат остаются планами компании.
Для такого проекта связь станет частью более широкой инженерной системы. Вычислителям потребуются питание, отвод тепла и работа при отказах. В вакууме нет охлаждения потоком воздуха: тепло приходится отводить к излучающим поверхностям. Поэтому опыт лазерной связи помогает построить каналы между спутниками, а устройство вычислительного комплекса требует отдельных решений.
Объединение xAI и SpaceX ↗ · SpaceX: планы орбитальных вычислений ↗ · NASA: тепловой режим аппаратов ↗
В Colossus сеть обслуживает совместную работу ускорителей. Starlink доставляет трафик через радиоканалы и спутниковые лазеры к наземным сетям. Это разные участки возможного пути к вычислительному сервису. Опубликованные технические описания не устанавливают отдельный прямой канал Starlink–Colossus с известными параметрами.
Ускоритель, память и кристаллы внутри корпуса соединяются на разных физических расстояниях.
PCIe и CopprLink соединяют устройства. CXL добавляет доступ к памяти, UCIe связывает кристаллы внутри одного корпуса.
Новые соединения развиваются сразу в нескольких местах: на плате компьютера, между серверами и внутри корпуса чипа. Одни проекты увеличивают скорость передачи, другие меняют доступ к памяти или помогают собрать большую вычислительную группу. Польза зависит от того, какую задачу решает каждый интерфейс.
Проект спецификации обсуждают и уточняют, затем публикуют согласованный документ. Производителям нужны контроллеры, платы и программная поддержка. После этого устройства проходят проверку совместимости и поступают в продажу. Опытные изделия могут появиться до завершения документа, поэтому два пути не всегда идут строго друг за другом.
PCIe связывает процессор с ускорителями, сетевыми картами и накопителями. Для версии 8.0 PCI-SIG ставит цель 256 ГТ/с на линию. Для соединения x16 указана совокупная теоретическая полоса до 1 ТБ/с в двух направлениях. ГТ/с означает число передач за секунду; полезная скорость зависит от кодирования и служебного обмена.
Опубликован для участников черновик 0.3, целевой год завершения спецификации: 2028. Такой интерфейс нужен прежде всего системам, где несколько устройств передают большие потоки одновременно. Доступность контроллеров и готовых компьютеров будет отдельным этапом.
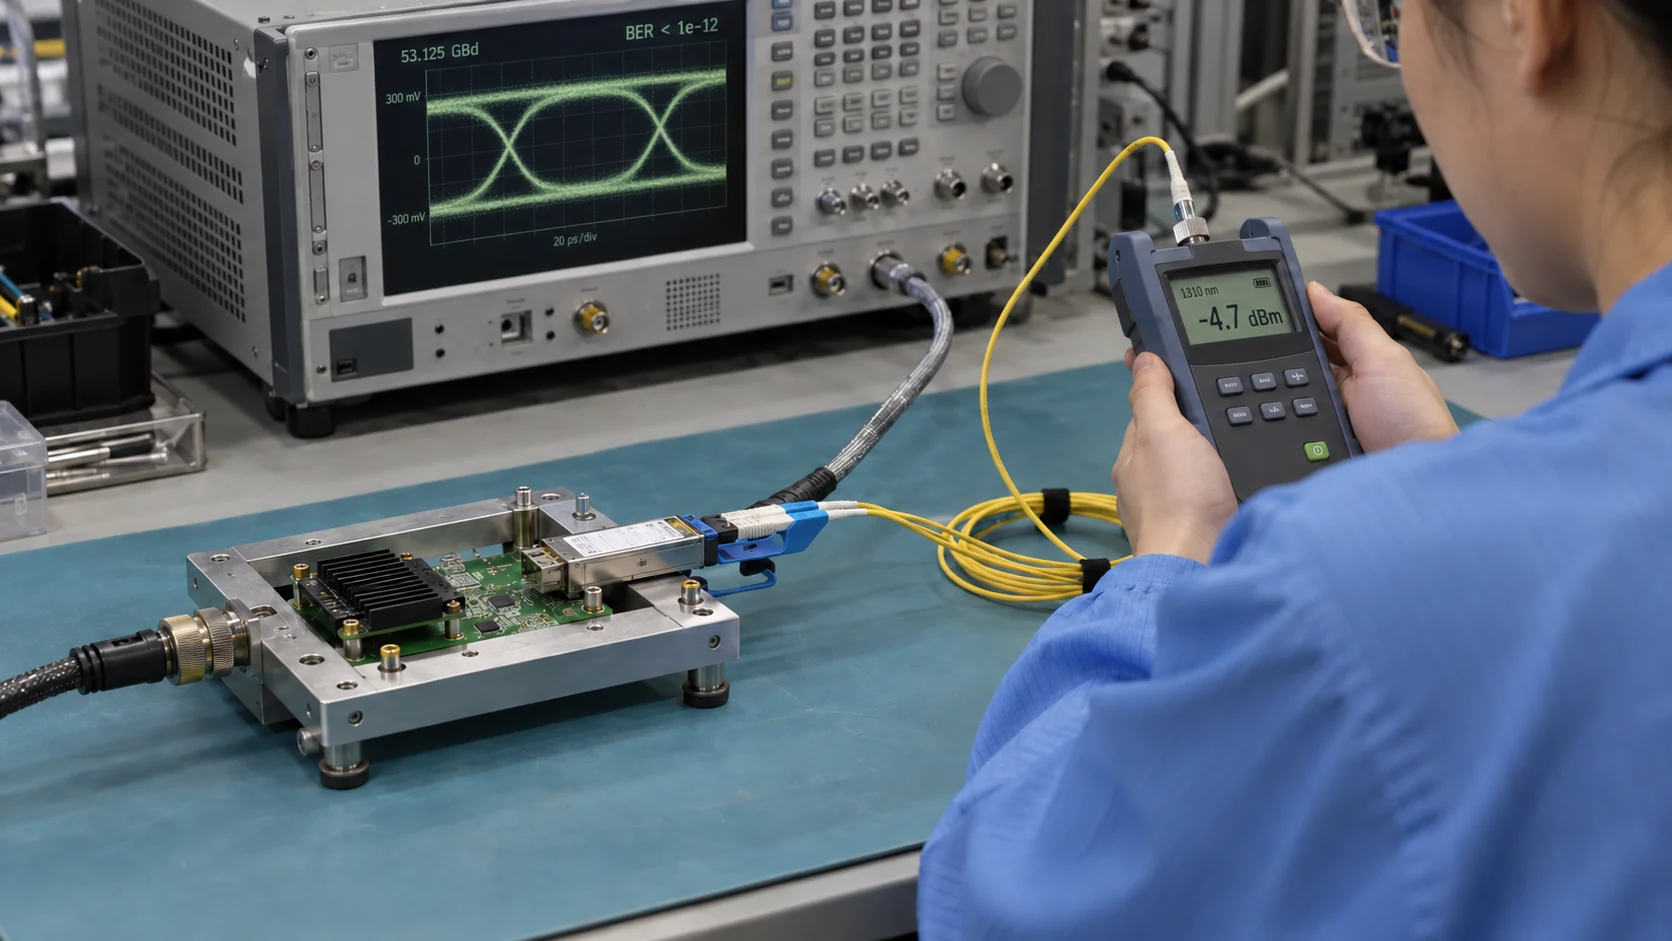
Проект IEEE P802.3dj описывает режимы 200G, 400G, 800G и 1,6T с новым поколением физических линий. Для порта 1,6T это до 1,6 Тбит/с в одном направлении. У такой скорости практический смысл в сети между серверами: через порт можно передавать больший объём данных за то же время.
В октябре 2026 года проект находится на повторном голосовании по черновику D3.3. До окончательного утверждения оборудование и заявления производителей нужно сопоставлять с конкретными режимами проекта. Для домашних сетей внедрение такой скорости не требуется автоматически: основной спрос здесь создают вычислительные системы и дата-центры.
CEI, Common Electrical I/O, описывает электрические интерфейсы между компонентами. Направление 448G исследует передачу класса 448 Гбит/с на одну линию. OIF опубликовал рамочный документ: он рассматривает физические ограничения, варианты сигналов, расстояния и задачи измерения для будущих согласованных интерфейсов.
Более быстрые линии могут увеличить полосу между чипом и модулем или передать нужный объём данных меньшим числом линий. При этом растут требования к качеству сигнала, конструкции соединителей и расходу энергии. Рамочный документ задаёт направление работы; готовность отдельных интерфейсов и изделий оценивается отдельно.
PCI-SIG: цели PCIe 8.0 ↗ · IEEE: голосование P802.3dj ↗ · OIF: рамочный документ CEI-448G ↗
Будущее соединений включает и технологии с готовыми спецификациями. Для них следующий шаг состоит в выпуске и совместной работе оборудования. Здесь важны уже не только новые рекорды скорости, но и способы использовать ресурсы системы.
| Технология | Что уже определено | Что это даёт системе |
|---|---|---|
| UALink | Доступны Common 2.0 и отдельные документы канального и физического уровней | Общие правила связи ускорителей. Common 2.0 добавляет вычисления внутри сети, чтобы часть коллективного обмена обрабатывалась по пути |
| Ultra Ethernet | Первая спецификация 1.0 вышла в 2025; опубликована редакция 1.0.3 | Транспорт UET и механизмы для массового параллельного обмена в сетях ИИ и научных вычислений |
| CXL 4.0 | Спецификация опубликована в 2025; скорость линий увеличена до 128 ГТ/с | Развитие связей процессора и памяти, объединение портов и повышение надёжности. Подход помогает строить системы с расширяемыми ресурсами памяти |
| UCIe 3.0 | Спецификация опубликована в 2025; поддерживает до 64 ГТ/с | Более быстрый обмен между чиплетами, отдельными кристаллами внутри одного корпуса. Это внутренний интерфейс будущих процессоров и ускорителей |
| OCI | Опубликована техническая спецификация оптического интерфейса | Более тесная интеграция оптики с вычислительными и сетевыми чипами. Цели включают плотность соединений, малую задержку и снижение затрат энергии на передачу |
UALink ↗ · Ultra Ethernet ↗ · CXL 4.0 ↗ · UCIe 3.0 ↗ · OCI ↗
В компьютере новые поколения PCIe могут увеличить доступную полосу для накопителей и внешних устройств. Польза появится при поддержке интерфейса обоими концами и при достаточной скорости самого устройства. Если накопитель передаёт данные медленнее, чем позволяет порт, более быстрый PCIe не ускорит его работу.
CXL и UCIe в первую очередь меняют устройство вычислительной платформы: как подключается память и как несколько кристаллов работают в одном корпусе. Пользователь увидит результат в характеристиках готового компьютера или сервера. UCIe размещают внутри корпуса микросхемы, поэтому пользователь выбирает готовую вычислительную платформу.
В облачном сервисе более эффективные сети могут сократить время ожидания данных и повысить загрузку ускорителей. Возможный результат для пользователя связан с производительностью и доступностью сервиса. Цена и время ответа зависят также от модели, программного обеспечения и нагрузки; сам по себе новый сетевой стандарт их не определяет.
Проект показывает, какие возможности разработчики хотят получить. Спецификация описывает согласованные правила. Готовое изделие показывает, какие из этих возможностей уже реализованы. Такая последовательность помогает понять пользу стандарта и выбрать подходящий момент для перехода на новое оборудование.
25 статей о соединениях: выберите тему и откройте полный разбор.
Показаны все тематические группы.
21 тип разъёмов и модулей: внешний вид, скорость, питание, даты появления и готовые изделия.
Открыть атлас