В паспорте коммутатора HPE Slingshot 400, версии QuickSpecs от 8 сентября 2026 года, пропускная способность указана дважды. В обзоре написано 51,2 Тбит/с. В таблице технических характеристик того же документа стоит 25,6 Тбит/с. А NVIDIA для своего коммутатора InfiniBand Q3400 со 144 портами по 800 Гбит/с указывает 115,2 Тбит/с, то есть ровно 144 × 800.
Ни одно из этих чисел не ошибочно. Просто «полоса коммутатора» считается по-разному, и, прежде чем сравнивать две сети суперкомпьютеров, нужно разобраться, как именно. Но даже правильно пересчитанное число скажет о сети меньше, чем кажется: в HPC-сети работает целая система из адаптеров, коммутаторов, топологии, программ и средств управления.
Для выбора сети нужны два сравнения: одинаково посчитанная полоса оборудования и время выполнения одной задачи. Между ними стоят сетевые адаптеры, маршруты, перегрузка и библиотеки, которыми пользуется программа.
Путь одного обмена
Суперкомпьютер решает одну задачу на тысячах узлов. Программы на них обмениваются данными через библиотеку MPI, Message Passing Interface, а при обучении нейросетей через библиотеки коллективных операций вроде NCCL. Если один узел ждёт данных от остальных, его быстрый процессор этот этап не ускорит.
Путь обмена выглядит так. Программа вызывает функцию библиотеки. Библиотека передаёт задание сетевому адаптеру узла. Адаптер отправляет данные в первый коммутатор, тот передаёт их дальше, и через несколько коммутаторов они попадают в адаптер получателя, а оттуда в его память. Над всем этим работают средства управления: они строят маршруты, следят за отказами и собирают телеметрию.
Совокупность этих соединений, коммутаторов и средств управления называют fabric. Как программа передаёт данные прямо в память соседа, подробно рассказано в статье о RDMA, RoCEv2 и Ultra Ethernet. Здесь нас интересует, кто прокладывает этот путь.
InfiniBand: своя архитектура
У InfiniBand собственные транспорт и управление сетью. Ассоциация InfiniBand Trade Association, IBTA, описывает его как архитектуру из коммутируемых каналов точка-точка со встроенными надёжными сообщениями и RDMA. Спецификация InfiniBand описывает собственный транспорт и собственное управление сетью. Адаптер узла называется HCA, host channel adapter.
У такого подхода сильная сторона в цельности: спецификация описывает и транспорт, и поведение коммутаторов, и управление. По подсчёту самой IBTA, в июньском списке TOP500 2026 года InfiniBand работает в 293 системах из пятисот. Это данные ассоциации, а не независимый подсчёт.
Спецификацию развивает IBTA, а оборудование выпускают производители, в том числе NVIDIA, на примере которой мы и будем разбирать железо. Поэтому полезно разделять, что записано в стандарте, а что относится к функциям конкретного производителя.
Три страницы, три потолка
Сколько сегодня даёт InfiniBand? Ответ зависит от того, какую страницу IBTA открыть.
Страница об InfiniBand, последний раз обновлённая в 2023 году, говорит о скоростях до 400 Гбит/с. Раздел вопросов и ответов о спецификации, обновлённый 21 сентября 2026 года, называет 800 Гбит/с. А сообщение IBTA от 31 июля 2026 года говорит о максимальной скорости соединения 1600 Гбит/с.
Разгадка в поколениях и ширине. Скорости InfiniBand обозначают буквами: NDR, затем XDR, затем GDR. XDR впервые описан в октябре 2023 года: 200 Гбит/с на линию и 800 Гбит/с на порт. В июле 2025 года вышла спецификация Release 2.0 с портами 800 Гбит/с в корпусе QSFP и 1,6 Тбит/с в QSFP-DD и OSFP. А Release 2.1 в июле 2026 года окончательно закрепил XDR с шириной соединения в 4 или 8 линий. Четыре линии по 200 дают 800, восемь дают 1600.
Отсюда поворот, который легко пропустить. 1,6 Тбит/с в InfiniBand уже есть, но это ещё не GDR. В дорожной карте IBTA GDR тоже обозначен как 1600G, но для порта из четырёх линий, то есть с вдвое более быстрыми линиями, и отнесён примерно к 2028 году. Следующий шаг, LDR, на том же графике обозначен как 3200G. Срок на дорожной карте обозначает план, а для выбора оборудования нужна спецификация конкретного изделия.
Как это выглядит в железе, показывает коммутатор NVIDIA Q3400. На нём 72 клетки OSFP, и в каждой по два порта XDR по 800 Гбит/с на четырёх линиях. Через одну клетку проходит 1,6 Тбит/с, но портов в ней два. Сетевой адаптер ConnectX-8 подключается к той же сети четырьмя линиями по 200 Гбит/с, а к своему серверу шиной PCIe Gen6 x16.
Slingshot: Ethernet с HPC-надстройкой
HPE Slingshot устроен иначе. Его порты говорят на стандартном Ethernet по IEEE 802.3ck и 802.3db, и к коммутатору Slingshot можно подключить сторонний Ethernet-адаптер или Ethernet-коммутатор без шлюза. Но поверх Ethernet HPE строит собственную систему.
В неё входят коммутационная микросхема на 64 порта по 400 Гбит/с, собственные адаптеры на микросхеме с двумя NIC-интерфейсами и подключением PCIe Gen5, кабели и программы управления Fabric Manager. На линиях между коммутаторами работают повтор на уровне канала и управление потоком на основе кредитов, и HPE помечает эти функции как возможности Ultra Ethernet. Часть функций на участке между адаптером и коммутатором, например расширенная устойчивость канала, работает только с адаптером HPE. Программы обращаются к сети через libfabric, Cray MPI, SHMEM и модули для NCCL и RCCL.
Получается, что сторонний Ethernet-адаптер в Slingshot работать будет, но как обычный Ethernet. Некоторые функции участка между адаптером и коммутатором, включая расширенную устойчивость канала, требуют HPE NIC. Сравнивать Slingshot с InfiniBand как «Ethernet против не-Ethernet» поэтому недостаточно: важны также адаптеры, функции сети и программный стек.
Разгадка двух чисел
Вернёмся к паспорту HPE. Коммутатор Slingshot 400 имеет 64 порта по 400 Гбит/с. В одну сторону они вместе передают 64 × 400 = 25 600 Гбит/с, то есть 25,6 Тбит/с. Но каждый порт одновременно и передаёт, и принимает. Если сложить оба направления, получится 51,2 Тбит/с, и обзор QuickSpecs так и пишет: bidirectional.
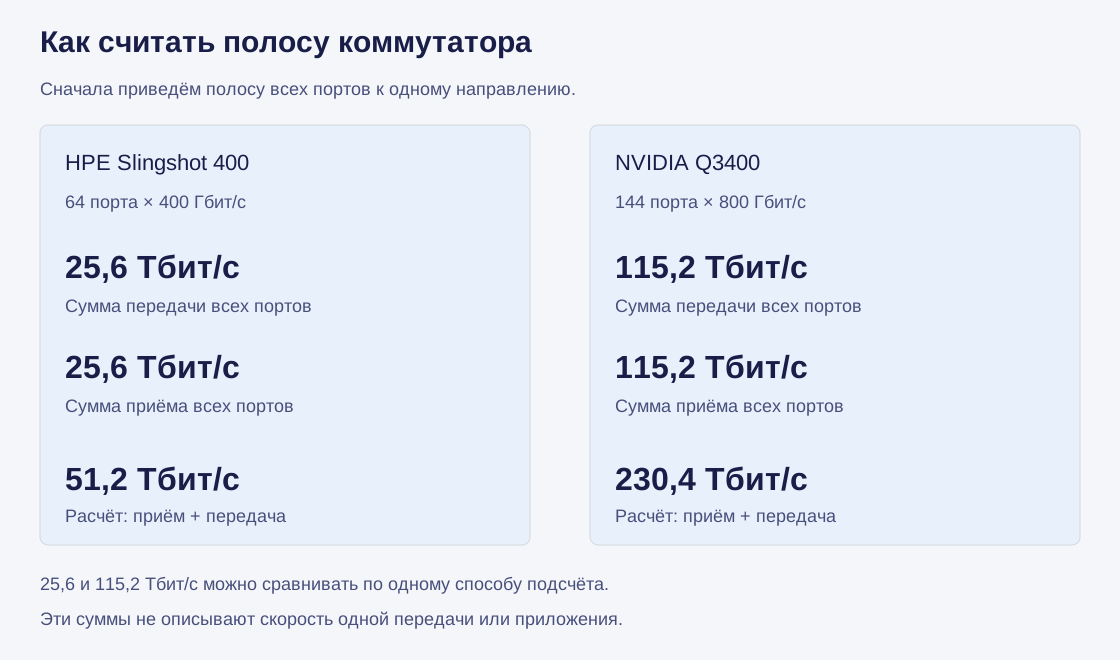
Открыть схему в полном размере
NVIDIA для Q3400 считает в одну сторону: 144 × 800 = 115 200 Гбит/с. Поэтому сравнивать 51,2 у HPE со 115,2 у NVIDIA нельзя, сначала их надо привести к одному способу счёта. Ни одно из этих чисел не описывает и полезную полосу приложения: это сумма возможностей всех портов микросхемы. Подробно о том, как приводить такие числа к общему знаменателю, рассказывает статья о сравнении полосы.
В том же паспорте есть загадка, которую документ не разгадывает. HPE обещает работу на полной скорости даже с самыми короткими пакетами в 64 байта: 781 миллион пакетов в секунду на порт и направление. Это ровно 400 миллиардов бит, делённые на 512 бит пакета. Но в стандартном Ethernet перед каждым кадром идёт преамбула, а после него межкадровый интервал, вместе ещё 20 байт. С ними предел для порта 400 Гбит/с составляет около 595 миллионов пакетов. NVIDIA, например, называет 148,81 миллиона полной скоростью для 100 Гбит/с, а 595 это ровно четыре таких числа. Для сравнения с обычным Ethernet нужно уточнить у HPE, какой формат пакета и какие накладные расходы входят в 781 млн пакетов/с. Упоминание оптимизированных HPC-форматов в QuickSpecs само по себе этого не объясняет.
Топология и функции сети
Коммутаторы можно соединить по-разному, и от этого зависит, сколько переходов пройдёт пакет и сколько путей у него будет. HPE строит Slingshot по топологии dragonfly: коммутаторы объединены в группы, каждая группа связана с каждой, и на минимальном маршруте между группами до трёх переходов между коммутаторами. По расчёту HPE, двухуровневая конфигурация вмещает 37 120 узлов. Классическая альтернатива называется fat tree, многоуровневое дерево, и HPE для двух уровней приводит 1024 узла.
Сеть умеет ещё и считать. NVIDIA в коммутаторах InfiniBand предлагает технологию SHARP: часть коллективной операции, например суммирование в all-reduce, выполняют сами коммутаторы, и по сети идёт меньше данных. Библиотека SHARP поддерживает Allreduce, Reduce, Broadcast, Allgather и другие операции для ряда типов данных. У Slingshot 400 тоже заявлена аппаратная разгрузка коллективных операций. Выигрыш от такой разгрузки зависит от версии, платформы и того, какие операции использует задача; универсального ускорения любой MPI-программы она не даёт.
Остальное относится к эксплуатации: как сеть обходит отказ, как справляется с перегрузкой, какую телеметрию выдаёт. Для кластера на тысячи узлов это не мелочи: отказ одного кабеля не должен останавливать задачу на всех.
Что сравнивать на самом деле
| Уровень | InfiniBand, пример NVIDIA XDR | HPE Slingshot 400 |
|---|---|---|
| Основа | Собственная архитектура InfiniBand | Ethernet по IEEE 802.3ck и 802.3db |
| Порт | 800 Гбит/с, четыре линии по 200 | 400 Гбит/с |
| Коммутатор | Q3400: 144 порта, 115,2 Тбит/с в одну сторону | 64 порта, 25,6 Тбит/с в одну сторону, 51,2 в обе |
| Адаптер | ConnectX-8, PCIe Gen6 x16 | Собственный NIC, PCIe Gen5 |
| Топология | Зависит от проекта кластера | Dragonfly, до трёх переходов |
| Вычисления в сети | SHARP | Аппаратная разгрузка коллективов |
| Программы | MPI, NCCL и другие библиотеки | libfabric, Cray MPI, SHMEM, NCCL и RCCL |
| Совместимость | Сеть InfiniBand | Сторонний Ethernet; часть расширений требует HPE NIC |
Вернуться к паспорту
51,2 и 25,6 в одном документе оказались одним числом, посчитанным двумя способами. 115,2 у NVIDIA тоже честное число, но в другом счёте. А 781 миллион пакетов остаётся вопросом к HPE. Все эти цифры описывают микросхему коммутатора. Для оценки времени конкретной задачи дополнительно нужны топология, профиль обмена и измерения.
Если выбирать сеть для кластера, сравнивать стоит так:
- Одна и та же реальная задача на обеих системах, с одинаковым числом узлов.
- Набор размеров сообщений и коллективных операций, которые она использует.
- Поддержка нужных библиотек и их версий.
- Поведение под нагрузкой: маршрутизация, перегрузка, хвостовые задержки.
- Масштаб домена и число переходов в выбранной топологии.
- Управление, телеметрия и обработка отказов.
- Доступность оборудования и совместимость с остальной инфраструктурой.
Проверку физических интерфейсов можно начать со статьи об Ethernet от витой пары до 1,6T, а различия сетевых транспортов разобраны в материале о RDMA, RoCEv2 и Ultra Ethernet.