PCIe 7.0 обещает 512 ГБ/с для слота x16. При копировании данных в одну сторону исходный предел вдвое ниже: 256 ГБ/с, ещё до заголовков и служебных полей. Одновременно шина должна быстро отвечать на короткие обращения процессора к устройству. Поэтому разработчики ограничивают потери полосы и добавку задержки.
В докладе о PCIe 7.0 член совета директоров PCI-SIG Дебендра Дас Шарма приводит цель: менее 10 нс дополнительной задержки передатчика и приёмника вместе относительно режима 32 GT/s, включая FEC. Это бюджет перехода к новой физике. Он не задаёт длительность каждой коррекции или повторной передачи.
Быстрые линии Ethernet и PCIe начиная с шестого поколения используют PAM4, четыре уровня напряжения, и нуждаются в коррекции ошибок. В докладе SNIA SDC 2023 сетевой вариант FEC с задержкой порядка 100 нс приведён как слишком дорогой для PCIe. При последовательности коротких зависимых обращений к устройству такая добавка повторяется на пути выполнения программы.
В строке «128 GT/s, x16» зашиты скорость линии и число параллельных линий. Служебные расходы, задержки и требования к кабелю приходится выяснять отдельно.
Строка из паспорта
PCIe 7.0 работает на скорости 128 GT/s на линию. GT/s означает гигатрансферы в секунду, и PCI-SIG называет так сырую скорость передачи битов по линии, raw bit rate, до любых служебных расходов.
Слот x16 содержит 16 линий. Посчитаем: 128 × 16 = 2048 Гбит/с, делим на 8 и получаем 256 ГБ/с. Это в одну сторону. Каждая линия PCIe состоит из двух пар проводников, одна передаёт, другая принимает, и обе работают одновременно. Поэтому PCI-SIG и пишет о 512 ГБ/с в обе стороны для x16.
Тут легко споткнуться. В сообщении PCI-SIG о PCIe 6.0 стояло «до 256 ГБ/с через x16» без указания направления. Для 64 GT/s это сумма обоих направлений, а в одну сторону выходит 128. Цифра 256 в двух поколениях означает разное. А на одном из слайдов CXL Consortium для того же PCIe 6.0 x16 стоит уже «512 GB/s raw», хотя белая книга того же консорциума пишет о 256 ГБ/с в сумме. Объяснения консорциум не даёт, и брать отсюда 512 не стоит. Подробнее о том, как не путать направления и уровни, рассказывает статья о сравнении полосы.
И ещё: 256 ГБ/с это сырой эквивалент, а не скорость копирования файла. Из него ещё вычтут служебные поля, заголовки транзакций и всё, что делают накопитель и программа.
Четыре уровня вместо двух
До PCIe 5.0 включительно сигнал был двухуровневым, NRZ: высокое напряжение означало единицу, низкое ноль. В PCIe 6.0 перешли на PAM4, четыре уровня. Каждый символ несёт два бита, и при той же частоте сигнала скорость удваивается. По слайду того же доклада, 64 GT/s в PAM4 используют ту же частоту Найквиста, что 32 GT/s в NRZ.
Отсюда важное правило: GT/s в PCIe 6.0 и новее уже учитывают PAM4. 64 GT/s соответствуют 32 гигабодам, двум битам на символ. Умножать 64 ещё раз на два из-за PAM4 не нужно.
У четырёх уровней есть цена. Расстояние между соседними уровнями втрое меньше, чем между двумя уровнями NRZ при том же размахе, и шум легче превращает один уровень в другой. Ошибок становится больше, и шине понадобилась коррекция.
FLIT: пакет фиксированного размера
Решение PCI-SIG состоит в том, чтобы передавать данные блоками фиксированного размера, FLIT. По докладу Дас Шармы блок занимает 256 байт и делится так: 236 байт на транзакции, 6 байт на канальный уровень, 8 байт на контрольную сумму CRC и 6 байт на коррекцию ошибок FEC.
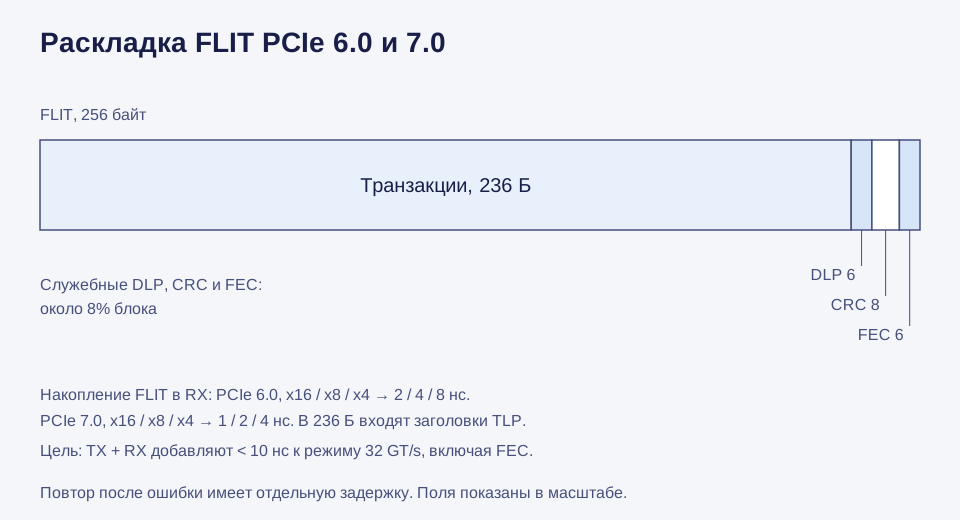
Открыть схему в полном размере
FLIT занимает 256 байт. Время его накопления зависит от поколения и ширины линка: для PCIe 6.0 x16 это 2 нс, для PCIe 7.0 x16 уже 1 нс.
Шесть байт FEC обеспечивают лёгкую коррекцию: она исправляет ограниченный набор ошибок с небольшой задержкой. Если после коррекции проверка CRC обнаруживает повреждение, FLIT передаётся повторно. Для модели PCIe 6.0 в докладе получена вероятность повтора 5 × 10⁻⁶, примерно один блок из 200 тысяч; это расчёт при заданных характеристиках ошибок, а не постоянная для любого канала. На слайде 10 автор сравнивает редкий повтор с задержкой порядка 100 нс и тяжёлую FEC, которая добавляла бы столько же к каждому обмену. Целевая задержка самих FEC и CRC на слайде 14 составляет около 1-2 нс.
Накопление полного блока в приёмнике тоже требует времени. У передатчика обработка конвейерная; ждать сборки FLIT на обоих концах не нужно. Числа 2/4/8 нс для x16/x8/x4 на слайде 11 относятся к 64 GT/s, то есть PCIe 6.0. При 128 GT/s время вдвое меньше:
| Ширина линка | PCIe 6.0, 64 GT/s | PCIe 7.0, 128 GT/s |
|---|---|---|
| x16 | 2 нс | 1 нс |
| x8 | 4 нс | 2 нс |
| x4 | 8 нс | 4 нс |
Это можно проверить без сложной модели. FLIT содержит 256 × 8 = 2048 бит. Линк PCIe 7.0 x16 переносит 128 × 16 = 2048 бит за наносекунду, поэтому на блок нужна 1 нс. Для x4 получается 2048 / (128 × 4) = 4 нс. Расчёт описывает передачу блока по работающему линку; очередь запросов и обработка устройством добавляют своё время.
У фиксированного блока есть и второе преимущество. В прежних поколениях каждый пакет транзакции нёс собственную рамку и собственную контрольную сумму, и при мелких пакетах эти добавки съедали заметную часть линии. В FLIT нет ни синхронизирующего заголовка, ни отдельной рамки, ни CRC на каждую транзакцию: одна проверка покрывает весь блок. В модели ошибок FBER, First Bit Error Rate, задаёт вероятность первичной битовой ошибки на приёмнике. Она может породить пачку последующих ошибок из-за обратной связи эквалайзера DFE; учитывается и корреляция между линиями. Слово first здесь относится к исходной ошибке, а не к первому по порядку биту FLIT. В докладе расчёт построен для FBER 10⁻⁶.
Служебные поля CRC, канального уровня и FEC занимают около 8% блока. Но и 236 байт нельзя считать чистыми данными приложения: в них лежат транзакции PCIe вместе с их заголовками. Поэтому делить 236 на 256 и называть результат полезной долей неправильно.
Три поколения
PCI-SIG удваивает скорость линии примерно раз в три года. Статус последних поколений на 4 октября 2026 года:
| Поколение | На линию | x16 в одну сторону | x16 в обе стороны | Статус |
|---|---|---|---|---|
| PCIe 6.0 | 64 GT/s | 128 ГБ/с | 256 ГБ/с | Опубликована 11.01.2022 |
| PCIe 7.0 | 128 GT/s | 256 ГБ/с | 512 ГБ/с | Опубликована в июне 2025 |
| PCIe 8.0 | 256 GT/s | 512 ГБ/с | около 1 ТБ/с | Черновик 0.5 от 06.05.2026, выпуск к 2028 |
Значения в таблице получаются умножением скорости линии на 16 и переводом битов в байты; служебные расходы ещё не вычтены. Для PCIe 8.0 PCI-SIG формулирует цель как «до 1 ТБ/с в обе стороны» через x16. Черновик 0.5 вышел для участников консорциума раньше графика, после черновика 0.3 в сентябре 2025 года. Восьмое поколение, по сообщению The Register, сохраняет и PAM4, и FLIT. Среди целей восьмого поколения PCI-SIG называет и оценку новых технологий разъёмов. Президент консорциума Ал Йейнс в интервью Gazettabyte говорил, что 256 GT/s по меди, по его оценке, достижимы.
При выборе компонентов полезно различать спецификацию, IP-блок для проектирования чипа и готовое изделие. Credo в октябре 2024 года объявила ретаймер для PCIe 7 и план образцов во втором полугодии 2025. Сам анонс не подтверждает выполнение этого срока. Rambus предлагает коммутатор PCIe 7.0 как IP-блок для интеграции в чужие микросхемы. Для закупки нужны отдельные сведения о готовом компоненте, его доступности и проверке совместимости.
Когда дорожки платы не хватает
Сигнал PCIe проходит длинный путь: из корпуса процессора по дорожкам материнской платы к разъёму, через разъём на плату устройства и в его микросхему. На каждом участке он теряет мощность, отражается от неоднородностей и ловит помехи от соседних линий. При росте частоты потери того же пути возрастают, а его допустимый бюджет задаёт конкретное поколение интерфейса. Переход на PAM4 увеличивает скорость без пропорционального роста частоты символов, но усложняет различение уровней.
Когда бюджета не хватает, ставят ретаймер, микросхему, которая принимает сигнал, восстанавливает его и передаёт дальше как новый. Например, CXL 4.0, работающая поверх физики PCIe 7.0, разрешает до четырёх ретаймеров на линии. Другой путь: увести сигнал с платы на кабель. Кабель над платой, fly-over, теряет меньше, чем дорожка в стеклотекстолите, но требования к потерям, отражениям и помехам по-прежнему относятся ко всему пути от передатчика до приёмника. Кабель не отменяет физику канала, и дальность нельзя вывести из одной скорости.
PCI-SIG также описывает оптическое продолжение канала через Optical Aware Retimer. Публичная карточка изменения датирована 11 июня 2025 года и указывает затрагиваемый документ PCIe Base Spec 6.3. В презентации президента PCI-SIG на FMS 2025, слайд 8, выпуск Optical Aware Retimer указан для PCIe 6.4 и 7.0. У карточки ECN и презентации разные поля и контекст: затрагиваемая базовая спецификация и ревизии, для которых объявлен выпуск. Открытое описание говорит о ретаймере, часть которого использует оптическую технологию, без привязки к конкретному виду оптики. Для готового кабеля всё равно потребуются спецификация изделия и поддержка обоих концов соединения.
CopprLink: линии на кабеле
Для таких кабелей PCI-SIG в мае 2024 года выпустила спецификации CopprLink. Их две. Внутренний CopprLink рассчитан на 32 и 64 GT/s, то есть PCIe 5.0 и 6.0, использует разъёмы SFF-TA-1016 и обещает до 1 метра внутри одной системы. Внешний CopprLink работает на тех же скоростях с разъёмами SFF-TA-1032 и обещает до 2 метров между стойками.
Это заявленные максимумы, а не гарантия для любого кабеля любой длины. Конкретный кабель, разъём, ретаймеры и устройства проверяют по их характеристикам. Поддержка 128 GT/s для CopprLink, по сообщению о PCIe 8.0, пока только планируется, как и 256 GT/s. Статус планируемой поддержки нельзя переносить на продаваемый кабель для PCIe 5.0 или 6.0.
Практическое применение внешних линий PCIe, от внешних видеокарт до OCuLink, подробно разобрано в статье о внешней GPU и OCuLink.
Проверка канала
Строка «128 GT/s, x16» описывает максимальный режим интерфейса. Реальное соединение может согласовать меньшую ширину или скорость. Например, PCIe 7.0 x8 и PCIe 6.0 x16 дают одинаковый сырой предел 128 ГБ/с в одну сторону, хотя поколения и число линий различаются. По одному размеру разъёма их производительность не определить.
Перед тем как рассчитывать на скорость нового поколения, стоит проверить:
- Поколение и число линий у корневого порта процессора и у конечного устройства.
- Какую скорость и ширину они на самом деле согласовали: слот x16 не гарантирует 16 работающих линий.
- Путь сигнала: дорожки платы, разъёмы, кабель и его спецификацию.
- Ретаймеры на пути и их поддержку нужного поколения.
- Прошивки платформы и устройства.
- Счётчики ошибок и повторов под нагрузкой: их рост требует проверки целостности сигнала и журнала ошибок, а не одного теста скорости.
- Программную поддержку, включая горячее подключение, если устройство внешнее: его должна поддерживать конкретная платформа.
На физической основе PCIe работает и CXL, который добавляет к шине доступ к памяти. Об этом рассказывает статья о CXL.