18 ноября 2025 года консорциум CXL выпустил спецификацию CXL 4.0. Почти через год после этого, 4 октября 2026 года, список совместимых изделий того же консорциума содержал 64 записи. Тридцать относились к CXL 1.1, тридцать четыре к CXL 2.0. Ни одной записи для версий 3.x или 4.0.
Каталог отражает участие изделий в программе совместимости. Он не охватывает весь рынок, не подтверждает продажи и не гарантирует производительность: об этом прямо предупреждает консорциум. Однако различие версий полезно для покупателя. Расширение памяти одного сервера, распределение ёмкости между серверами и одновременная работа с общим участком требуют разных возможностей оборудования и программ.
Сервер может получить дополнительные сотни гигабайт по CXL и всё же не уметь делить их с соседним сервером. Номер версии на модуле сам по себе этого вопроса не решает: участвуют также корневой порт процессора, коммутатор, прошивка и операционная система.
Зачем памяти шина
Обычная память стоит в слотах DIMM рядом с процессором, и её количество ограничено числом каналов и слотов. Добавить каналы дорого: каждому нужны контакты на корпусе процессора. Слайды вебинара консорциума показывают это на числах: канал DDR5-6400 даёт 50 ГБ/с примерно на 200 сигнальных контактах, а слот PCIe 6.0 x16 обходится 64 сигнальными контактами.
Идея CXL в том, чтобы пустить обращения к памяти по тем же линиям, что и PCIe. Физика и разъёмы остаются от PCIe, а поверх них появляются новые протоколы. Подробно о линиях PCIe, их скорости и FLIT рассказывает статья о PCIe 6/7/8.
Путь к памяти CXL включает последовательный линк и контроллер устройства, что добавляет задержку. Ещё в 2020 году консорциум ориентировался на 50 наносекунд дополнительной задержки, а на слайдах 2025 года целью для обращений через CXL.cache и CXL.mem названо меньше 200 наносекунд от запроса до использования данных. Это разные метрики, добавка и полная задержка, и сравнивать их напрямую нельзя.
Три протокола в одной линии
CXL состоит из трёх протоколов. Документация ядра Linux описывает их так.
CXL.io отвечает за обнаружение устройства, настройку, прерывания и обычный ввод-вывод. По сути это PCIe, и он обязателен для любого устройства CXL.
CXL.cache позволяет устройству когерентно обращаться к памяти хоста и кэшировать её. Направление здесь от устройства к процессору: ускоритель читает память сервера и держит копию у себя, а протокол следит, чтобы копия не устарела.
CXL.mem работает в обратную сторону: процессор когерентно обращается к памяти, которая стоит на устройстве. Для программы такая память выглядит как ещё один участок адресного пространства.
Из сочетаний этих протоколов складываются три типа устройств.
| Тип | Протоколы | Что это | Пример |
|---|---|---|---|
| Type 1 | io + cache | Устройство без своей памяти для хоста | Сетевая карта с атомарными операциями |
| Type 2 | io + cache + mem | Ускоритель со своей памятью | GPU, FPGA |
| Type 3 | io + mem | Расширитель памяти | Модуль памяти CXL |
Эти сочетания протоколов описаны в слайдах консорциума и документации ядра. В каталоге совместимости 54 из 64 записей помечены Type 3. Это распределение записей каталога по типам, а не доля проданных модулей; запись также может описывать контроллер или другое изделие, а не готовую плату памяти.
Расширение, пул и общая память
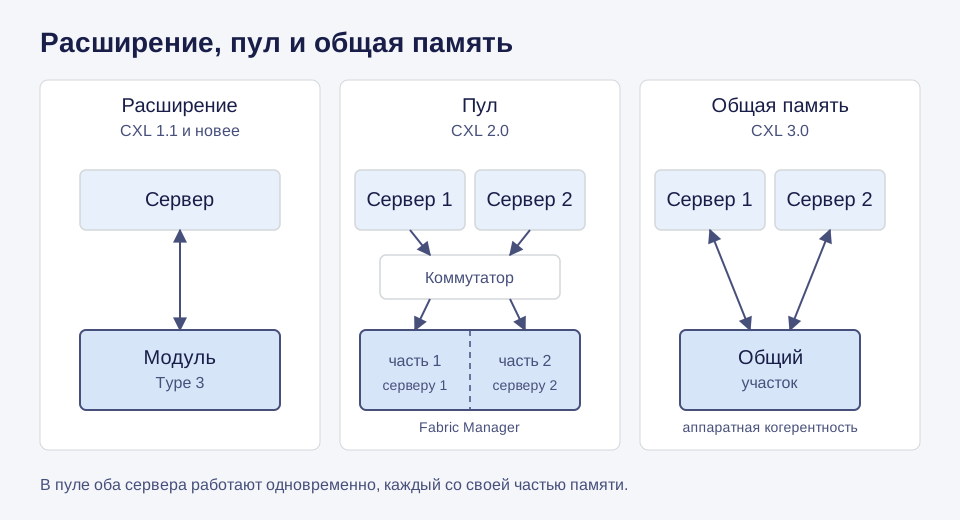
Расширение, пул и общая память различаются тем, кому доступна ёмкость и кто может обращаться к одному участку одновременно.
Расширение памяти самое простое. Модуль Type 3 подключён к одному серверу и добавляет ему ёмкость или полосу. Это возможно уже в CXL 1.1.
Пул памяти появился в CXL 2.0 вместе с коммутатором. Ёмкость одного или нескольких устройств делится на части, и каждая часть в любой момент принадлежит одному серверу. По белой книге консорциума, память можно гибко выделять разным серверам и забирать обратно. Распределением управляет Fabric Manager, менеджер фабрики. По разъяснениям консорциума, он может работать на отдельном контроллере управления, на любом из хостов или на процессоре коммутатора. Если менеджер откажет, коммутатор продолжит работать, перестанут выполняться только операции, которым нужен менеджер. При передаче памяти от одного сервера другому она не обнуляется сама: очистить её может хост до отключения или менеджер после.
Открыть схему в полном размере
В пуле серверы одновременно работают со своими выделенными частями. Владельца конкретной части можно сменить. Общая память даёт нескольким серверам одновременный доступ к одному участку.
Например, из условного пула на 1 ТиБ менеджер выделяет серверу А 256 ГиБ, серверу Б ещё 256 ГиБ, а 512 ГиБ оставляет свободными. Оба сервера работают параллельно. Чтобы передать часть А серверу Б, сначала нужно освободить её на А и выполнить процедуры переназначения. Учитывать необходимо и данные в этой памяти: работающая программа не может без подготовки потерять свои страницы. Такой пул помогает перераспределять ёмкость между задачами, но не делает один и тот же массив общим для двух приложений.
Общая память появилась только в CXL 3.0. Здесь один и тот же участок одновременно доступен нескольким серверам, и когерентность между ними поддерживает аппаратура. В той же версии появились фабрики до 4096 узлов с маршрутизацией по портам и устройства с динамической ёмкостью, DCD, у которых выделенный объём можно менять на ходу.
В описании Xeon 6 Intel использует слово sharing для процессора с CXL 2.0. У консорциума аппаратно когерентный доступ нескольких хостов к одному участку относится к CXL 3.0. Поэтому в спецификации сервера нужно искать конкретный режим доступа: одно слово sharing в рекламе его не определяет.
Лестница версий
По слайдам консорциума, версии выходили так: 1.0 в марте 2019, 1.1 в сентябре 2019, 2.0 в ноябре 2020, 3.0 в августе 2022, 3.1 в ноябре 2023, 3.2 в декабре 2024 и 4.0 в ноябре 2025 года. Изделия стоят на разных ступенях.
| Что | Версия CXL | Источник |
|---|---|---|
| Спецификация | 4.0 | Консорциум, 18.11.2025 |
| Модуль Samsung CMM-D MD310 | 3.2 | Samsung |
| AMD EPYC 9006 | 3.1 | AMD |
| AMD EPYC 9005 | 2.0 | AMD |
| Intel Xeon 6 | 2.0, до 64 линий, до 32 GT/s | Intel |
| Список совместимых изделий | 1.1 и 2.0 | Консорциум |
Samsung представляет модуль MD310 с CXL 3.2, PCIe 6.0 и ёмкостью 256 ГБ. При этом FAQ той же страницы сообщает, что версии новее CXL 2.0 ещё не полностью коммерциализированы. Страница не объясняет, как эта общая оговорка соотносится с MD310, и не подтверждает фактические продажи модуля. Срок поставки и поддерживаемую конфигурацию следует уточнять у поставщика.
Скорость MD310 Samsung указывает как «до 72 ГБ/с» со сноской о внутренних лабораторных испытаниях. Ни направление, ни ширина линка, ни условия замера не раскрыты, так что сравнивать это число с полосой канала DDR5 нельзя. А числа 6,4 и 7,2 Гбит/с в карточках модулей относятся к микросхемам DRAM внутри, а не к линии CXL.
Для платформы EPYC 9006 SP7 компания GIGABYTE прямо заявляет CXL 3.1 с multi-host memory sharing и P2P через фабрику. Это описание возможностей платформы; для конкретного сервера нужны перечень поддерживаемых устройств, версия прошивки и программный стек. Поддержку DCD из этих слов вывести нельзя. Анонсы компонентов иногда опережают сам стандарт: Credo объявила ретаймер для «CXL 4.x» 14 октября 2024 года, за 13 месяцев до выхода CXL 4.0.
Что принесла версия 4.0
CXL 4.0 переходит на физику PCIe 7.0: 128 GT/s на линию, сигнал PAM4, блоки FLIT по 256 байт. По сообщению консорциума, версия добавляет собственный режим x2, до четырёх ретаймеров на линии, объединение портов и новые функции надёжности памяти, и при этом совместима с 3.x, 2.0, 1.1 и 1.0.
Bundled ports логически объединяют несколько портов ускорителя. На слайде 16 вебинара CXL 4.0 перечислены устройства Type 1, Type 2 и ускорители Type 3. Обычные расширители памяти Type 3 тоже могут получать полосу нескольких линков через чередование обращений, но это отдельный механизм.
По ответам консорциума, при перечислении устройств система видит несколько конечных устройств, endpoints. Драйвер управляет ими совместно и представляет приложению один ускоритель. Каждый порт сохраняет независимый линк и собственные FLIT: один блок между портами не делится. Для использования bundling нужен драйвер, который знает об объединении.
Обещание 128 GT/s «без добавочной задержки» в слайдах связано с дополнительным, оптимизированным по задержке форматом FLIT. На слайде 15 выигрыш 2-5 нс указан для линков от x16 до x4; эффективность линии меняется с 0,94 до 0,92. FIT при этом возрастает с 5 × 10⁻⁸ до 0,026. В ответе Q5 консорциум уточняет, что эти значения FIT относятся к линку x16 и означают число отказов на миллиард часов работы линка. Это расчётная частота отказов соединения, а не вероятность отказа сервера или процент повреждённых запросов. Консорциум считает значение меньше единицы приемлемым для этого сравнения. Выбор режима требует оценить и задержку, и надёжность, и потерю полосы.
Что видит Linux
В карте зрелости подсистемы CXL, проверенной 4 октября 2026 года для документации Linux 7.3.0-rc5, статус каждой функции отмечен цифрой. Ноль означает известный пробел с реализацией в средней или долгой перспективе. Оценка относится к указанному состоянию подсистемы и может меняться между выпусками ядра.
Нулём отмечены поддержка DCD, аппаратно когерентная общая память, обнаружение памяти ускорителей Type 2, CXL.cache и фабрики. Среди функций обслуживания памяти такой же статус имеют PPR, ремонт после корпусирования, и sparing, замещение резервными ресурсами. Горячее подключение логических устройств имеет оценку 1: начальная реализация с возможными существенными пробелами.
Samsung описывает возможность динамического распределения памяти MD310 между хостами. Чтобы использовать такой сценарий, нужно выяснить, на каком стеке он работает и какие функции требует. Карта Linux оценивает основную подсистему ядра; экспериментальные патчи, программные комплексы поставщиков и отдельные реализации могут иметь другой набор возможностей.
Перед покупкой
Запись в списке совместимости полезна для подбора компонентов, но не подтверждает все функции соответствующей версии и не заменяет испытание выбранной конфигурации. Особенно это касается пула: нужны совместимые хосты, коммутатор, менеджер фабрики и процедуры безопасного изменения доступной памяти.
Intel предлагает на Xeon 6 режим Flat Memory, в котором процессор сам распределяет данные между обычной памятью и памятью CXL, а в описании Xeon 6 прямо упоминает недорогую память вроде DDR4 через CXL 2.0. AMD тоже пишет о возможном повторном использовании старых модулей DIMM. Допустим, рабочий набор задачи вырос с 400 до 600 ГиБ, а локально установлено 512 ГиБ. Устройство CXL с дополнительными 256 ГиБ даст суммарно 768 ГиБ и позволит разместить такой набор в памяти, если платформа поддерживает эту конфигурацию. Но этот расчёт ёмкости ничего не говорит о времени выполнения. Нужно сравнить задержку, пропускную способность и размещение часто используемых данных, особенно при случайных обращениях. Для проверки полезны и скорость самой задачи, и её пиковое потребление памяти.
Перед тем как рассчитывать на CXL, нужно проверить:
- Версию CXL у корневого порта процессора и у устройства, а также тип устройства.
- Прошивку платформы: BIOS, таблицы ACPI, описывающие память CXL.
- Версию ядра и драйвера и статус нужной функции в карте зрелости.
- Топологию: прямое подключение, коммутатор, менеджер фабрики.
- Что именно нужно: расширение, пул или общая память.
- Задержку и полосу на своей нагрузке, с учётом размещения памяти по узлам NUMA.
При сравнении полосы отдельно учитывают направление передачи, служебные расходы и условия измерения. Подробный разбор единиц и таких сравнений есть в статье о сравнении полосы.