В документации Google о TPU7x, ускорителе поколения Ironwood, в одной таблице рядом стоят две строки. Межчиповое соединение ICI: 1200 GBps на чип. Сеть дата-центра DCN: 100 Gbps на чип. Буквы почти одинаковые, но в первой строке B заглавная, и это байты, а во второй строчная, и это биты.
После перевода 1200 ГБ/с в 9600 Гбит/с арифметическое отношение равно 96. Однако первая строка прямо обозначает сумму полосы обоих направлений, а у DCN направление в таблице не уточнено. Эти 96 не являются отношением сопоставимых односторонних полос и тем более не предсказывают ускорение приложения. ICI обслуживает обмены ускорителей внутри пода, DCN связывает его с остальной инфраструктурой.
При аренде ускорителей выбирают и границу быстрой связи: какие чипы смогут часто обмениваться данными внутри одного домена, а каким придётся использовать внешнюю сеть. Google строит такой домен из трёхмерных кубов, соединённых оптикой. AWS в Trainium3 перешла от тора к коммутируемой фабрике. Разница становится заметной, когда модель приходится делить между серверами.
Облако продаёт топологию
Большую модель делят между многими ускорителями, а на каждом шаге они обмениваются результатами через коллективные операции. Чем чаще и крупнее обмены, тем важнее, как именно связаны чипы: напрямую, через коммутатор или через несколько промежуточных узлов. Подробно об этих обменах рассказано в статье о NVLink и Infinity Fabric.
В собственном дата-центре топологию проектирует владелец. В облаке её проектирует провайдер, а клиент выбирает из готовых вариантов: у Google это слайсы, кусочки пода определённой формы, у AWS серверы и UltraServer. Число чипов задаёт объём вычислительных ресурсов, а связность определяет, насколько дорого им обходится совместная работа.
Две сети TPU
У TPU7x две сети. ICI, inter-chip interconnect, соединяет чипы внутри пода, и под может включать до 9216 чипов. DCN, сеть дата-центра, связывает поды и слайсы между собой и с остальной инфраструктурой. Есть и третья дорога, к хост-машине, на которой работает программа.
Внутри пода чипы образуют трёхмерный тор. Каждый чип соединён с соседями по трём осям, а крайние чипы каждой оси замкнуты друг на друга, так что у решётки нет краёв. Слайсы больше 64 чипов собираются из кубов 4 × 4 × 4. Та же страница даёт и полосу на одну ось внутри пода: 200 ГБ/с в обе стороны. Это ещё одно число того же уровня, и его нельзя путать с 1200 ГБ/с на чип.
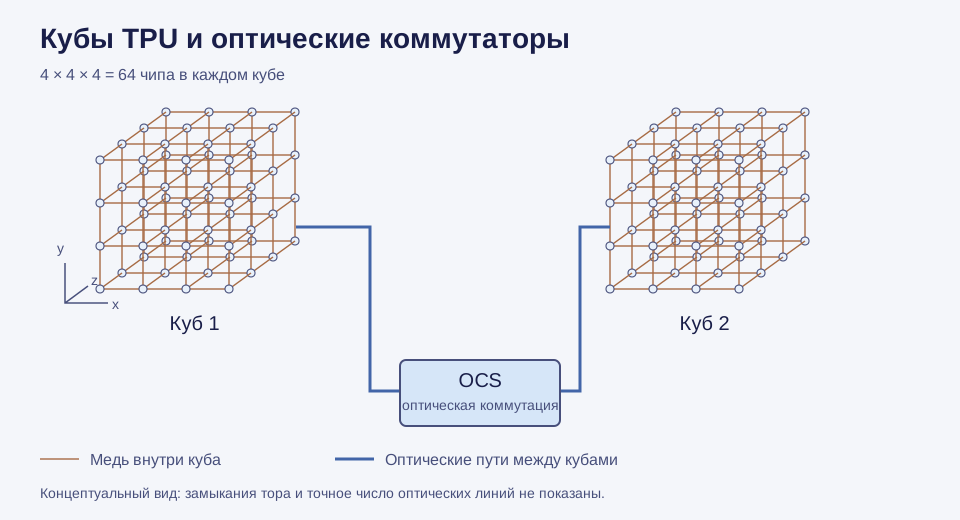
Открыть схему в полном размере
Куб содержит 64 чипа, по четыре вдоль каждой оси. Медные связи внутри куба и оптические пути через OCS показаны разными цветами. Это концептуальный вид: замыкания тора и число оптических линий не изображены.
Медь в кубе, свет между кубами
Самая необычная деталь сети TPU описана в разделе об устойчивости ICI. Связи внутри куба медные. Связи между кубами идут через оптические коммутаторы, OCS, optical circuit switches.
Оптический коммутатор здесь не похож на сетевой. Он не читает пакеты и не решает, куда отправить каждый из них. Он соединяет оптические пути, как переключатель на старой телефонной станции соединял провода: свет из одного волокна направляется в другое. Так из кубов можно собирать слайсы нужной формы и перестраивать соединения без замены кабелей.
Отсюда и способ справляться с отказами. Если выходит из строя оптическая линия или сам коммутатор, сеть обходит отказ, и для слайсов от одного куба и больше это включено по умолчанию. Цена обхода, по документации Google, временное снижение полосы ICI. Медные связи внутри куба отказами OCS не затрагиваются.
OCS меняет соединения между кубами. Полоса каждой линии при этом остаётся прежней, а обмен между произвольными чипами по-прежнему зависит от пути через топологию.
TPU7x Google представила в ноябре 2025 года, по заметкам о выпусках предварительный доступ открылся 24 ноября 2025 года, а общая доступность 31 марта 2026 года. В каких регионах и в каких формах слайсов ресурс доступен сейчас, нужно проверять на дату заказа.
AWS: от тора к коммутатору
AWS прошла другой путь. В предыдущем поколении, Trainium2, 16 чипов одного сервера были соединены двумерным тором 4 × 4 через NeuronLink-v3, а четыре сервера складывались в UltraServer на 64 чипа.
В Trainium3 документация прямо говорит, что топология «все со всеми» через коммутаторы NeuronSwitch-v1 пришла на смену прежнему двумерному тору. Поколений UltraServer два. Gen1 состоит из четырёх серверов по 16 чипов, всего 64. Gen2 из 36 серверов по 4 чипа, всего 144: внутри сервера работает коммутатор первого уровня, а между серверами два коммутатора второго уровня. Запись «4 × 16» и «36 × 4» здесь означает число серверов и чипов в сервере, а не координаты решётки.
Google сохраняет тор и перестраивает его оптикой, AWS использует коммутируемую фабрику. Заявленная связность «все со всеми» при этом не гарантирует, что каждая пара чипов получит полную полосу одновременно: это зависит от маршрутизации и нагрузки.
Как читать полосу NeuronLink
Для NeuronLink-v4 на странице продукта AWS указывает 2 ТБ/с на чип. Описание архитектуры Trainium3 в Neuron SDK 2.32.0 даёт 2,56 ТБ/с на устройство, и в таблице того же документа 2560 ГБ/с на чип, вдвое больше, чем 1280 у Trainium2. В таблице характеристик UltraServer стоит третье число, 2048 GiB/s на устройство, причём одинаковое для Gen1 на 64 чипа и для Gen2 на 144.
2048 GiB/s не равны 2048 ГБ/с. Двоичный гибибайт больше десятичного гигабайта, и в десятичных единицах выходит около 2199 ГБ/с. Это не совпадает ни с 2000, ни с 2560.
| Источник AWS | Число | Единица и объект |
|---|---|---|
| Страница продукта Trn3 | 2 | ТБ/с на чип, направление не указано |
| Архитектура Trainium3, SDK 2.32.0 | 2,56 | ТБ/с на устройство |
| Таблица UltraServer, SDK 2.32.0 | 2048 | GiB/s на устройство, Gen1 и Gen2 |
Эти три значения расходятся даже после приведения к десятичным единицам. Документы не объясняют разницу между ними, поэтому выбирать одно число как точную полосу для расчёта времени обмена преждевременно. Нужны уточнение для заказанной конфигурации и замер коллективной операции.
В разделах о связности Trn3 AWS отдельно описывает PCIe-фабрику и её области: 256 ГБ/с в обе стороны внутри сервера, 320 ГБ/с между серверами стойки и 128 ГБ/с между стойками. Это характеристики разных соединений. Их арифметическая сумма 704 ГБ/с не является четвёртым опубликованным значением общей полосы NeuronLink и не задаёт скорость одного сквозного пути. Один обмен может зависеть от нескольких участков и их загрузки. В том же описании значения привязаны к четырём, пяти и двум соединениям PCIe Gen6 x8; соотношение этих номиналов с полосой NeuronLink документ не поясняет.
Единицы расходятся и для памяти Gen2: таблица архитектуры даёт 20 736 GiB, страница продукта 20,7 TB. При буквальном переводе 20 736 GiB получается около 22,27 ТБ; записи не эквивалентны. Причина различия в документах не объяснена. Полоса HBM, 705,6 ТБ/с в таблице и 706 ТБ/с на продуктовой странице, относится к памяти всех 144 чипов, а не к NeuronLink. Общий объём памяти также не означает, что каждый чип обращается к любому её участку с локальной скоростью.
Что получает приложение
Размер домена определяет, сколько ускорителей можно объединить быстрой связью. Полосу внешней сети необходимо читать с её знаменателем: у Google она дана на чип, у AWS на UltraServer. Сравнивать сами числа без учёта этого различия нельзя.
| Параметр | Google TPU7x | AWS Trn3 Gen1 | AWS Trn3 Gen2 |
|---|---|---|---|
| Чипов в домене | до 9216 в поде | 64 | 144 |
| Связь между чипами | ICI 1200 GBps на чип, в обе стороны | NeuronLink-v4, три значения в документах | NeuronLink-v4, три значения в документах |
| Топология | 3D-тор, кубы 4 × 4 × 4, OCS между кубами | 4 сервера по 16 чипов, NeuronSwitch-v1 | 36 серверов по 4 чипа, два уровня NeuronSwitch-v1 |
| Внешняя сеть | DCN 100 Gbps на чип | EFA 12 800 Гбит/с на UltraServer | EFA 28 800 Гбит/с на UltraServer |
| Документ | Cloud TPU, обновлено 02.10.2026 | Neuron SDK 2.32.0 | Neuron SDK 2.32.0 |
Даже правильно прочитанная таблица не говорит, как быстро будет работать задача. Между железом и результатом стоят компилятор и среда исполнения, реализация коллективных операций, то, как модель разложена по топологии, где лежат данные и сколько памяти у каждого чипа. Ускорения, которые публикуют провайдеры, это их собственные испытания с их условиями; переносить их на свою задачу можно только после своего замера.
Два расчёта перед масштабированием
Предположим, задача занимает 128 чипов TPU7x. Форма 4 × 4 × 8 из списка поддерживаемых конфигураций содержит два куба по 64 чипа. У такого размещения есть определённые соседи по каждой оси. Если две часто взаимодействующие части модели распределить без учёта этих соседств, их обмены могут занять общие участки сети. Простое удвоение числа чипов с 64 до 128 не обещает удвоения скорости: часть выигрыша уйдёт на изменившиеся коммуникации.
Для мысленного эксперимента разделим время одного шага на две неперекрывающиеся части: 80 мс вычислений и 20 мс обменов. Если удвоение ресурсов сократит вычисления ровно вдвое, а обмены останутся прежними, получится 40 + 20 = 60 мс. Ускорение составит 100 / 60 ≈ 1,67 раза. Если при новом размещении обмены займут 40 мс, шаг сократится только до 80 мс, то есть в 1,25 раза. Это условный расчёт, а не результат теста TPU: он показывает, какую величину нужно искать в профиле собственной задачи. В реальном запуске вычисления и передачи могут перекрываться, поэтому суммировать их длительности без анализа временной шкалы нельзя.
Второй расчёт касается выхода из домена. Передача 1 ГБ через условный односторонний канал 100 Гбит/с занимает минимум 1 × 8 / 100 = 0,08 секунды, или 80 мс. Это предел сериализации без служебных данных, очередей и задержки пути. Применять его к строке DCN можно только после уточнения направления и доступной приложению доли полосы. Если одновременно отправляют данные несколько процессов, делить объём каждого на полную паспортную скорость канала уже неверно.
Такую передачу часто вызывает вполне практическое решение: вынести часть модели или её данные за пределы исходного домена. При редких крупных обменах задержку иногда удаётся скрыть вычислениями. При частой синхронизации даже небольшой объём может задерживать весь шаг, потому что следующие вычисления ждут результат. Поэтому перед масштабированием полезно измерить отдельно загрузку данных, коллективные операции и сохранение контрольных точек. Все они пересылают байты, но используют разные пути и возникают с разной частотой.
Для Trainium действует тот же способ проверки: сначала замер внутри выбранного UltraServer, затем за его пределами. Сравнение сохраняет модель, точность вычислений, размер пакета данных и программный стек. Если эти параметры поменялись одновременно с топологией, приписать ускорение одной NeuronLink уже нельзя. Итоговый показатель для заказа ресурса обычно выражается в завершённых шагах или обработанных запросах за оплаченный час, а не в сумме паспортных скоростей портов.
Перед заказом
У Google ICI обслуживает обмены внутри пода, DCN выводит данные за его пределы. Задача, которая помещается в один слайс, обменивается данными в основном по первой сети. Задаче, которую пришлось разложить на несколько подов, придётся пользоваться и второй. Поэтому выбор облачного ресурса начинается с вопроса, какую часть обменов удастся удержать внутри домена.
Перед заказом стоит записать:
- Тип ресурса и поколение чипа.
- Регион и доступность на дату заказа.
- Размер и форму слайса или UltraServer, то есть домен быстрой связи.
- Версию программного стека: компилятора, среды исполнения, библиотек коллективных операций.
- Путь входных данных: откуда читаются данные и с какой скоростью.
- Замер на своей задаче: время шага, загрузку чипов, долю времени на обмены.
- Стоимость по действующему тарифу.
Доступность нужного размера домена, квоты и действующий тариф проверяют для конкретного региона на дату заказа. Как сравнивать числа с разными единицами и объектами, подробно объясняет статья о сравнении полосы.