В документации NVIDIA о RoCE сказано, что RDMA передаёт данные из памяти одного компьютера в память другого без всякого участия процессора, «without any CPU involvement». Похожая формулировка есть в вопросах и ответах ассоциации InfiniBand. А спецификация Ultra Ethernet 1.0.3, документ о сетевом стеке для AI и HPC, прямо предлагает оставить управление и сложную обработку ошибок на центральном процессоре.
У передачи есть подготовка и собственно перенос байтов. Процессор может настроить доступ к памяти и выдать задание, после чего сетевые адаптеры выполнят передачу самостоятельно. Именно разделение этой работы позволяет RDMA разгрузить CPU.
В сети ускорителей к этому добавляется другая задача: доставить данные от множества отправителей так, чтобы они не заблокировали друг друга. Скорость отдельного порта здесь помогает лишь до первого переполненного буфера.
Ожидание между вычислениями
Большую модель обучают на многих ускорителях сразу. Каждый считает свою часть, а затем все обмениваются результатами, и только после этого начинается следующий шаг. Такие групповые обмены называют коллективными операциями. All-reduce складывает частичные результаты всех участников и раздаёт каждому сумму. All-gather собирает у каждого его кусок и раздаёт всем полный набор. All-to-all отправляет каждому участнику свою порцию данных от каждого.
Пока идёт обмен, ускоритель часто ждёт. Самый быстрый ускоритель в группе не сократит этот этап: шаг закончится, когда придут данные от самого медленного соседа. Поэтому сеть для таких задач оценивают не по скорости одного порта, а по времени, за которое завершается вся работа.
Сколько именно длится ожидание, зависит от модели, размера сообщений, топологии и программ. Универсального процента здесь нет, и честный ответ даёт только замер на своей задаче. Но общее правило понятно: чем меньше лишних копирований и задержек на пути данных, тем меньше простоя.
Две дороги одной передачи
В типичном сокетном обмене приложение обращается к сетевому стеку ОС. Обработка протокола и копирование буферов требуют работы CPU, хотя аппаратные разгрузки и механизмы zero-copy могут её сократить.
RDMA, Remote Direct Memory Access, делит эту работу на две части.
В обычной модели с управлением от CPU часть подготовки выполняется заранее. Программа регистрирует область памяти, с которой будет работать сетевая карта, и задаёт права доступа к ней. Две стороны устанавливают соединение и договариваются, куда можно писать и откуда читать. Программа ставит в очередь задание на передачу, а позже забирает уведомление о его завершении. Регистрация и права относятся к подготовке доступа. Постановка заданий и обработка завершений также требуют работы программы.
Сам перенос полезных данных в аппаратном RDMA выполняют адаптеры. Получив задание, сетевая карта сама читает данные из памяти, отправляет их по сети, а карта на другой стороне сама кладёт их в зарегистрированную память получателя. CPU не копирует эти байты между сетевым стеком и буфером приложения. В некоторых системах задания может выдавать и ускоритель.
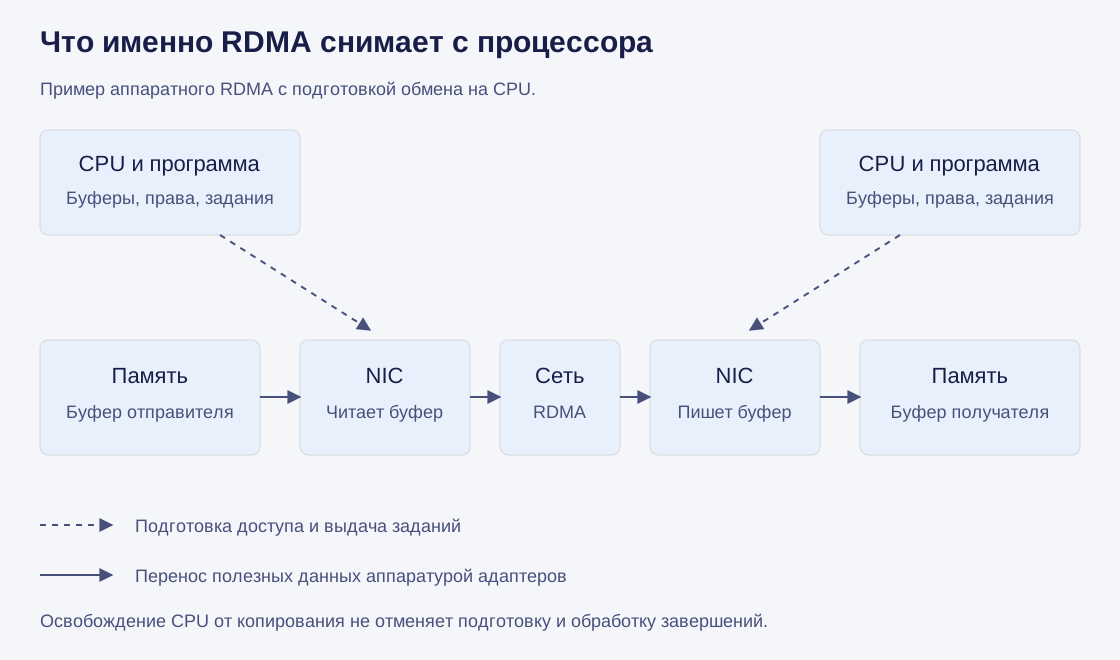
Открыть схему в полном размере
У RDMA два основных стиля обмена. В модели send и receive получатель заранее выкладывает буферы, и пришедшее сообщение попадает в очередной из них. В модели remote write и remote read отправитель сам указывает, в какое место чужой зарегистрированной памяти писать или откуда читать. Во втором стиле программа получателя не участвует в каждом сообщении, зато стороны должны заранее обменяться адресами и ключами доступа.
Что лежит в конверте RoCEv2
RDMA встроен в архитектуру InfiniBand, о которой рассказано в статье об InfiniBand и Slingshot. Чтобы перенести его в Ethernet, придумали RoCE, RDMA over Converged Ethernet.
Первая версия, RoCEv1, работает прямо поверх Ethernet: у неё свой тип кадра 0x8915. Такой пакет не проходит через маршрутизатор, поэтому RoCEv1 живёт в пределах одного сегмента сети.
RoCEv2 кладёт тот же транспорт RDMA в обычный IP-пакет с заголовком UDP и портом получателя 4791. Конверт выглядит так: кадр Ethernet, внутри заголовок IP, внутри UDP, внутри транспорт RDMA и данные. Теперь пакет можно маршрутизировать как любой другой IP-трафик.
UDP сам не подтверждает доставку и не восстанавливает порядок. В RoCEv2 он служит оболочкой для транспорта RDMA, который и определяет гарантии конкретного режима. NVIDIA называет его stateless encapsulation, обёрткой без состояния. В режиме надёжного соединения нумерацию пакетов, подтверждения и повторы выполняет транспорт RDMA внутри этой оболочки.
У конверта есть ещё одна полезная деталь. Порт отправителя в заголовке UDP несёт идентификатор потока. Коммутаторы при балансировке по нескольким путям, ECMP, смотрят на заголовки и разводят разные потоки по разным путям. Это не гарантия идеального распределения: если хеши потоков совпали, они пойдут одним путём, и спецификация Ultra Ethernet отдельно называет такие коллизии слабым местом ECMP. В описанном NVIDIA стеке MLNX_OFED аппаратно разгруженный трафик RoCE учитывается отдельными счётчиками RDMA, а не обычными счётчиками сетевого интерфейса. Администратор, который смотрит только на привычную статистику, может его просто не заметить.
Когда отправителей слишком много
Представим all-to-all на сотне ускорителей. В какой-то момент несколько десятков отправителей одновременно шлют данные одному получателю. Порт коммутатора, ведущий к нему, не может выдать больше своей скорости, и пакеты копятся в очереди. Такую ситуацию называют incast. Если очередь переполнится, пакеты начнут теряться, а для транспорта RDMA потеря означает повторную передачу и лишнее ожидание.
В RoCEv2 для управления перегрузкой применяют два механизма. ECN, явное уведомление о перегрузке, работает мягко: коммутатор с растущей очередью помечает проходящие пакеты, получатель видит метку и отправляет источнику специальное сообщение CNP, и источник снижает скорость. PFC, управление потоком по приоритетам, работает жёстко: коммутатор посылает соседу паузу для выбранного класса трафика, и тот перестаёт передавать этот класс, пока очередь не освободится.
PFC спасает от потерь, но у него есть цена. Пауза останавливает весь класс на канале, включая потоки, которые шли совсем к другим получателям. В большой сети такая пауза может распространиться дальше по цепочке коммутаторов. Именно на трудность эксплуатации больших сетей без потерь ссылаются авторы Ultra Ethernet, когда объясняют выбор в пользу сетей с возможными потерями.
RoCE с паузами и без них
Работает ли RoCE без PFC? NVIDIA в рекомендациях по развёртыванию описывает три режима сети.
| Режим | ECN | PFC | Для чего NVIDIA его предлагает |
|---|---|---|---|
| Lossy | Да | Нет | Простое развёртывание |
| Lossy with QoS | Да | Нет | Крупный масштаб со смешанным трафиком TCP, UDP и RoCE |
| Lossless | Да | Да | Максимальная производительность и системы хранения |
ECN включён во всех трёх режимах, PFC только в последнем. В командах коммутаторов NVIDIA Onyx есть и промежуточный вариант, semi-lossless, который поглощает короткие всплески, не распространяя паузы дальше.
У этих рекомендаций есть граница. Они написаны для сетевых карт ConnectX-4 и ConnectX-5, драйвера MLNX_OFED 4.2 и коммутаторов на Onyx, то есть для заметно постаревшего стека. Для современной карты условия нужно брать из её собственной документации. Главный вывод остаётся в силе: единственно правильного режима RoCE нет, есть набор поддерживаемых вариантов, и лучший выбирают тестом на своей нагрузке.
Что предлагает Ultra Ethernet
В июне 2025 года консорциум Ultra Ethernet выпустил спецификацию 1.0: полный стек на основе Ethernet для AI и высокопроизводительных вычислений. Затем вышли исправленные версии, и на 4 октября 2026 года действующей остаётся 1.0.3 от 16 июля 2026 года. Полный текст спецификации доступен на сайте консорциума.
Транспорт Ultra Ethernet называется UET, и по самой спецификации он задуман как ответ на ограничения RoCEv2: в семантике операций, транспорте, сложности и пределах масштаба. Несколько решений видны сразу.
UET рассчитан прежде всего на сети, где потери допустимы, и вместо пауз опирается на управление перегрузкой и телеметрию. При этом работать в сети без потерь он тоже может.
Он разрешает рассыпать пакеты одного обмена по всем доступным путям, если приложению не нужен строгий порядок доставки. Это прямой ответ на проблему совпавших хешей ECMP.
Коммутаторы помечают пакеты ECN в момент отправки из очереди, а не при постановке в неё, и могут обрезать пакет до заголовка вместо того, чтобы молча его выбросить. Обрезанный пакет сообщает получателю, что данные не дошли, и обрабатывать такие пакеты получатель обязан.
Возможности разбиты на три профиля: AI Base, AI Full и HPC. По умолчанию UET тоже едет в UDP, но с портом 4793, а программы обращаются к нему через библиотеку libfabric.
В тот же месяц, когда вышла 1.0.3, ассоциация InfiniBand добавила в свою спецификацию Multipath Reliable Connection, MRC: расширение надёжного соединения RoCEv2 для многопутевой передачи по Ethernet с возможными потерями. Его авторами названы AMD, Broadcom, Intel, Microsoft, NVIDIA и OpenAI. К одной задаче отрасль идёт двумя путями одновременно, и среди авторов MRC есть компании, которые продают адаптеры с заявленной поддержкой Ultra Ethernet.
Что умеет конкретная карта
Публикация спецификации не обновляет сетевые карты. Для выбора адаптера нужны версия транспорта, профиль и поддержка в прошивке. Формулировки в анонсах часто шире этих сведений. Broadcom в октябре 2025 года назвал свою карту Thor Ultra полностью соответствующей спецификации UEC и сообщил о поставках образцов. AMD описывает свои адаптеры как готовые к UEC, UEC-ready, и в том же документе перечисляет поддержку MRC.
Одинаковая скорость портов не делает RoCE и UET взаимозаменяемыми. Чтобы понять, что умеет карта, нужна короткая карточка: какие транспорты поддерживаются (RoCEv2, UET, MRC), с какой версией прошивки, через какую библиотеку и провайдер, в каком профиле. Членство производителя в консорциуме такой карточкой не является.
Как проверить, что сеть работает
Процессор из начала статьи освобождается от копирования полезных данных, но работа по подготовке обмена остаётся. Скорость постановки заданий и обработки завершений влияет на результат, особенно у коротких сообщений. При коллективном обмене ограничением может стать и сама сеть.
Поэтому проверка RDMA-сети это не один замер скорости, а план испытания:
- Сетевые карты, их прошивка и поддерживаемые транспорты.
- Возможности коммутаторов: классы трафика, ECN, PFC, многопутевая балансировка.
- Библиотека коллективных операций и её провайдер для сети.
- Топология и число переходов между узлами.
- Набор размеров сообщений, от мелких до крупных, и число одновременных заданий.
- Средние и хвостовые задержки, счётчики перегрузки и пауз.
- Главная метрика: время завершения реальной задачи.
Чем RDMA в Ethernet отличается от законченных HPC-сетей, рассказывает статья об InfiniBand и Slingshot, а физическую основу Ethernet разбирает статья от витой пары до 1,6T.