Восемь ускорителей выполняют один all-reduce, но название этой операции ничего не говорит о проводах между ними. В системах Ascend программа вызывает HCCL, а данные могут идти через HCCS, RoCE, PCIe или UnifiedBus. Документация CANN 9.1.X перечисляет все четыре транспорта. Доступный набор зависит от оборудования и версии программного стека.
В сентябре 2026 года Huawei заявила, что в архитектуре UnifiedBus, по-китайски 灵衢, уже объединила более десяти протоколов межсоединения. Это заявление о новой архитектуре систем. Библиотека HCCL обслуживает несколько поколений Ascend и сохраняет поддержку разных транспортов. По её списку нельзя судить ни о наличии UB в конкретном сервере, ни о том, какой путь использует запущенная задача.
Программа зовёт библиотеку
Возьмём задачу распределённого обучения на ускорителях Ascend. На каждом шаге процессоры обмениваются результатами, например выполняют all-reduce: складывают частичные суммы и раздают итог всем участникам. Программа не прокладывает маршрут сама. Она вызывает функцию HCCL, Huawei Collective Communication Library.
Библиотека выполняет обмен через поддерживаемое межсоединение. HCCS может связывать процессоры внутри сервера и между серверами: документация Atlas A3 прямо описывает SDMA-обмен по HCCS между AI Servers в суперузле. RoCE использует сетевой путь, PCIe и UB дают другие варианты аппаратного соединения. Разделение «HCCS только внутри сервера, RoCE всегда снаружи» для такой системы было бы ошибочным.
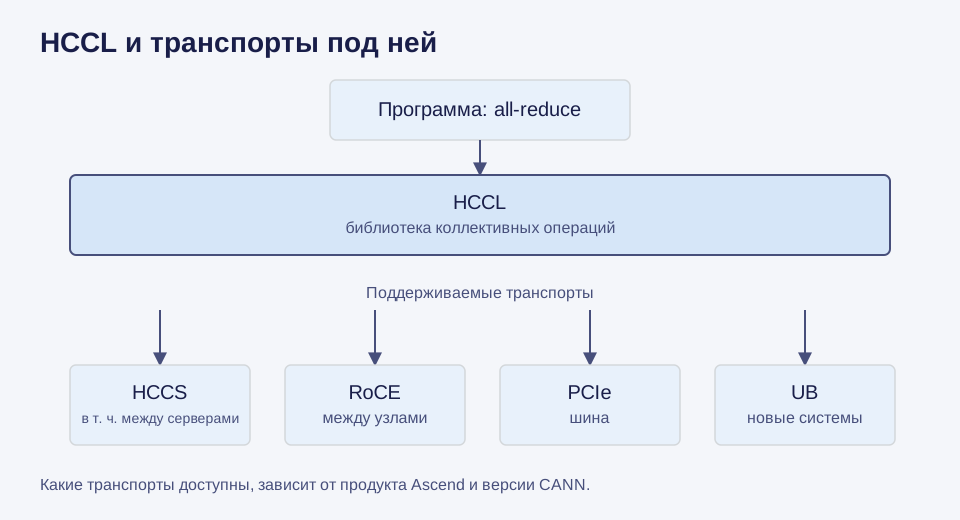
Открыть схему в полном размере
Программа вызывает HCCL; библиотека использует доступный путь: HCCS, RoCE, PCIe или UB. Набор путей зависит от продукта и версии.
Какой путь доступен, документация HCCL говорит прямо: на той же странице есть список поддерживаемых продуктов, от Ascend 950PR и 950DT до систем Atlas A3 и A2, с оговорками по конкретным серверам. Наличие четырёх транспортов в списке библиотеки не означает, что все четыре есть на любой машине.
Три имени, три уровня
Названия относятся к разным частям системы: HCCL описывает программные операции, HCCS аппаратное соединение, UB архитектуру межсоединения и её протокол.
| Имя | Что это | Уровень | Где описано |
|---|---|---|---|
| UnifiedBus, UB, 灵衢 | Архитектура межсоединения для суперузлов: протокол, семантика памяти, коммутация | Архитектура и протокол | Сообщество UnifiedBus, белая книга |
| HCCS | Huawei Cache Coherence System, высокоскоростное соединение CPU и NPU | Аппаратное соединение | Глоссарий Ascend |
| HCCL | Huawei Collective Communication Library, библиотека коллективных операций | Программное обеспечение | Документация CANN 9.1.X |
В расшифровке HCCS есть слово coherence, когерентность. Из этого названия нельзя вывести свойства всей памяти суперузла UB. В том же глоссарии Ascend встречается HCCP, Huawei Collective Communication Adaptive Protocol. Само определение термина не устанавливает обязательный промежуточный слой над всеми четырьмя транспортами HCCL.
Как шина обращается к памяти
Архитектуру UB описывает белая книга референсной архитектуры суперузла версии 6.0.0.
Главная идея там названа межсоединением шинного класса. Обычная сеть передаёт сообщения: отправитель упаковывает данные, получатель распаковывает. Шина работает с адресами памяти: процессор читает или записывает по адресу, даже если память физически находится в другом устройстве. Белая книга обещает для синхронного доступа с семантикой памяти задержку в сотни наносекунд, для асинхронного от 2 до 5 микросекунд, а между компонентами полосу порядка терабайт в секунду.
Стек описан в восемь уровней, от физического до управления. На функциональном уровне программы получают две модели: обычные load и store, как при работе с локальной памятью, и URMA, единый удалённый доступ к памяти. Блок UMMU переводит глобальные адреса в локальные и проверяет права доступа. Ресурсы можно объединять в пулы через разделы UB и одалживать память между узлами. Для связи между кластерами предусмотрен UBoE, перенос транзакций UB поверх Ethernet и IP. В родной фабрике UB транзакции идут по её собственному стеку, а при UBoE переносятся внутри сетевых пакетов.
Слово unified, единая, не означает, что вся память суперузла когерентна на любом расстоянии. Белая книга такого свойства для всего суперузла не заявляет; поддержание актуальности кэша упоминается лишь для отдельных видов транзакций. Порядок обращений, когерентность и точные модели доступа описывает нормативная спецификация, доступная на условиях отдельного лицензионного соглашения.
Сентябрьские документы
18 сентября 2026 года на форуме в рамках Huawei Connect в Шанхае сообщество UnifiedBus выпустило два документа: базовую спецификацию 2.1 и спецификацию тестов совместимости 2.0, том 1. По описанию на главной странице сообщества, версия 2.1 добавляет скорости 224 и 256 Гбит/с, надёжную перемаршрутизацию и снижение задержки при многопутевой передаче. Тестовый том содержит проверки физического, канального и сетевого уровней.
Белая книга доступна по лицензии CC BY 4.0. Получение базовой и тестовой спецификаций требует согласия с отдельной лицензией; описание архитектуры в белой книге не заменяет их нормативных требований при разработке совместимого устройства.
Сентябрьский отчёт о форуме описывает и работу партнёров над аппаратной экосистемой.
На форуме выступил заместитель генерального директора шэньчжэньского разработчика микросхем 楠菲微电子. По его словам, работа компании над IP-блоком UB началась во втором квартале 2026 года, тестирование совместимости с другими участниками запланировано на конец года, а выпуск микросхем IO Die и коммутатора ожидается к 2028 году. Это план одной компании-партнёра, а не дорожная карта всего сообщества, и уже выпущенными эти изделия считать нельзя.
Объявление Huawei
Одновременно Huawei представила три устройства. UnifiedBus LinkBlade соединяет процессоры внутри шкафа без кабельной разводки; по заявлению компании, в суперузле на 4096 NPU он экономит около 196 километров медного кабеля. UnifiedBus LinkDevice связывает шкафы между собой: 176 портов по 1,6 Тбит/с и 280 Тбит/с полностью оптического межсоединения, с задержкой туда и обратно от 2 микросекунд. Коммутатор UBG заявлен с числом портов до 1024 для кластеров на миллион ускорителей.
176 × 1,6 даёт 281,6 Тбит/с, тогда как суммарная полоса в объявлении равна 280 Тбит/с. Релиз не объясняет разницу: округление возможно, но не установлено. Также не указано, суммируются ли направления. Единица здесь биты, Тбит/с; 1,6 Тбит/с соответствует 200 ГБ/с после простого перевода единиц, до учёта служебного трафика и условий измерения.
RTT, round-trip time, это время пути туда и обратно. Сравнивать его с односторонней задержкой других систем нельзя, а для 2 микросекунд Huawei не называет ни размер сообщения, ни нагрузку, ни точки замера. В том же объявлении есть и второе утверждение, о снижении RTT с 7 до 2 микросекунд при объединении протоколов, и это уже не характеристика устройства, а оценка эффекта архитектуры. Обе оценки принадлежат Huawei. Для сравнения с другой системой нужны одинаковые операции, размеры сообщений и точки измерения.
Национальный документ без слова UnifiedBus
На государственном портале стандартов Китая зарегистрированы два проекта с общим названием «единый протокол вычислительной высокоскоростной межсоединительной шины»: общие положения под номером 20262599-Z-469 и технические требования к межсоединению суперузла с равноправной архитектурой под номером 20262600-Z-469. Они зарегистрированы 6 и 7 мая 2026 года, ведёт их технический комитет по информационным технологиям TC28, срок работы 12 месяцев, статус «на рассмотрении».
Слова UnifiedBus или 灵衢 в карточках нет. Разработчиком первым указан Китайский институт стандартизации электроники, а дальше идут более шестидесяти организаций, среди них Huawei, ZTE, Hygon, Cambricon, Moore Threads, Biren, Kunlunxin и T-Head. Фирменная технология одной компании и отраслевой документ многих участников связаны темой, но это не одно и то же.
Есть и формальная деталь. Буква Z в номере означает руководящий технический документ, будущий GB/Z, а не национальный стандарт GB/T. Пока оба документа остаются проектами на рассмотрении, а не действующими нормами. Рядом на портале есть третья часть того же семейства, о требованиях к соединению ускорителей, зарегистрированная в конце 2025 года и тоже находящаяся на рассмотрении.
Один all-reduce, разные ограничения
Допустим, восемь ускорителей хранят по массиву из миллиона 32-битных чисел. Каждый локальный массив занимает 4 МБ в десятичных единицах. После all-reduce с суммированием каждый участник должен получить массив того же размера, в котором каждый элемент содержит сумму восьми исходных значений. Объём результата на одном ускорителе остаётся 4 МБ; умножение на число участников даёт 32 МБ копий результата во всей группе. Ни одно из этих чисел само по себе не равно объёму трафика на каждой линии: он зависит от алгоритма обмена и маршрутов.
Если все участники подключены через HCCS, библиотека может использовать этот поддерживаемый путь. При переносе той же задачи на систему с другим соединением вызов коллективной операции сохраняет смысл, но время обмена меняется. Проверять нужно также размер группы: результат теста между двумя ускорителями не описывает работу восьми участников, одновременно занимающих общие линии. Для маленьких массивов особенно заметны запуск операции и синхронизация; для больших растёт роль устойчивой полосы передачи.
Удобный практический тест состоит из нескольких размеров массива при неизменном числе участников. Затем число участников увеличивают, сохраняя размеры и тип данных. Так можно увидеть, на каком переходе меняется время операции: при добавлении ускорителя в том же сервере, при выходе в соседний сервер или за пределы суперузла. Вместе со временем нужно сохранять фактически использованный транспорт. Иначе два запуска HCCL с одинаковым названием операции могут оказаться проверками разных аппаратных путей.
Семантика памяти UB добавляет ещё один вопрос: где лежат данные, к которым обращается процессор. Возможность адресовать удалённую память не делает её физически локальной. Если рабочий набор перенесён в другой узел, обращения проходят через межсоединение и конкурируют с остальным трафиком. Поэтому сравнение должно сохранять размещение данных или явно учитывать его изменение. Заявленную задержку доступа к памяти нельзя подставлять вместо времени всего all-reduce: коллективная операция включает несколько участников и собственную последовательность обменов.
Что нужно, чтобы программа заработала
Заявленная Huawei унификация не отменяет проверки конкретной конфигурации. Программа получит тот транспорт, который поддерживают её оборудование и версия ПО.
Чтобы понять, какой именно, нужно выяснить:
- Модель ускорителя Ascend и системы, в которой он стоит.
- Версию CANN и то, входит ли этот продукт в список поддерживаемых для HCCL.
- Какие транспорты есть у машины и между нужными серверами: HCCS, RoCE, PCIe, UB.
- Топологию: сколько процессоров в узле и в суперузле, как они соединены.
- Версии драйвера и прошивки и права доступа к устройствам.
- Средства наблюдения: как увидеть, по какому пути на самом деле идёт обмен.
- Независимый замер нужной операции на своей задаче.
Конфигурация становится воспроизводимой, когда вместе с результатом теста сохранены модель системы, схема соединений, версии ПО и параметры операции. Как ту же задачу решают NVIDIA, AMD и открытые консорциумы, рассказывают статьи о NVLink и Infinity Fabric и о UALink и ESUN, а сетевую основу RoCE разбирает статья о RDMA и Ultra Ethernet.