В таблице характеристик стойки NVIDIA Vera Rubin NVL72 рядом стоят две строки. Память HBM всех 72 графических процессоров вместе выдаёт 1400 ТБ/с. Связь NVLink, которая соединяет эти процессоры между собой, выдаёт 216 ТБ/с, примерно в шесть с половиной раз меньше.
Если память настолько быстрее, зачем NVIDIA строит в стойке отдельную коммутируемую сеть, а AMD соединяет свои ускорители полной сеткой линков? И что вообще означают эти 216: полосу каждого процессора, сумму по стойке, скорость одного кабеля?
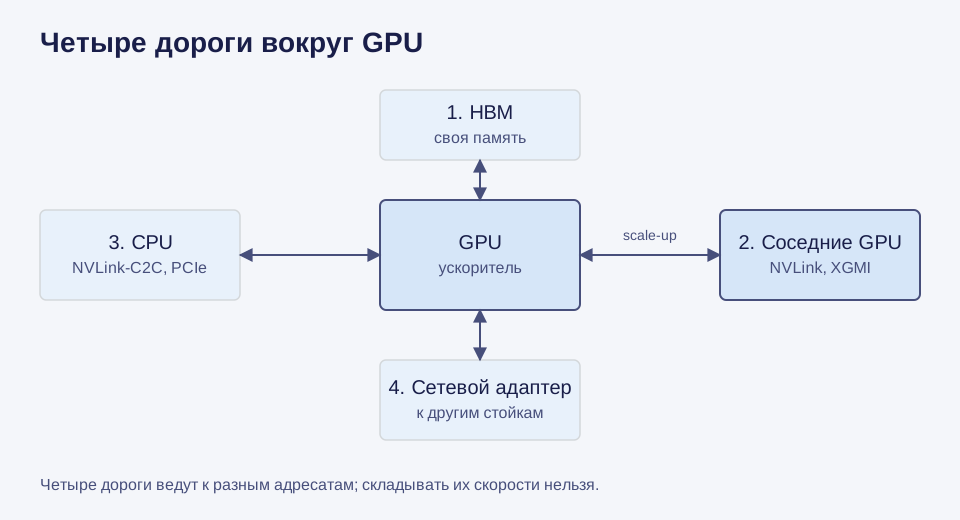
У графического процессора четыре основных пути данных: к собственной памяти, к другим GPU, к центральному процессору и во внешнюю сеть. Полоса каждого пути определяет свою часть работы. Для обмена между GPU имеют значение ещё и топология соединений, число одновременных передач и библиотеки, которыми пользуется программа.
Четыре дороги вокруг GPU
Первая дорога ведёт в собственную память. HBM, память с высокой пропускной способностью, стоит в одном корпусе с процессором, и по ней он читает веса модели и промежуточные результаты. У Rubin в составе NVL72 это 19,2 ТБ/с на 288 ГБ.
Вторая дорога ведёт к соседним GPU. Это и есть scale-up, масштабирование внутри одного вычислительного домена: у NVIDIA это NVLink, у AMD линки Infinity Fabric, которые в документации называют XGMI.
Третья дорога соединяет GPU с центральным процессором. У NVIDIA для этого есть отдельная связь NVLink-C2C, у многих систем обычный PCIe.
Четвёртая дорога уводит данные из домена во внешнюю сеть, к другим стойкам, через сетевой адаптер. Как устроены такие сети, рассказывают статьи об InfiniBand и Slingshot и о RDMA и Ultra Ethernet.
Открыть схему в полном размере
Локальная память, связь с соседними GPU, связь с CPU и внешняя сеть. NVLink и XGMI обслуживают обмены между GPU.
NVIDIA сама разводит эти дороги в таблице сравнения Blackwell и Rubin: NVLink между GPU, NVLink-C2C между CPU и GPU и PCIe Gen 6 указаны отдельными строками, каждая с собственной скоростью в обе стороны. Складывать их в одну цифру бессмысленно: это разные пути к разным адресатам.
Зачем ускорителям домен
Большая модель не помещается в память одного GPU, а её обучение на одном процессоре заняло бы слишком много времени. Поэтому модель режут на части. Слои распределяют между процессорами, большие матрицы делят на куски, а на каждом шаге процессоры обмениваются результатами с помощью коллективных операций.
Такие обмены частые, а данных в них много. Если каждый из них отправлять через внешнюю сеть, процессоры будут больше ждать, чем считать. Поэтому группу процессоров, которые обмениваются особенно интенсивно, объединяют быстрой внутренней связью. Эта группа и есть scale-up домен.
Объединённые GPU сохраняют собственную память. Модель распределяет приложение или фреймворк: выбирает, какие слои и части матриц разместить на каждом GPU. Библиотеки коллективных операций, NCCL у NVIDIA и RCCL у AMD, выполняют необходимые обмены между процессорами. От быстроты этих обменов зависит, насколько выгодно распределение.
NVLink и коммутатор в стойке
Без коммутатора каждый GPU соединяется с соседями напрямую, и число соседей ограничено числом линков на корпусе. Чем больше процессоров, тем труднее соединить каждого с каждым. Поэтому у NVIDIA есть коммутаторы NVLink Switch. Они соединяют множество линков и дают связь всех со всеми на полной скорости NVLink по всей стойке. В коммутаторах есть и вычислительные блоки SHARP, которые выполняют часть коллективных операций прямо в сети. В Rubin один коммутационный лоток содержит четыре микросхемы NVLink 6 Switch, а лотки вместе образуют одну топологию всей стойки.
В таблице NVIDIA домены NVLink бывают на 8 и на 72 GPU. Восемь долго оставались привычной границей: спецификация OCP ESUN прямо пишет, что до Llama 4 scale-up обычно означал восемь GPU в одном узле. Коммутатор меняет топологию, то есть то, кто с кем может обмениваться напрямую. Память каждого GPU при этом остаётся его собственной.
У NVLink есть два родственника. NVLink-C2C переносит ту же идею на уровень соединения микросхем: в Vera Rubin Superchip он связывает один CPU Vera с двумя GPU Rubin и поддерживает единое адресное пространство. Указанные 1,8 ТБ/с относятся ко всему superchip и суммируют оба направления. А NVLink Fusion NVIDIA предлагает как технологию и IP-блоки для чужих процессоров и ускорителей. В мае 2025 года компания объявила доступными услуги проектирования у партнёров. Перечень партнёров описывает участие компаний в экосистеме. Для выбора совместимого оборудования нужны конкретные модели CPU и ускорителей, их документация и условия поставки; сам анонс услуг проектирования этих сведений не даёт.
Числа, которые поменялись в сентябре
В январе 2026 года, на выставке CES, NVIDIA представила NVLink 6 с полосой 3,6 ТБ/с на GPU и 260 ТБ/с на стойку NVL72. Те же числа долго стояли на страницах продукта. А на 4 октября 2026 года страница стойки, страница NVLink и свежий datasheet называют 3 ТБ/с на GPU и 216 ТБ/с на стойку.
По архивным копиям видно, когда это произошло. Страница стойки ещё 1 сентября показывала 3,6, 260 и 22 ТБ/с памяти на GPU, а 11 сентября уже 3, 216 и 19,2. Страница NVLink сменила числа между 14 и 20 сентября, и заодно прирост к прошлому поколению из «2x» стал «1.7x».
При этом обновилось не всё. Страница NVLink Fusion на том же сайте по-прежнему говорит о 3,6 ТБ/с и 260 ТБ/с, а технические блоги NVIDIA о Rubin сохранили 3,6 ТБ/с и 22 ТБ/с памяти.
| Материал NVIDIA | На GPU | На стойку NVL72 | Память HBM на GPU |
|---|---|---|---|
| Сообщение CES, январь 2026 | 3,6 ТБ/с | 260 ТБ/с | не указана |
| Блог о платформе Rubin, январь 2026 | 3,6 ТБ/с | 260 ТБ/с на иллюстрации NVLink 6 Switch | до 22 ТБ/с |
| Блог об архитектуре GPU Rubin, июль 2026 | 3,6 ТБ/с | не указана | до 22 ТБ/с |
| Страница NVLink Fusion, октябрь 2026 | 3,6 ТБ/с | 260 ТБ/с | не указана |
| Страница стойки и datasheet, октябрь 2026 | 3 ТБ/с | 216 ТБ/с | 19,2 ТБ/с |
Каждая пара чисел внутренне согласована: 3 × 72 = 216, а 3,6 × 72 = 259,2, что округляется до 260. Обе стоечные величины совпадают с суммой полос всех GPU с учётом округления. Из этой арифметики нельзя вывести скорость одной пары или схему одновременных передач. Причину изменения продуктовые страницы и технические блоги не объясняют. Поэтому при сравнении NVLink 6 нужно указывать документ и дату: расхождение между материалами NVIDIA сохраняется.
В этих характеристиках NVLink NVIDIA суммирует оба направления и все соединения одного GPU. Скорость одного линка будет другой. Чтобы оценить обмены между несколькими парами процессоров, нужны топология и условия одновременной нагрузки.
Как считает AMD
У AMD своя арифметика. В документации ROCm 7.2.4 есть таблица сравнения ускорителей, и в ней для MI300X и MI325X указана «P2P ring aggregate» 896 ГБ/с, а для MI350X и MI355X 1075,2 ГБ/с. Название ring переводится как «кольцо», однако одной подписи столбца недостаточно, чтобы определить физическую топологию.
Паспорт платформы MI300X описывает другую картину: полную сетку, fully-meshed. Каждый из восьми ускорителей связан с каждым из семи соседей отдельным линком по 128 ГБ/с в обе стороны. И 7 × 128 даёт ровно 896. Для MI355X брошюра платформы называет семь линков по 153,6 ГБ/с, и 7 × 153,6 = 1075,2.
Получается, что «кольцевой агрегат» в таблице равен сумме семи линков одного ускорителя, а каждой паре соседей достаётся 128 или 153,6 ГБ/с. Численное совпадение следует из сопоставления таблицы ROCm с паспортами платформ; явного определения этого столбца через сумму семи линков AMD здесь не даёт. В брошюре самого MI355X на первой странице стоят те же 153,6 ГБ/с на линк, а на второй сказано о 160 ГБ/с между каждой парой GPU. Какое из чисел точнее, документ не объясняет.
В той же таблице ROCm есть столбец общей пиковой полосы ввода-вывода: 1024 и 1203,2 ГБ/с. Разница с «кольцом» в обоих случаях 128 ГБ/с, ровно столько даёт PCIe 5.0 x16, которым каждый ускоритель подключён к серверу. Такое совпадение допускает объяснение «семь межGPU-линков плюс PCIe», но AMD в этой таблице его не подтверждает. При сравнении систем следует сохранять исходные названия обоих столбцов.
Сами линки AMD называет Infinity Fabric, а их внешний вариант между GPU описывает как XGMI, основанный на технологии Infinity Fabric и работающий в группах из 2, 4 или 8 ускорителей. Infinity Fabric шире: это общее имя технологии внутренних и внешних связей AMD, так что точнее говорить о XGMI, когда речь о связи между GPU.
Почему локальная память быстрее
Память HBM у AMD тоже быстрее межпроцессорной связи: у MI355X 8 ТБ/с против суммарных 1,075 ТБ/с на все семь линков. Разница связана с устройством и задачами этих соединений.
Память стоит рядом с процессором, в одном корпусе, и обслуживает только его. Связь с соседями тянется через плату, разъёмы, кабели и коммутаторы и должна обслуживать десятки адресатов. Поэтому программы стараются держать большую часть работы в локальной памяти, а по связи отправлять то, без чего не обойтись: частичные результаты, градиенты, куски активаций. Например, если матрица разделена между GPU, каждый читает свою часть из HBM, выполняет вычисления и передаёт соседям частичный результат. Повторное использование локальных данных сокращает объём обменов. Если же следующий шаг постоянно ждёт данные соседей, время работы начинает определяться межGPU-связью.
Полосу HBM сравнивают с полосой HBM, а полосу связи с полосой связи, и в одинаковых единицах, с одинаковым направлением и для одинакового объекта: линка, процессора или всей стойки. Как приводить такие числа к одной системе отсчёта, подробно объясняет статья о сравнении полосы.
Что проверить у GPU-системы
В таблице NVL72 величина 1400 ТБ/с описывает суммарную полосу локальной памяти, а 216 ТБ/с относятся к обменам между GPU. Эти обмены нужны и когда модель не помещается на одном ускорителе, и когда её распределяют ради скорости. Домен позволяет 72 процессорам работать над одной задачей, передавая промежуточные результаты внутри стойки.
Для конкретной системы стоит выяснить:
- Сколько GPU входит в домен и как они соединены: напрямую, полной сеткой или через коммутаторы.
- Какая полоса приходится на линк, на процессор и на домен, в каком направлении и по какому документу.
- Какие пары процессоров могут обмениваться одновременно на полной скорости.
- Какие версии NCCL или RCCL поддерживаются и как они используют топологию.
- Сколько памяти у каждого процессора и сколько нужно модели.
- Как домен выходит во внешнюю сеть и с какой скоростью.
- Как ведёт себя реальная задача: время шага обучения или задержка ответа модели.
Для измерения нужно зафиксировать модель, размер задачи, число GPU и версии программ. Тогда время шага обучения или задержка ответа покажут, какую пользу конкретная программа получает от оборудования. Как к той же задаче подходят открытые инициативы, рассказывает статья о UALink, UALoE и ESUN.