Искусственный интеллект
NVIDIA выпустила Nemotron 3.5 Transcribe: открытая модель расшифровывает и переводит часовые записи и отвечает на вопросы по аудио
Публикация:
Одна модель с открытыми весами заменяет связку из транскрибатора, диаризации и переводчика: 40 языков распознавания, записи до часа, до восьми говорящих, а формат расшифровки задаётся обычной инструкцией.
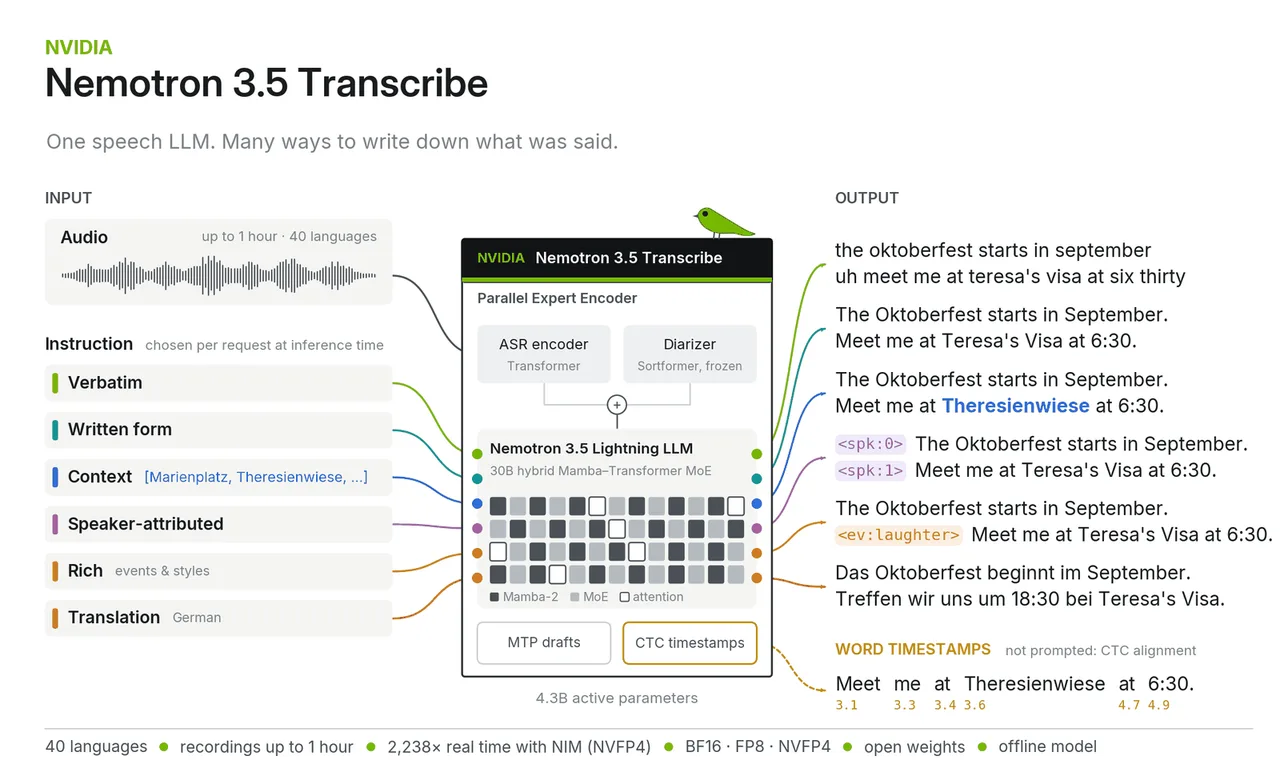
NVIDIA 28 октября представила Nemotron 3.5 Transcribe, модель с открытыми весами, которая объединяет в одном чекпоинте транскрипцию, определение говорящих, перевод речи и ответы на вопросы по аудиозаписи. Модель уже доступна на Hugging Face и ModelScope под лицензией OpenMDW-1.1.
Одна модель вместо цепочки сервисов
Обычные системы распознавания речи фиксируют единственный формат расшифровки ещё при обучении. Nemotron 3.5 Transcribe принимает инструкцию обычным языком для каждого запроса: можно попросить дословную запись, очищенный текст без слов-паразитов, перевод или расшифровку с корректным написанием профессиональных терминов. По запросу модель выдаёт пословные таймкоды с привязкой к говорящим.
- «Расшифруй эту запись и подпиши каждого говорящего»
- «Переведи это аудио на английский»
- «Какие решения были приняты на этой встрече?»
Модель обрабатывает записи длительностью до одного часа и различает до восьми говорящих. Поддержка языков зависит от задачи: расшифровка работает на 40 языках, перевод на английский и с английского на 31 языке, атрибуция говорящих на 13, а ответы на вопросы по аудио обучены на английском. Отдельно NVIDIA подчёркивает: модель рассчитана на готовые записи, а не на прямую трансляцию.
| Задача | Языки |
|---|---|
| Транскрипция | 40 |
| Перевод в/из английского | 31 |
| Атрибуция говорящих | 13 |
| Вопросы к аудиозаписи | английский |
Результаты в тестах
На мультиязычном треке Open ASR Leaderboard модель показала среднюю долю ошибок WER 4,62%, лучший результат среди открытых моделей, а на английском треке занимает первое место среди моделей с открытыми весами. В независимом рейтинге Artificial Analysis она делит первое место среди открытых моделей с индексом 2,8% AA-WER, опережая по совокупному графику и ряд проприетарных речевых API.
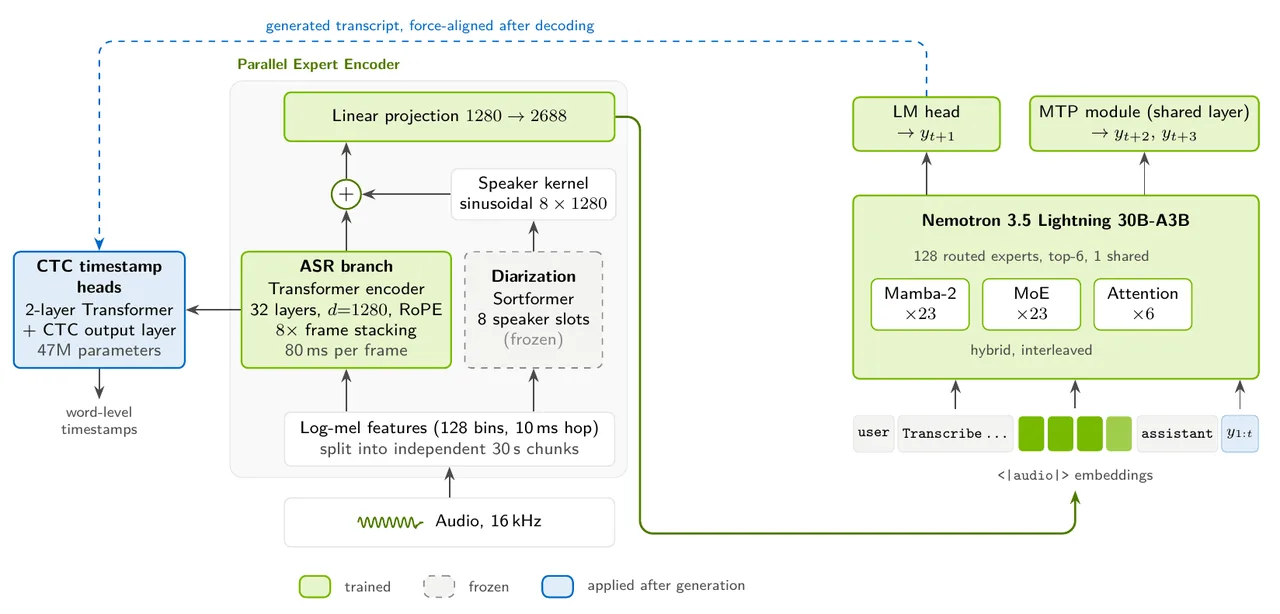
Секрет экономии в архитектуре: из 30 млрд параметров при генерации активны около 4 млрд за счёт гибридной связки Mamba-Transformer и mixture-of-experts. В задачах атрибуции говорящих модель показала лучшую ошибку диаризации 18,26% в 21-язычном тесте David AI и первое место среди 14 систем в бенчмарке VoiceArena, включая записи с сильно перекрывающейся речью.
Скорость и развёртывание
В собственном бенчмарке NVIDIA модель обработала 100 часов аудио менее чем за три минуты на одном ускорителе RTX PRO 6000 Blackwell. Замер выполнялся на 30-секундных фрагментах при высокой параллельности с помощью готовящейся квантованной версии NVFP4, поэтому речь идёт о суммарной пропускной способности, а не о длительности одной записи.
Базовый чекпоинт работает с vLLM и SGLang-Omni с первого дня, доступны и готовые эндпоинты Baseten, DeepInfra и Simplismart. Квантованные версии для локального запуска на RTX Spark, DGX Spark и Jetson AGX Thor обещаны позже: исследовательская страница NVIDIA уже перечисляет сборки FP8, NVFP4 и GGUF, а блог Hugging Face пока обозначает их как coming soon. Ноутбуки на платформе RTX Spark уже поступили в продажу у шести производителей.
Granary v2 и дообучение под свою терминологию
Вместе с моделью опубликован Granary v2, открытый конвейер подготовки обучающих данных на базе NeMo Curator. Публичный манифест описывает 463 062 часа аудио на 48 языках из 16 корпусов и включает три варианта расшифровки каждой записи, метки задач и метаданные качества. NVIDIA особо оговаривает, что эти цифры относятся к релизу датасета, а не к полному составу обучающей выборки модели.
Кейс медицинской расшифровки на открытом бенчмарке Eka Care показывает порядок выгоды: одна точная инструкция с указанием языка и алфавита снизила WER с 30,8% до 23,8%, а дообучение через инструменты NeMo Speech довело результат до 11,8%. На отложенной выборке новых говорящих ошибка сократилась с 22,44% до 12,17%, то есть на 45,8%, при этом вся адаптация заняла около 14 GPU-часов на одном ускорителе GB300.
Практический вывод прост: протоколы встреч, лекции и диктовку теперь можно приводить к единому корпоративному формату на собственном оборудовании и с собственной терминологией, не отправляя записи в сторонние API. Это вписывается в общее наступление NVIDIA на рынок корпоративного ИИ, где компания параллельно разворачивает системы Vera Rubin в облаке Oracle.