AI и дата-центры
NVIDIA открыла код системы восстановления сбоев в обучении ИИ-кластеров
Публикация:
NVIDIA Recovery ищет сбои в распределённых задачах, определяет вероятную причину, изолирует проблемные узлы и может перезапустить работу с контрольной точки. Сейчас сервис экспериментальный, поддерживает Slurm и по умолчанию только предлагает действия.
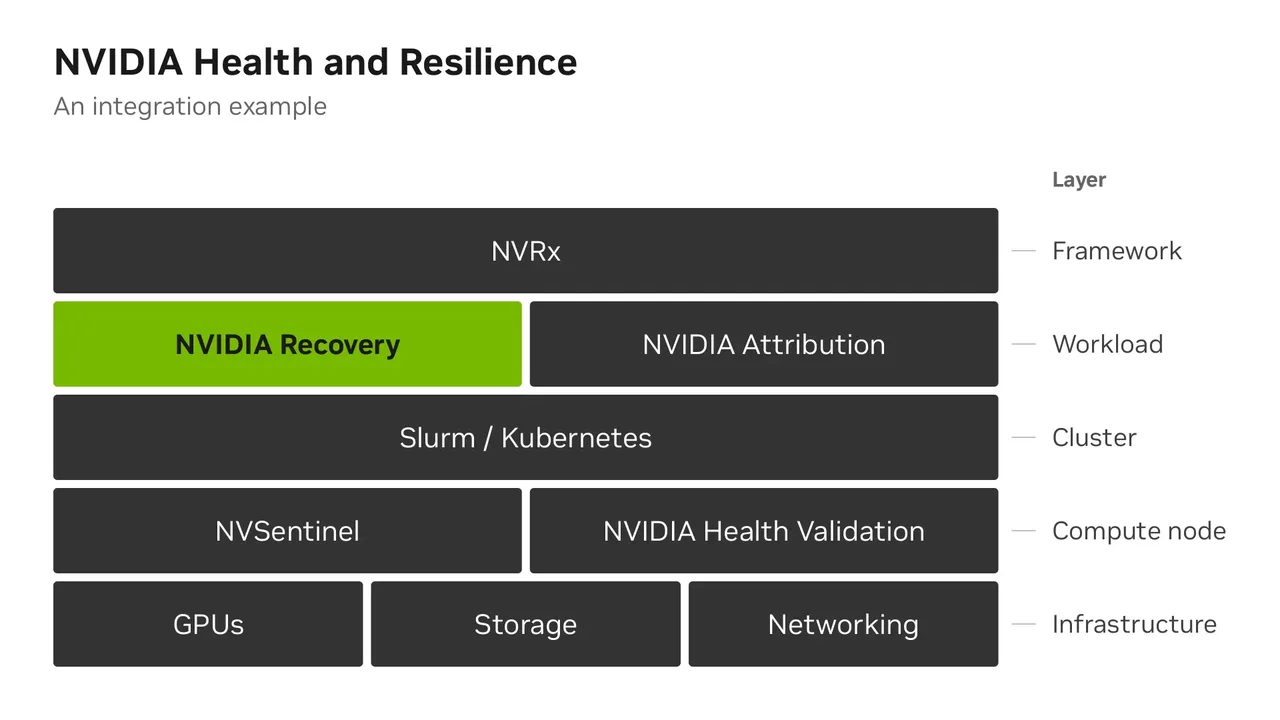
2 ноября NVIDIA представила NVIDIA Recovery — открытый сервис, который координирует восстановление распределённых задач обучения на уровне кластера. Он собирает сигналы из журналов приложений, метрик GPU и планировщика, чтобы находить сбои, зависания и отстающие процессы.
Как устроен цикл восстановления
Система сначала обнаруживает сбой, затем классифицирует его и формирует рекомендацию. Для более глубокой диагностики можно подключить NVIDIA Attribution: этот компонент помогает различать аппаратные проблемы, ошибки системного ПО и дефекты приложения. NVIDIA Recovery допускает и собственный сервис атрибуции оператора.
После этого контроллер может исключить затронутый узел из следующих попыток и перезапустить задачу на исправной инфраструктуре. Обучение продолжается с последней сохранённой контрольной точки, используя существующую логику перезапуска приложения. Если повторные попытки не дают нового checkpoint, правила оператора могут остановить дальнейшие запуски.
Интеграция и ограничения
Сейчас сервис интегрируется с планировщиком Slurm; для установки NVIDIA предлагает контроллер-советник в виде Helm chart, который можно разместить внутри кластера или подключить по SSH. Поддержка Kubernetes-native workloads указана в планах, а не как доступная возможность: опубликованная документация описывает Slurm и Slurm-on-Kubernetes через Slinky.
Новые установки запускаются в режиме наблюдения: Recovery записывает рекомендации, но не выполняет действия в планировщике. Оператор может сопоставить их с решениями своей команды и только после проверки включить автоматическое управление. Сервис ведёт журнал обнаружений и действий; панель Recovery Console показывает состояние задач и их историю.
NVIDIA сообщает, что на одном тренировочном кластере с 9 июля по 9 октября система наблюдала почти за 200 задачами в день и зарегистрировала около 8 550 аномалий. Среднее время обнаружения составило 69 секунд, а до автоматического действия по восстановлению — 94 секунды. Это наблюдения производителя на одном кластере; последнее значение не означает, что за это время обучение уже возобновилось: планирование и загрузка checkpoint занимают отдельное время.
NVIDIA Recovery распространяется под лицензией Apache 2.0, но в документации проект прямо назван экспериментальным и не готовым к производственному использованию: API, конфигурация и поведение могут меняться. Сейчас заявлена поддержка GPU NVIDIA поколений Ampere—Blackwell, а нативное восстановление Kubernetes-задач ещё не реализовано.
Для команд, которые обучают модели на кластерах Slurm, проект может сократить ручную работу при повторяющихся сбоях, но автоматические действия стоит включать только после проверки сигналов в режиме наблюдения и настройки контрольных точек. В других материалах USB.RU мы разбирали разделение памяти GPU между задачами в Kubernetes и доступность новой платформы NVIDIA в облаке Oracle — это отдельные события, связанные с инфраструктурой NVIDIA.