AI и дата-центры
CUDA 13.4 добавила ограничения памяти GPU для совместных нагрузок в Kubernetes
Публикация:
CUDA 13.4 получила прозрачные лимиты видеопамяти для разделяемых нагрузок, а открытый GPU Fractioning Operator переносит управление такими долями на узлы Kubernetes.
В техническом блоге NVIDIA описала новую возможность CUDA 13.4: задавать границы видеопамяти для нескольких нагрузок на одном ускорителе. Открытый GPU Fractioning Operator связывает её с Kubernetes и работает рядом с NVIDIA GPU Operator.
Для каждой нагрузки можно запросить точный объём памяти либо гарантированный минимум с возможностью вырасти до верхнего предела, пока память свободна. CUDA показывает задаче только выделенную ей долю; превышение жёсткого лимита приводит к ошибке выделения памяти. Оператор запускает и контролирует MPS на узлах, применяет ограничения и учитывает ресурсы каждой GPU-фракции отдельно.
За выбор видеокарты и размещение Pod отвечает планировщик. KAI Scheduler стал первым планировщиком с интеграцией: в версии 0.18.0 режим NvFractions записывает нужные аннотации Pod, которые оператор применяет на узле. NVIDIA указывает, что совместим и другой Kubernetes-планировщик, если он передаёт эти аннотации.
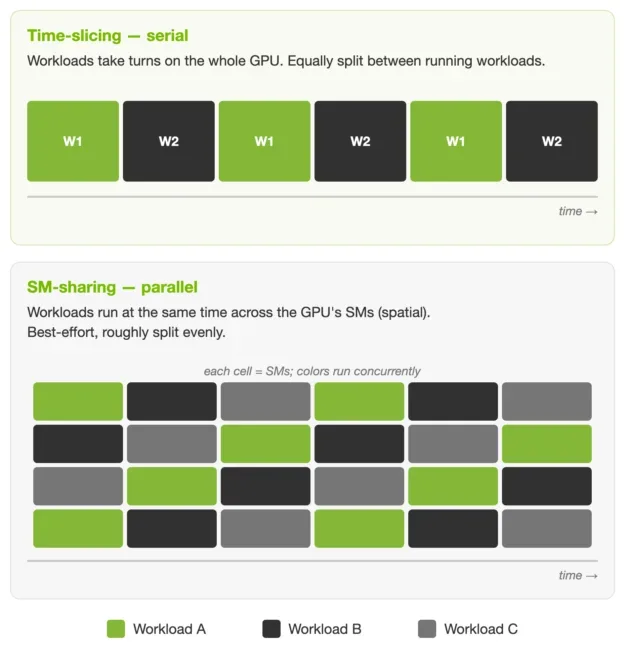
В режиме time-slicing нагрузки по очереди используют весь GPU; в SM-sharing вычисления идут параллельно на разных потоковых мультипроцессорах. На одной видеокарте нельзя смешивать эти режимы. При этом SM-sharing объединяет задачи в одну область отказа, тогда как time-slicing сохраняет для каждой собственную область ошибок.
Инструмент рассчитан прежде всего на операторов кластеров, которым нужно делить память GPU между небольшими задачами, а не выдавать каждой целый ускоритель. NVIDIA описывает механизм и примеры конфигурации, но не приводит независимых измерений прироста производительности. Для контекста о масштабировании ИИ-инфраструктуры можно прочитать материал USB.RU о системе NVIDIA DSX POD и о запуске ускорителей в облаке Oracle — Vera Rubin NVL72 в OCI.