AI-инфраструктура
Google удвоила чипы для длинного контекста: TPU 8i Max и защищённая TPU 8tx
Публикация:
Новые названия, но не новое поколение кремния: TPU 8i Max объединяет два чипа, а TPU 8tx получает защиту данных во время вычислений. Главный ход Google - перестройка системы вокруг ускорителя.
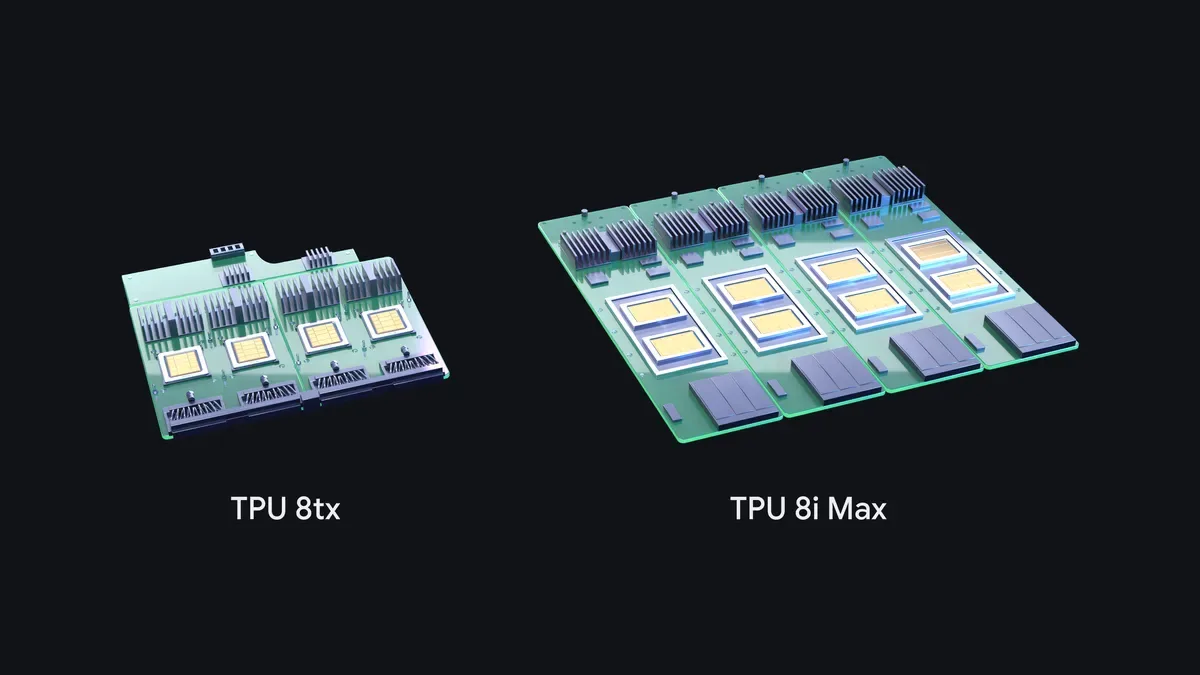
Google расширила семейство серверных ИИ-ускорителей двумя системами: TPU 8tx для защищённой работы с данными и TPU 8i Max для задач с большим контекстом. Это не следующее поколение чипов. Компания использовала уже существующий кремний, но изменила упаковку, сеть и защиту вокруг него.
TPU, или тензорный процессор, выполняет вычисления нейросетей. В новой паре Google разделяет две проблемы: как обрабатывать чувствительные данные, не снимая аппаратную защиту на время вычислений, и как быстрее подавать данные модели, которая работает с длинными документами, кодовой базой или видео.
TPU 8tx: защита данных во время работы
TPU 8tx построена на том же кремнии, что и TPU 8t, и работает с серверными процессорами AMD EPYC пятого поколения. Google позиционирует систему для конфиденциального инференса, то есть выполнения уже обученных моделей, а также небольших обучающих задач.
Обычно данные шифруют при хранении и передаче. Во время обработки они оказываются в открытом виде в памяти. В новой системе Google заявляет аппаратную защиту и изоляцию чувствительных данных и весов модели непосредственно во время вычислений. Основные адресаты - компании из регулируемых отраслей и государственные организации.
Вместо сети базовой обучающей системы используется низколатентная Boardfly, разработанная для инференса. По заявлению Google, задержка может быть до двух раз ниже, чем у TPU 8t. Это сравнение производителя с собственной системой, а не результат независимого теста и не обещание удвоить скорость любого приложения.
На одной системе предлагается выполнять инференс и адаптировать модель: дообучать на частных данных, переносить знания большой модели в меньшую и обучать агентов с подкреплением. Смысл такой конфигурации - не переносить чувствительные данные между отдельными кластерами ради смены задачи.
TPU 8i Max: два чипа в одной упаковке
Для TPU 8i Max Google объединила два чипа TPU 8i в одной упаковке. Компания заявляет удвоение вычислительных ресурсов, объёма SRAM и пропускной способности HBM относительно TPU 8i. При этом система помещается в прежний габарит стойки.
SRAM - быстрая память на самом чипе, а HBM - память с широким интерфейсом рядом с ним. Для длинного контекста важна не только вычислительная мощность: ускоритель должен вовремя получать данные. Если память не успевает их подать, дополнительные вычислительные блоки простаивают. Именно на этот перекос рассчитана новая конфигурация.
Удвоенная полоса памяти не равна удвоенной скорости ответа. Google описывает аппаратные ресурсы новой системы, но в анонсе не приводит отдельного воспроизводимого сравнения TPU 8i Max на одной и той же модели и нагрузке. Для выбора инфраструктуры всё равно нужны замеры задержки, пропускной способности и стоимости на своей задаче.
Длинный контекст требует ещё и нового обращения с памятью
Вместе с аппаратным анонсом Google представила TPU Sync - открытую библиотеку для перемещения состояния модели между памятью ускорителя, оперативной памятью сервера и другими узлами. Она переносит KV-кэш, то есть промежуточные данные уже обработанного контекста, и позволяет не пересчитывать одни и те же фрагменты запроса.
Библиотека сохраняет внутреннюю раскладку данных TPU и использует асинхронные DMA-передачи, совмещая перемещение данных с вычислениями. Это важно для схемы с раздельными узлами: одни обрабатывают входной запрос, другие генерируют ответ. Поддержка выгрузки на общий накопитель и модуль для обучения с подкреплением пока экспериментальные.
Проценты из тестов TPU Sync нельзя приписывать новым ускорителям. Google измеряла библиотеку на Ironwood, предыдущем поколении TPU, в лабораторных условиях. Снижение времени до первого токена зависит от модели, нагрузки и повторного использования контекста. Саму библиотеку компания уже выпустила с открытым кодом для PyTorch и JAX.
Программную часть анонса тоже стоит разделять по датам. TorchTPU, позволяющая запускать привычный PyTorch-код на TPU с минимальными изменениями, была открыта 20 октября 2026 года. Анонс новых систем объединяет аппаратные конфигурации с уже объявленными элементами программной платформы, а не запускает весь набор заново.
Что пока нельзя заказать по прайсу из анонса
Google не указала в основном анонсе цену, регионы и дату общей доступности TPU 8tx и TPU 8i Max. Поэтому их представление нельзя считать открытием свободного подключения к новым системам. Технический выбор уже понятен: защищённые вычисления для чувствительных данных или более плотная конфигурация для длинного контекста. Коммерческие условия ещё предстоит уточнить.
Разницу между классами ускорителей объясняем в справочнике GPU, NPU и TPU. Почему контекст занимает память и как работает KV-кэш, разбираем в гиде по памяти для языковых моделей.