Ускорители ИИ: GPU, NPU, TPU - краткий справочник
Термины, которые встречаются в новостях про железо для искусственного интеллекта, - в алфавитном порядке. Каждое определение - по сути, без рекламных формулировок.
Термины, которые встречаются в новостях про железо для искусственного интеллекта, - в алфавитном порядке. Каждое определение - по сути, без рекламных формулировок.
AI PC
Компьютер с аппаратными и программными средствами для задач искусственного интеллекта. При выборе проверьте, какие функции производитель включает в это обозначение и где они выполняются. Например, класс Copilot+ PC имеет отдельные требования Microsoft: одного нейропроцессорного блока (NPU) недостаточно. Для нужной вам программы уточните поддерживаемое железо, версию Windows и доступность функции. Запуск нейросети на графическом (GPU) или центральном процессоре (CPU) сам по себе не превращает компьютер в Copilot+ PC.
ASIC
Интегральная схема специального назначения: чип, спроектированный под одну задачу и только под нее. Для своей задачи ASIC дает максимальную производительность на ватт площади и энергии, но выполнить что-то другое он не может - гибкость нулевая. Пример: тензорный процессор Google TPU по своей природе является ASIC для нейросетевых вычислений.
FPGA
Программируемая пользователем вентильная матрица: микросхема, логику которой можно перенастраивать после выпуска. Это компромисс между универсальным процессором и ASIC: гибче специализированного чипа, а на малых тиражах и для прототипов - экономичнее его разработки. По скорости и энергоэффективности на конкретную задачу FPGA обычно уступает ASIC, созданному под ту же задачу.
GPU
Графический процессор: массово-параллельный чип с тысячами относительно простых вычислительных ядер. Изначально создавался для графики, затем оказался удобен для любых параллельных вычислений, и именно GPU стали основой обучения больших нейросетей. Современные GPU содержат специализированные матричные блоки для ИИ-операций, но остаются универсальными ускорителями: они считают и графику, и обучение, и инференс.
NPU
NPU (нейропроцессорный блок) выполняет специализированные операции нейросетей. В ноутбуке он нужен программам, которые умеют передавать ему поддерживаемые вычисления: например, обработку изображения с камеры или выполнение локальной модели. Сам факт наличия NPU не означает, что любая ИИ-программа будет его использовать. Нужны совместимые модель нейросети, драйвер и среда выполнения, то есть программа, которая запускает вычисления на выбранном ускорителе. Эти условия Microsoft объясняет в руководстве по доступу к NPU.
Условное изображение вычислительного чипа к разделу об NPU. Иллюстрация создана с помощью ИИ.
Преимущество по энергопотреблению оценивают для конкретной задачи. Сравнивайте одну модель, одинаковые входные данные, качество результата и режим питания. В описании локальной модели Phi Silica Microsoft разбирает различия выполнения на NPU и GPU, включая задержку, расход энергии и использование памяти. Эти условия относятся к указанной реализации. Они не доказывают преимущество любого NPU над любым CPU или GPU.
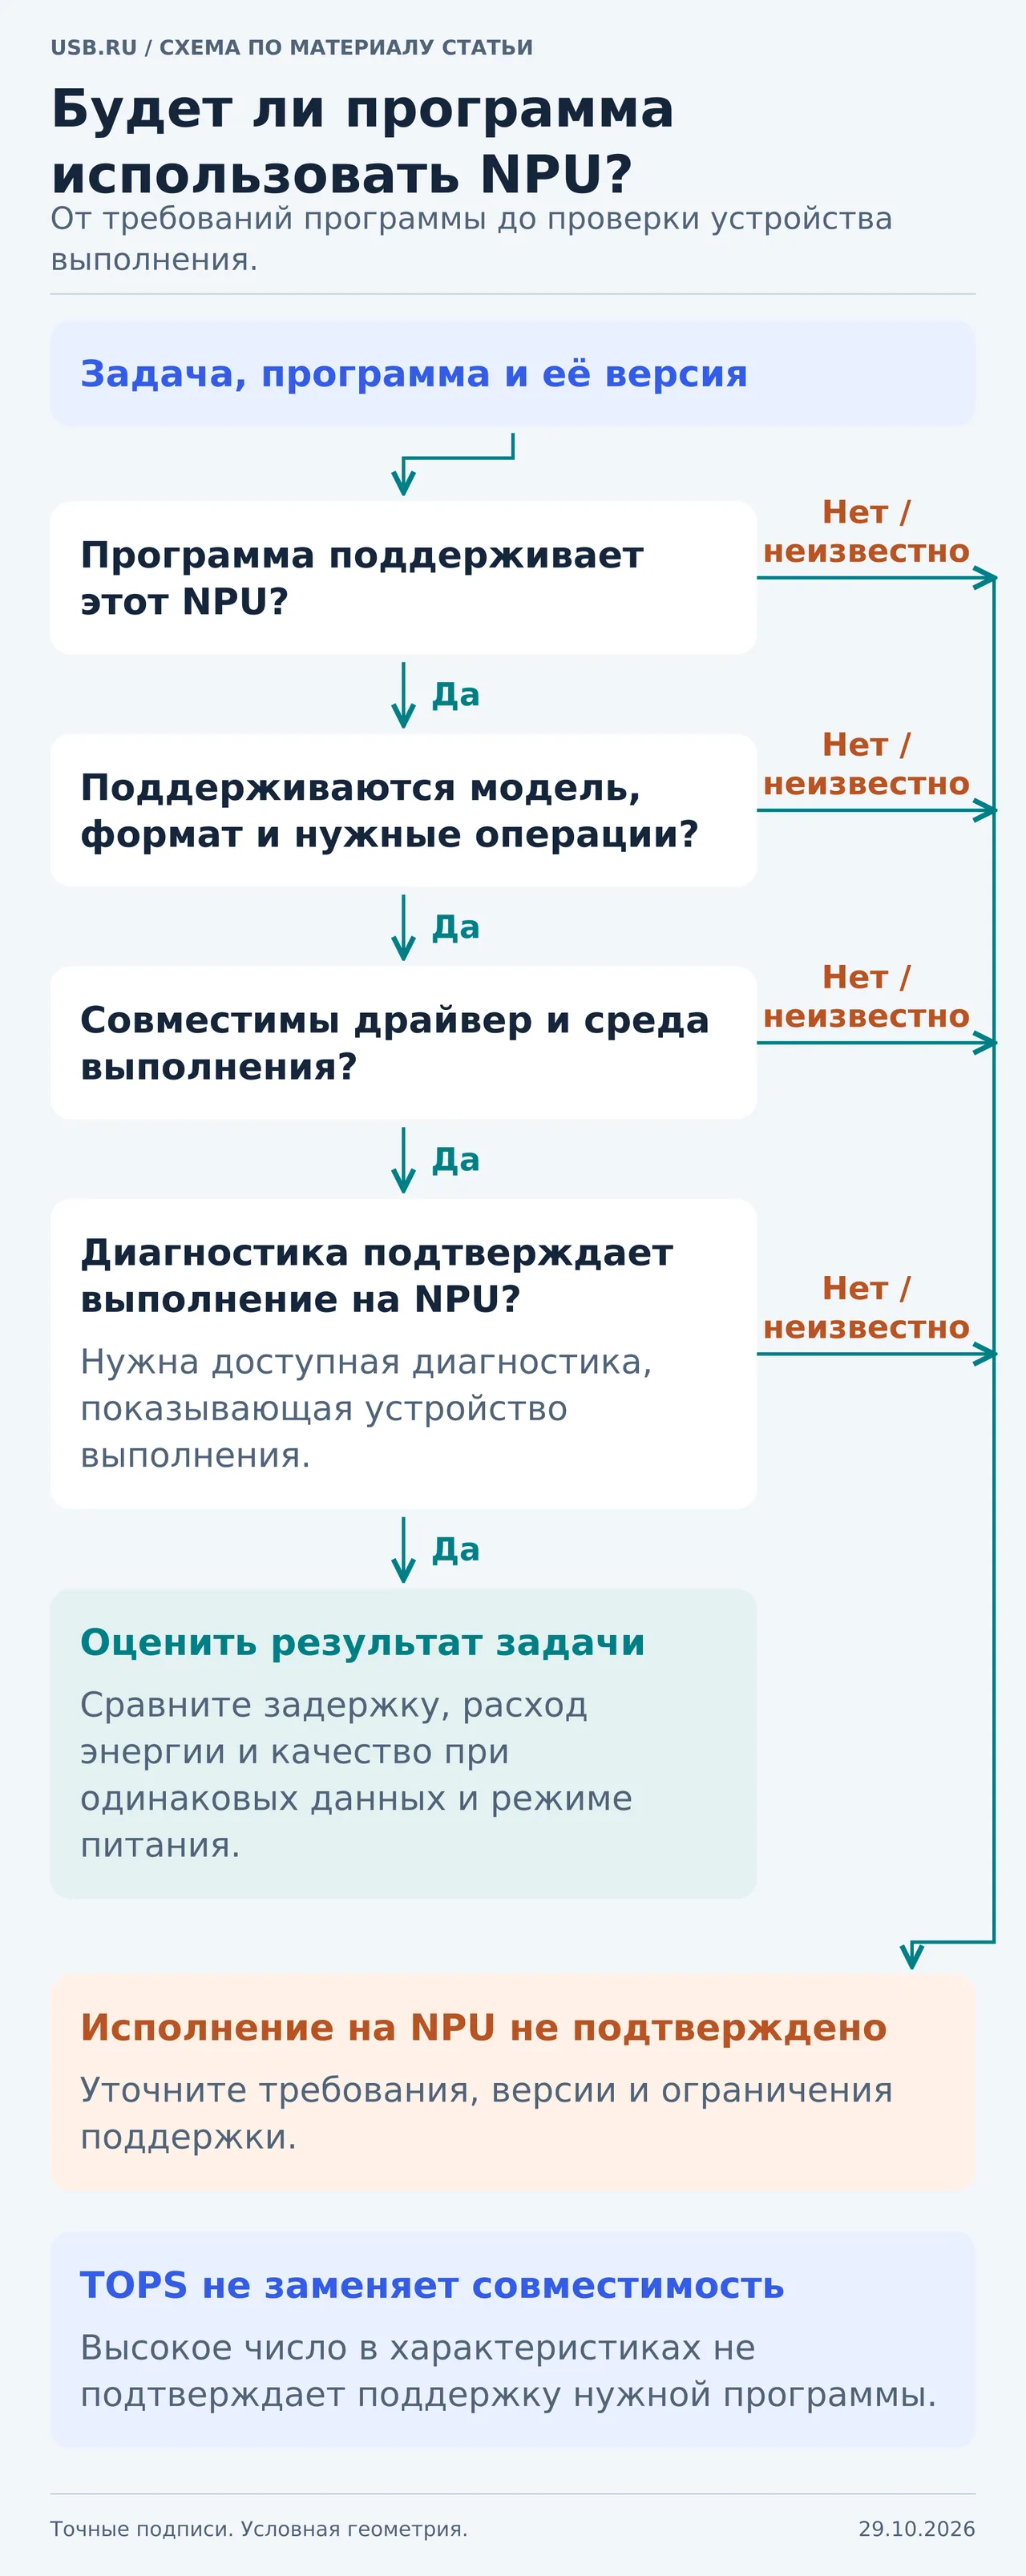
Наличие NPU в компьютере не подтверждает его использование программой. Для подтверждения исполнения нужна диагностика, которая показывает устройство выполнения.
Источники: Copilot+ PCs developer guide, Transparency Note: Phi Silica on Non-Copilot+ PCs, NPU Management Interface, Ryzen AI Software 1.5 documentation.
PCIe / NVLink / UCIe
Три разных интерконнекта - способа соединять вычислительные блоки друг с другом. PCIe - открытый стандарт шины на материнской плате, через него к процессору подключаются видеокарты и ускорители. NVLink - проприетарный интерконнект NVIDIA для прямой связи GPU между собой, с пропускной способностью выше, чем у PCIe; используется в серверных сборках. UCIe (Universal Chiplet Interconnect Express) - открытый стандарт соединения чиплетов внутри одного корпуса (die-to-die). Спецификацию запустил консорциум в марте 2022 года при участии Intel, AMD, TSMC, Samsung, Arm, Google и других компаний; цель - собирать процессоры из чиплетов разных вендоров, как из конструктора.
TOPS
Производительность в TOPS указывают в триллионах операций в секунду. В характеристиках ускорителей это обычно заявленная пиковая производительность для определённого числового формата. Сопоставляйте одинаковый числовой формат, например INT8, 8-битные целые числа, и одинаковые условия учёта операций. Отдельно выясните, указано число для одного NPU или суммарная величина для нескольких блоков.
Разреженные данные содержат много нулевых элементов. При поддержке такого режима ускоритель пропускает соответствующие операции, что меняет заявленный показатель производительности: Intel описывает такую поддержку в документации NPU. Поэтому число для разреженных данных нельзя напрямую ставить рядом с числом для плотных вычислений без пояснения методики.
TOPS не сообщает, насколько верно модель отвечает или сколько секунд занимает ваша задача. Для этого нужны отдельные измерения. Например, документация AMD Ryzen AI описывает отдельные тесты умножения матриц с 8-битными целыми числами (INT8 GEMM), задержки и передачи данных.
| Что проверить | Где искать ответ |
|---|---|
| Работает ли нужная программа на этом NPU? | Список поддерживаемых моделей и устройств, требования программы и среды выполнения |
| Какая точность стоит за TOPS? | Сноска к характеристике ускорителя: INT8, FP16 (16-битные числа с плавающей точкой) или другой формат |
| Учитывает ли показатель разреженность? | Условия измерения с обозначениями dense (плотные вычисления) и sparse (разреженные) |
| Относится число к NPU или ко всей системе? | Раздельные характеристики CPU, GPU и NPU, пояснение к суммарной величине |
| Какой результат получен на практике? | Тест одной модели и задачи с версиями ПО, режимом питания, задержкой и проверкой качества |
Начните выбор с программы, которую собираетесь запускать. Подтверждённая поддержка нужной модели полезнее высокого числа TOPS без условий измерения.
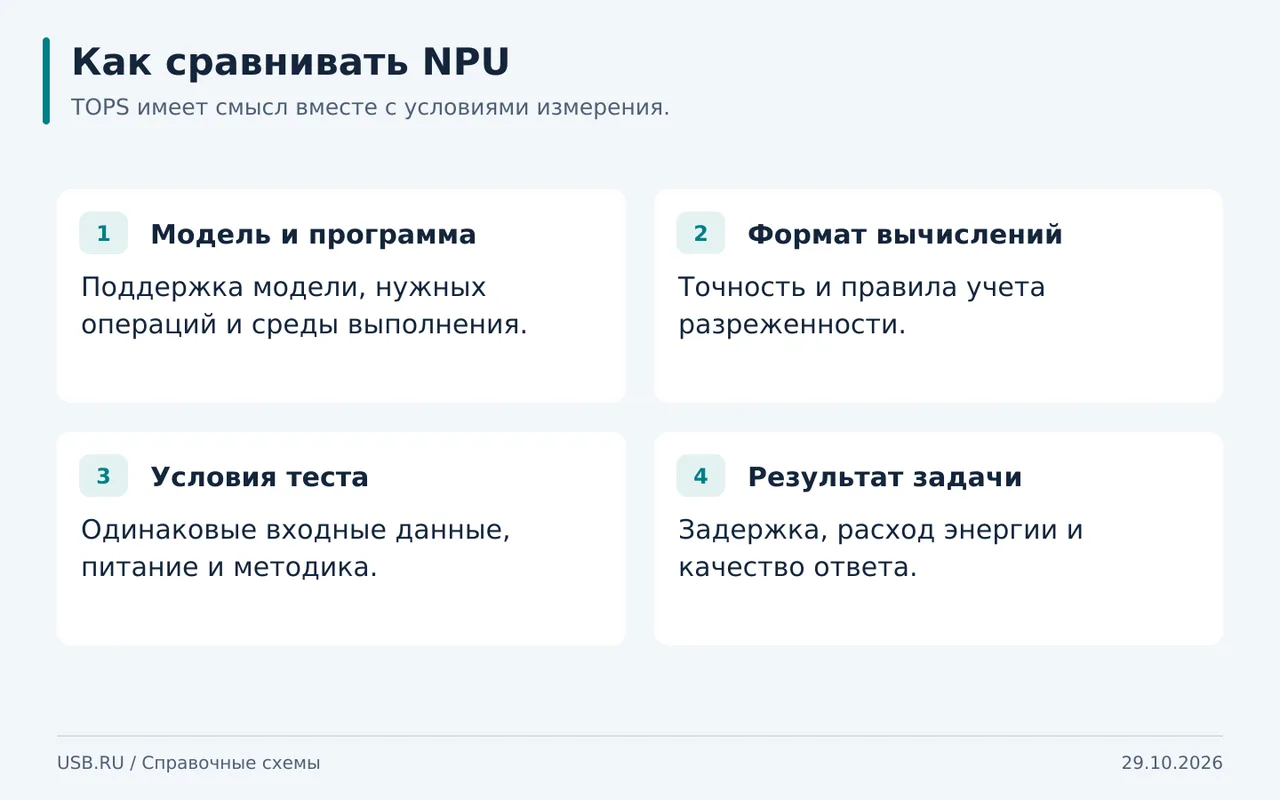
Одинаковая цифра TOPS не описывает задержку ответа, энергопотребление и качество модели.
TPU
Тензорный процессор Google: специализированный ускоритель для нейросетевых вычислений в дата-центрах Google. TPU спроектирован вокруг матричных операций - базовой математики нейросетей - и по архитектуре является ASIC. Существуют и компактные версии для периферийных устройств, например USB-ускорители семейства Coral Edge TPU.
VRAM / HBM
Память ускорителя. VRAM - видеопамять на графической карте: в ней хранятся веса модели и промежуточные данные во время вычислений. HBM (High Bandwidth Memory) - память с очень широким интерфейсом, распаянная рядом с чипом в одном корпусе. Она дает высокую пропускную способность ценой меньшей емкости и более высокой цены и является стандартом для серверных ИИ-ускорителей.
Инференс и обучение
Две стадии жизни нейросети. Обучение - подбор весов модели на больших массивах данных; требует высокой точности вычислений и огромных вычислительных ресурсов, поэтому выполняется в основном на GPU в дата-центрах. Инференс - применение уже обученной модели к новым данным: распознать фото, перевести фразу, дописать текст. Инференс допускает пониженную точность и энергоэффективное железо - от серверных ускорителей до NPU в телефоне.
Квантование
Снижение разрядности чисел, которыми оперирует модель: весов и промежуточных значений. Типичный переход - с 32-битных чисел с плавающей точкой (FP32) на 16-битные или 8-битные целые (INT8). Квантованная модель занимает меньше памяти и считается быстрее, а потеря точности при аккуратном подходе остается небольшой. Именно квантование позволяет запускать большие модели на устройствах с ограниченными ресурсами.
Тензорные ядра / матричные умножители
Специализированные блоки внутри GPU и ускорителей, выполняющие операцию умножения матриц с накоплением - базовую операцию нейросетевых вычислений. В отличие от универсальных ядер, они заточены под эту одну операцию и работают в пониженной точности, за счет чего дают кратный выигрыш в скорости именно на нейросетевой математике. Примеры - тензорные ядра в архитектурах NVIDIA.