AI и дата-центры
Cloudflare раскрыла утечку между клиентами в Workers AI: 155 ответов GLM-5.3 содержали чужие данные
Публикация:
Из-за ошибки в настройке и в движке SGLang 155 ответов модели GLM-5.3 в Workers AI содержали данные из чужих запросов. Затронуты только запросы длиннее 681 280 токенов, проблему исправили 9 сентября.
Cloudflare 26 октября опубликовала разбор инцидента в Workers AI. Из-за ошибки в настройке и ошибки в движке инференса SGLang 155 ответов модели GLM-5.3 содержали данные из чужих запросов других клиентов. Проблема действовала с 27 августа по 9 сентября 2026 года, сейчас она устранена. После исключения собственных тестов Cloudflare и тестов исследователя компания не нашла признаков умышленной эксплуатации.
Что произошло
Затронута одна модель: GLM-5.3 от Z.ai, которую Cloudflare предлагает в Workers AI для агентных задач программирования. Утечка возникала только на очень длинных запросах, больше 681 280 токенов. Такие запросы не получали ошибку: клиент видел связный ответ с кодом 200, но в нём были фрагменты запросов, которые другие клиенты отправили той же модели незадолго до этого. Другие модели Workers AI не затронуты, подтверждает Cloudflare.
О проблеме 8 сентября компании сообщил исследователь Гади Эврон из Knostic через программу HackerOne. На следующий день Cloudflare воспроизвела утечку на двух независимых аккаунтах, объявила инцидент и отключила модель: запросы к ней возвращали ошибку HTTP 400. Исправленную версию вернули в публичный доступ в тот же день, 9 сентября.
- 27 августа: GLM-5.3 запущена в Workers AI, уязвимость присутствует с запуска.
- 8 сентября, 23:11 UTC: отчёт исследователя через HackerOne.
- 9 сентября, 13:22 UTC: инцидент объявлен, утечка воспроизведена.
- 9 сентября, 14:00 UTC: модель переведена в закрытый режим.
- 9 сентября, 19:40 UTC: модель возвращена в публичный доступ.
- 26 октября: совместная публикация с исследователем и командой SGLang.
Две причины
Первая причина в настройке. Модель развернули с контекстным окном 1 048 576 токенов, но пул KV-кэша на GPU, которые обрабатывают запрос (prefill), вмещал только 681 280 токенов. KV-кэш — это память видеокарты, где модель хранит промежуточные данные обработки запроса. Она разбита на страницы, и между запросами страницы не обнуляются: следующий запрос просто перезаписывает их. В Cloudflare знали о таком несоответствии до запуска и ожидали, что движок вернёт ошибку на слишком длинный запрос. Тесты показывали успешные ответы, но проверяли только коды ответов и производительность, а не связность и содержание текста.
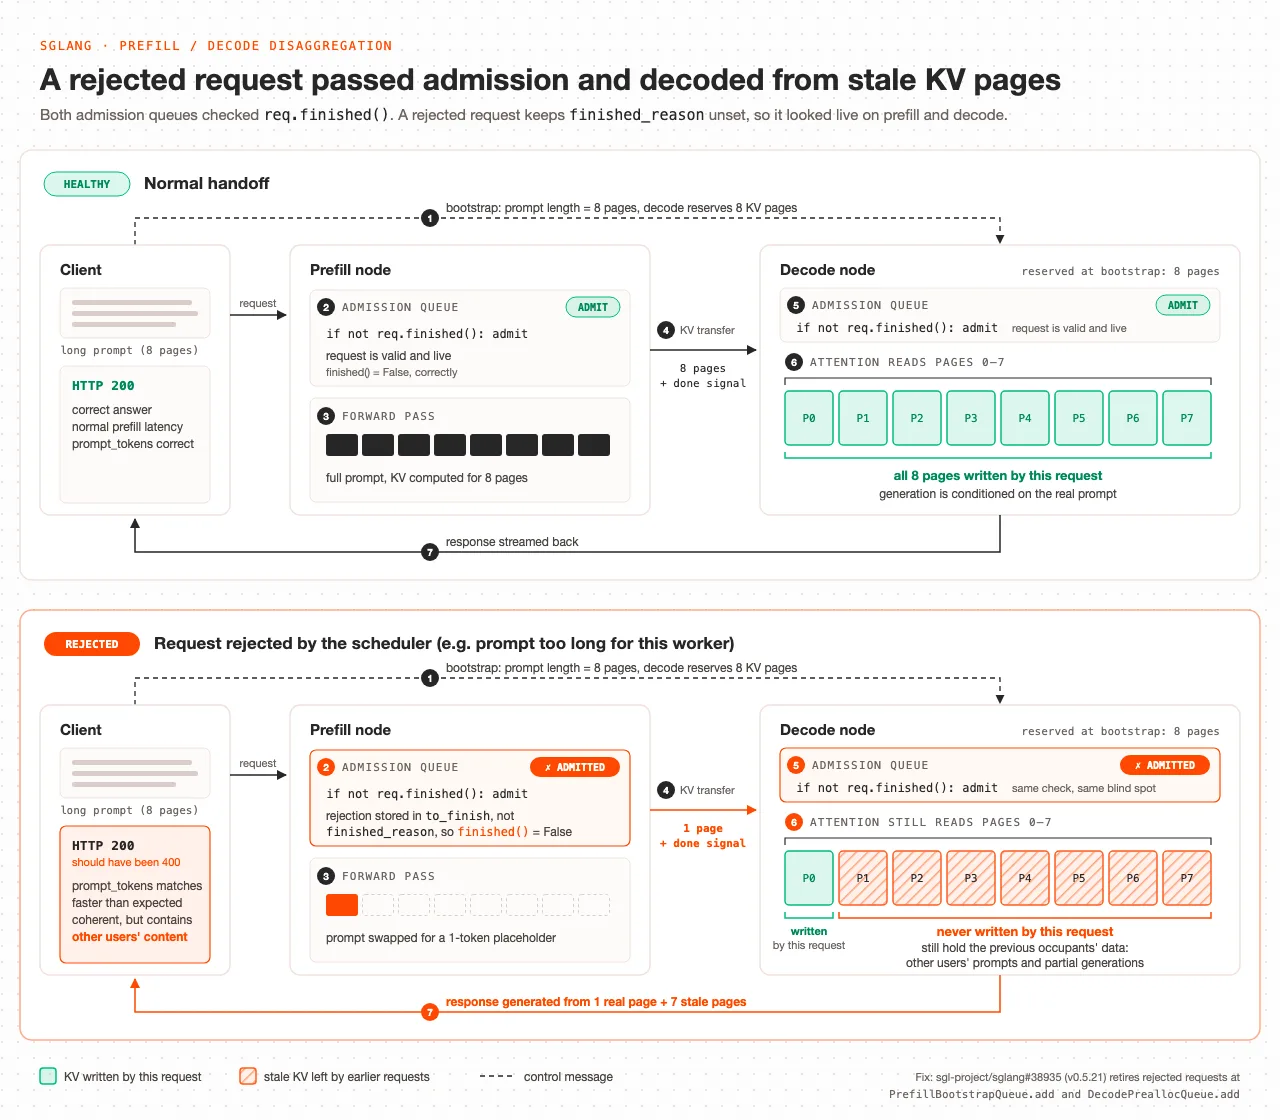
Вторая причина — ошибка в SGLang в режиме, где обработку запроса и генерацию ответа выполняют разные узлы. Слишком длинный запрос движок помечал как отклонённый и подменял его текст заглушкой из одного токена. Но очереди проверяли только, завершён ли запрос, а отклонённый запрос завершённым не считался. Он проходил дальше, узел prefill готовил кэш только для заглушки и передавал одну страницу. Узел генерации заранее зарезервировал под запрос все страницы и счёл передачу полной, поэтому читал остальные страницы, где ещё лежали данные чужих запросов. Вместо ошибки 400 клиент получал ответ с кодом 200.
Масштаб
Всего затронуто 155 ответов, и это именно ответы, а не пользователи: сколько клиентов их получили, Cloudflare называет «небольшим числом». Все 155 ответов относятся к запросам длиннее 681 280 токенов. По времени и объёму такие запросы похожи на обычную работу с длинным контекстом, а не на повторяющуюся попытку воспользоваться ошибкой.
Что исправили
- Пул KV-кэша на узлах prefill увеличили примерно до 2,04 млн токенов, то есть вдвое выше контекстного окна. Теперь любой допустимый запрос помещается в пул, и путь отклонения не срабатывает.
- Движок исправили: отклонённый запрос снимается на входе в очередь с исходной ошибкой, до выделения памяти и передачи кэша.
- Усиление защиты распространили на все промышленные развёртывания SGLang. Перед каждым изменением теперь сверяют размер пула с длиной контекста, проверяют отложенное освобождение страниц и границы пакетов передачи.
- Балансировщик нагрузки больше не прерывает запрос посреди передачи кэша, если клиент отключился.
Что это значит для операторов SGLang
Cloudflare рекомендует всем, кто использует SGLang, обновиться до версии 0.5.22 или новее. Исправление обработки слишком длинных запросов вышло в версии 0.5.20, дополнения вошли в 0.5.21 и 0.5.22. Урок из инцидента компания формулирует так: размер пула кэша не задаётся отдельной настройкой, движок рассчитывает его по оставшейся памяти GPU, поэтому его нужно сверять с длиной контекста напрямую в работающем движке. А при тестах длинного контекста недостаточно смотреть на коды ответов, надо проверять сам текст.
Для обычных пользователей Workers AI вывод узкий: проблема касалась одной модели, периода с 27 августа по 9 сентября и запросов длиннее 681 280 токенов. Cloudflare подтверждает, что другие модели платформы не затронуты.
Другие материалы об ИИ-инфраструктуре и доступе: Vera Rubin NVL72 стали общедоступны в облаке Oracle и Google Cloud представила IAM Helper для управления доступом агентами.