CUDA, ROCm и Metal: совместимость локальных моделей с GPU
Как проверить связку GPU, ОС, драйвера и движка локальной LLM. Отличия CUDA, ROCm и Metal, документированные примеры и диагностика работы на CPU.
Видеокарта видна в системе, но локальная модель загружает центральный процессор (CPU) и отвечает медленно. Причина может быть в движке, программе, которая выполняет модель, или в его вычислительных библиотеках. Отличия CUDA, ROCm и Metal определяют доступный программный путь к графическому процессору (GPU): приложение должно поддерживать вашу платформу вместе с нужными драйвером и ОС.
Разберите цепочку от интерфейса до устройства: какой движок запущен, какие библиотеки он загрузил и какой GPU выбрал. Тогда сообщение об ошибке становится полезной подсказкой. Оно может указывать на недостающий компонент, неподдерживаемую архитектуру или нехватку памяти для выбранного режима.
Разные аппаратные среды для локальных моделей. Поддержка вычислений определяется всей программной и аппаратной конфигурацией.
CUDA, ROCm и Metal: отличия вычислительных платформ
CUDA является вычислительной платформой NVIDIA с инструментами и библиотеками для поддерживаемых GPU этой компании. Важно различать драйвер, набор средств разработки и библиотеки, включённые в готовое приложение. Их версии связаны правилами совместимости, но не обязаны иметь одинаковый номер.
ROCm представляет программную платформу AMD для поддерживаемых ускорителей. В инструкциях локальных движков часто встречается HIP, программный интерфейс для вычислений на GPU. Через него может работать AMD-бэкенд: часть движка, выполняющая расчёты на поддерживаемом оборудовании. Поддержка конкретного Radeon или встроенной графики Ryzen определяется документацией выбранного выпуска и среды.
Metal у Apple является программным интерфейсом (API) для графических и вычислительных задач на платформах компании. Когда движок использует Metal, речь идёт о выполнении через GPU. Наличие отдельного нейросетевого ускорителя Apple Neural Engine не означает, что та же программа автоматически обращается и к нему.
Эти платформы предоставляют разные способы выполнения вычислений. Для сравнения скорости фиксируют модель, формат хранения её обученных параметров (весов), оборудование и задачу. Один из показателей, токены в секунду, описывает число фрагментов текста, которые модель выдаёт за это время.
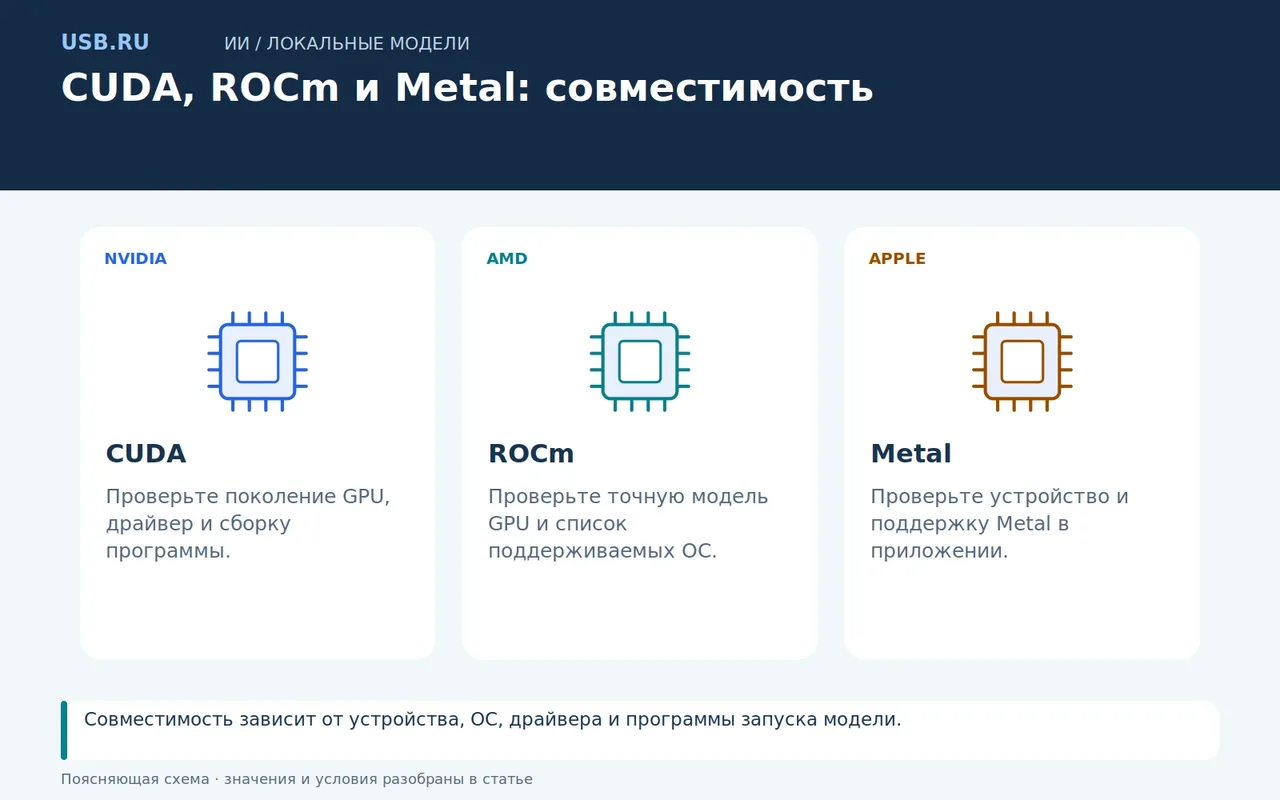
Схема: проверка связки GPU, ОС, драйвера и движка.
Почему совместимость проверяют по точным версиям
Новая версия библиотеки может требовать более свежий драйвер или прекратить поддержку старой архитектуры. Операционная система, ядро Linux, контейнер и способ установки также способны менять условия. Инструкция для Linux не автоматически описывает Windows или WSL, подсистему Linux в Windows.
NVIDIA документирует правила CUDA Compatibility, включая совместимость внутри основных выпусков и отдельные механизмы запуска более нового ПО. Эти правила имеют ограничения. Поэтому совет «просто установите любую последнюю CUDA» не заменяет требований конкретной сборки приложения.
У AMD есть закреплённые требования ROCm 7.2.2 для Linux. В них, например, Radeon RX 7900 XTX указан как поддерживаемый GPU, а допустимые ОС для семейства перечислены отдельно, включая Ubuntu 24.04.4. Здесь намеренно назван конкретный выпуск документации, а не подразумевается вечная поддержка любой новой версии.
Для покупки или обновления сохраните точное название карты и её архитектуру, выпуск ОС, драйвер и версию движка. Если в инструкции написано только «AMD» или «NVIDIA», сведений недостаточно для окончательного вывода о вашей конфигурации.
Что подтверждено документацией на 29 октября 2026 года
Следующие примеры показывают разные уровни совместимости. Каждый отвечает на ограниченный вопрос, после чего остаётся проверить остальные компоненты выбранной системы.
| Документированный вариант | Что подтверждено | Что проверить дополнительно |
|---|---|---|
| llama.cpp с CUDA-бэкендом | В проекте есть сборка с GGML_CUDA=ON |
GPU, версия CUDA и минимальный драйвер сборки |
| Radeon RX 7900 XTX, ROCm 7.2.2, Ubuntu 24.04.4 | Сочетание входит в опубликованные требования AMD | Движок, библиотеки и формат модели |
| llama.cpp на macOS с Metal | В инструкции проекта Metal включён по умолчанию | Требования конкретного выпуска и свободная память |
Руководство сборки llama.cpp описывает CUDA, HIP и Metal отдельно. Наличие исходного кода бэкенда и наличие его в скачанном готовом файле приложения являются разными условиями. Если вы используете графическую оболочку, выясните, какой движок и какую сборку она действительно запускает.
Таблица помогает читать документацию, но не заменяет проверку поддерживаемых операций. Некоторые архитектуры моделей, типы квантования (хранения параметров с пониженной точностью) или отдельные функции могут появляться в движках в разное время. Веса, которые работают в одной программе, не обязаны без изменений запускаться в другой.
Какие модели работают на AMD GPU и других ускорителях
Этот вопрос лучше формулировать через движок. Сначала проверьте поддержку архитектуры модели, затем формата файла и квантования, после этого аппаратного бэкенда. Модель не становится «моделью для AMD» только потому, что её параметры можно разместить в памяти Radeon.
Например, официальная инструкция AMD для llama.cpp связывает сборку программы с соответствующей средой ROCm и отдельно требует подходящий драйвер. В ней описывается запуск моделей в GGUF, формате хранения параметров и сведений о модели. Страница по адресу latest обновляется: для повторения сборки нужно сохранить указанные в ней версии ROCm и llama.cpp, а не подставлять выпуск 7.2.2 из таблицы выше.
Память тоже входит в совместимость рабочего сценария. После весов требуется место для сохранённых промежуточных расчётов и временных рабочих данных. Длинный контекст (вопрос вместе с историей и другими входными данными) или несколько параллельных запросов способны изменить размещение, даже если короткий одиночный запрос работал целиком на GPU.
Если движок умеет частично переносить слои на ускоритель, модель может запуститься при недостатке выделенной видеопамяти (VRAM). Однако скорость такого режима нужно измерять отдельно. Объём общей оперативной памяти и объём выделенной видеопамяти не следует считать взаимозаменяемыми без учёта архитектуры и обмена данными.
Почему модель не использует видеокарту
Начните с журнала запуска. Найдите обнаруженные устройства, выбранный бэкенд, распределение слоёв и сообщения о загрузке библиотек. Если приложение показывает только название GPU в настройках, это ещё не подтверждает выполнение вычислений на нём.
В инструкции AMD команда llama-cli --list-devices используется для обнаружения устройств. Там отдельно подчёркивается, что видимость GPU не доказывает фактический расчёт на нём: затем требуется короткий запуск с моделью и наблюдение за выполнением. Такой порядок применим и как общий принцип диагностики других движков.
Проверьте по очереди:
- Видит ли GPU операционная система и установлен ли нужный драйвер.
- Содержит ли приложение аппаратный бэкенд, соответствующий платформе.
- Находит ли процесс совместимые вычислительные библиотеки.
- Разрешён ли перенос модели на GPU в настройках движка.
- Хватает ли свободной памяти для выбранного контекста и нагрузки.
- Не скрыто ли нужное устройство настройкой среды или контейнера.
Загрузка CPU при работающем GPU сама по себе нормальна: процессору остаются подготовка данных, управление и другие операции. Аналогично малая средняя загрузка GPU не всегда указывает на ошибку, если запрос короткий или вычисления чередуются с ожиданием. Сопоставляйте журналы, память и измеренный ход задачи.
Как проверить исправление и сохранить рабочую связку
Используйте небольшой известный запрос и одну модель, которую поддерживает выбранный движок. Зафиксируйте длину контекста, параметры генерации и число одновременных задач. Не меняйте одновременно драйвер, модель и квантование: иначе будет трудно понять, какое действие помогло.
Сравните первый запуск после загрузки и последующие обращения. Инициализация, подготовка вычислительных программ и чтение весов способны влиять на начальную задержку. Для рабочей оценки отдельно измеряют обработку входа и генерацию продолжения, сохраняя одинаковые условия.
После успешной проверки запишите версии компонентов и параметры запуска. При обновлении меняйте связку контролируемо и оставляйте возможность вернуться к рабочему выпуску. Это особенно полезно для домашнего сервиса, который должен запускаться предсказуемо, а не только один раз после установки.
Если неисправность сохраняется, сообщение разработчику должно включать модель GPU, ОС, драйвер, движок, формат весов и полный текст ошибки без секретов. Такой отчёт позволяет обсуждать конкретную совместимость вместо общего утверждения «ускорение не работает».
Частые вопросы
Для готового приложения всегда нужен полный CUDA Toolkit?
Нет, требования зависят от того, что поставляется вместе с приложением. Набор разработки нужен в одних сценариях сборки, готовая программа может использовать включённые библиотеки. Проверяйте инструкцию её выпуска и требование к драйверу.
Наличие Metal означает использование Neural Engine?
Нет. Metal относится к GPU-вычислениям. Доступ к другим ускорителям требует поддержки соответствующего программного пути.
Любой Radeon поддерживает ROCm?
Нет. Проверяйте точную карту, выпуск ROCm, ОС и ограничения. Возможность запуска неофициальным способом не равна заявленной поддержке производителя.
Можно ли выбрать платформу только по объёму памяти?
Память важна, но без поддержки движка и операций модель может не запуститься. Сначала подтвердите рабочую программную цепочку, затем оценивайте вместимость и производительность.
Перед покупкой видеокарты найдите документированный способ запуска нужной модели на выбранной платформе. Перед обновлением сохраните версии рабочей связки. Эти две привычки сокращают число случаев, когда формально мощный GPU простаивает из-за неподходящего движка или библиотеки.