Data, tensor и pipeline parallel: отличия для LLM на GPU
Как распределяют данные, слои и вычисления модели между GPU. Отличия обучения и инференса, роль AllReduce, памяти, сети и производительности.
Если модель не помещается на одном графическом процессоре (GPU), простое создание второй копии не решит проблему. В data parallel данные распределяются между копиями модели, или репликами. Tensor parallel делит вычисления внутри отдельного слоя, этапа обработки данных. Pipeline parallel размещает последовательные части модели на разных устройствах.
Запуск большой языковой модели (LLM) на нескольких GPU может понадобиться ради памяти или ради большего числа одновременно обслуживаемых запросов. Это разные задачи, и выигрыш измеряется по-разному. До настройки определите, что мешает сейчас: модель не загружается, отдельный ответ слишком медленный или очередь запросов растёт.
Условная многопроцессорная рабочая станция. Способ распределения модели задаёт программа, а не внешний вид плат.
Сначала определите, какую задачу решает распределение
При обучении модель сначала получает предсказание: это прямой проход. Затем вычисляются градиенты, показывающие, как параметры модели влияют на ошибку. Оптимизатор, алгоритм обновления параметров, использует их, чтобы скорректировать веса. В памяти нужны сами веса, промежуточные результаты, градиенты и служебные данные оптимизатора. При инференсе, выполнении уже обученной модели, веса обычно не обновляются. Зато память занимает кеш: сохранённые промежуточные расчёты для продолжения ответа.
Поэтому одна и та же модель может помещаться на GPU для генерации и не помещаться для полного обучения. Число параметров само по себе не задаёт общий объём памяти. Нужны формат хранения, длины последовательностей, размер пакета и конкретная реализация.
| Подход | Что распределяется | Типичная цель | Существенная цена |
|---|---|---|---|
| Data parallel | Разные данные между репликами | Увеличить общий объём работы | Копии весов и обмен при обучении |
| Tensor parallel | Части вычислений одного слоя | Разместить крупные слои и распределить матричную работу | Частые коммуникации |
| Pipeline parallel | Последовательные стадии модели | Разместить модель по глубине | Передача промежуточных результатов, или активаций, и простои стадий |
Таблица описывает базовые формы. Методы разбиения состояния модели и оптимизатора добавляют другие варианты. Например, Fully Sharded Data Parallel (FSDP) распределяет состояние модели между устройствами; это отличается от простой репликации всех состояний на каждом из них.
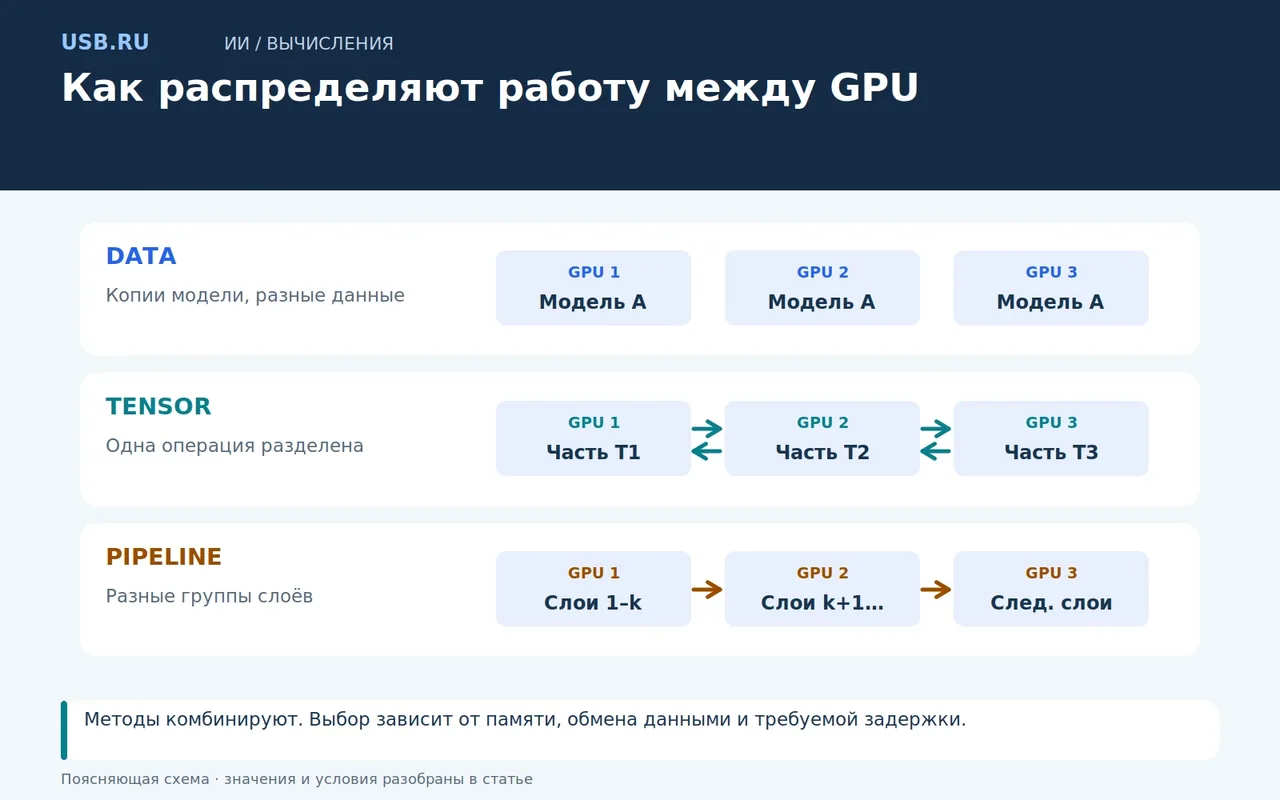
Схема: три способа распределить модель между GPU.
Data parallel: копии модели обрабатывают разные данные
В классическом распределённом обучении каждая реплика получает свою часть пакета. После вычисления градиентов процессы согласуют их и обновляют параметры по одному правилу. Документация Distributed Data Parallel (DDP) в библиотеке PyTorch описывает синхронизацию градиентов и перекрытие части обмена с обратным проходом.
Условный пример: есть пакет из 64 обучающих примеров и четыре устройства с одинаковыми копиями модели. Каждое обрабатывает свою часть из 16 примеров. Это схема распределения пакета, а не утверждение, что обучение обязательно ускорится в четыре раза. Итог зависит от коммуникаций, загрузки данных и доступной вычислительной работы.
Обычная репликация не решает проблему весов, которые не помещаются на одно устройство: каждая копия всё равно должна где-то разместиться. Для уменьшения памяти на GPU применяют разделение состояний, разбиение модели или другие методы с собственными затратами.
При инференсе реплики могут обслуживать независимые запросы. Тогда цель часто состоит в общей пропускной способности и распределении очереди. Это не та же синхронизация градиентов, что в обучении. Каждая такая копия увеличивает число обслуживаемых запросов, но требует памяти под свои веса.
Tensor parallel: один слой работает на нескольких GPU
Tensor parallel разбивает тензоры, многомерные массивы чисел, и вычисления слоя на части. Например, матричное преобразование можно организовать так, чтобы устройства обрабатывали разные блоки, после чего выполняли необходимые коллективные операции, то есть обмены данными с участием всей группы устройств. Точное расположение частей и обменов определяется архитектурой и библиотекой.
NVIDIA в руководстве Megatron Core рассматривает tensor parallel как способ разделения отдельных слоёв и комбинирует его с другими видами параллелизма. Практическая особенность заключается в регулярных обменах внутри вычислительного пути модели.
Представьте, что слой разделён на четыре части. Экономия памяти на весах этого слоя может быть значительной, однако результат ещё нужно передать или объединить в соответствии с алгоритмом. Если сеть медленная относительно вычислений, дополнительные GPU способны долго ожидать друг друга.
Поэтому выбор числа устройств зависит не только от суммы видеопамяти (VRAM). Проверьте поддерживаемую степень разбиения, размеры тензоров и топологию, то есть схему соединений между устройствами. Не всякая модель делится на произвольное число частей без ограничений, а одинаковая паспортная память не делает разные межсоединения равноценными.
Pipeline parallel: слои становятся последовательными стадиями
Pipeline parallel распределяет последовательные участки модели между устройствами. Первое выполняет начальные слои, следующее получает промежуточное представление и продолжает вычисление. В обучении также организуется обратный поток градиентов.
Первичная работа GPipe описывает конвейерное выполнение с разбиением пакета примеров на меньшие порции, микропакеты. Пока одна стадия работает над следующим микропакетом, другая может продолжать предыдущий. Это позволяет заполнять конвейер несколькими порциями работы.
При запуске и завершении конвейера остаются интервалы, когда некоторые стадии простаивают. Дополнительные простои возникают, если стадии несбалансированы: одна часть модели заметно медленнее других. Поэтому равное число слоёв не всегда означает равное время вычислений или одинаковое потребление памяти.
Для одиночной генерации следующий токен, очередной фрагмент текста, обычно зависит от результата предыдущего. Сам факт распределения слоёв не создаёт независимость между этими шагами. Чтобы оценить пользу конвейера, измеряйте нужный режим, включая число одновременных запросов и длины последовательностей.
AllReduce, память и сеть: откуда берутся ограничения
AllReduce объединяет значения от всех участников выбранной операцией и передаёт итог каждому. Например, сумма двух векторов [1, 2] и [3, 4] даёт [4, 6] на обоих устройствах. Такую операцию описывает документация библиотеки обмена данными NVIDIA NCCL.
В обучении результат может использоваться для усреднения градиентов. Но наличие слова AllReduce не определяет весь алгоритм: нужно знать, какие данные объединяются, когда происходит обмен и как он совмещён с вычислениями. В других схемах AllGather собирает части данных у каждого участника, а ReduceScatter объединяет данные выбранной операцией и раздаёт участникам разные части результата. Между стадиями конвейера также передают данные напрямую.
Для больших сообщений важна пропускная способность, для частых небольших обменов существенна задержка. Также учитываются маршруты между GPU, доступ через PCIe, интерфейс связи компонентов компьютера, соединения внутри узла и сеть между узлами. Один медленный участок способен ограничить всю группу.
Суммарная память нескольких GPU не становится автоматически единым прозрачным массивом. Движок должен явно распределить веса, кеши и рабочие буферы. Кроме того, свободная память на разных устройствах может расходоваться неравномерно. Планируйте запас по наиболее загруженному участнику, а не только по общей сумме.
Как выбрать подход для своего сервиса
Начните с одиночного устройства, если модель и нужный объём запросов на нём помещаются. Измерьте время до появления первого токена, скорость продолжения и число обслуживаемых запросов при ожидаемом количестве одновременных клиентов. Это создаёт основу для оценки усложнения схемы.
Если не хватает памяти, проверьте поддерживаемое разбиение модели. Если памяти достаточно, но очередь слишком велика, рассмотрите реплики. В руководстве vLLM по масштабированию выбор tensor и pipeline parallel связывается с размером модели, устройствами и межсоединениями. Конкретная рекомендация зависит от конфигурации, а не только от количества GPU.
Для учебного примера две tensor-группы по два GPU дают две реплики, каждая из которых размещена на паре устройств: всего четыре GPU. Добавление второй реплики прежде всего увеличивает возможность обслуживать разные запросы. Из этой схемы нельзя заранее вывести ускорение одного ответа.
После настройки повторите одинаковую нагрузку и сравните не только среднюю скорость, но и задержки, ошибки памяти и загрузку сети. Сохраните модель, формат весов, длины входа и выхода, число запросов, версии движка и топологию. Только такой набор позволяет воспроизвести результат.
Частые вопросы
Четыре GPU всегда быстрее одной?
Нет. Коммуникации, небольшая задача и дисбаланс могут уменьшить выигрыш. Иногда несколько устройств позволяют лишь разместить модель, которая не помещается на одном.
Data parallel уменьшает память весов на устройстве?
Обычная репликация не уменьшает. Методы разделения состояний являются отдельным усложнением и должны быть явно включены в выбранной реализации.
Для инференса нужен AllReduce градиентов?
В обычной генерации градиенты для обновления весов не вычисляются. При этом коллективные обмены могут требоваться самой распределённой реализации слоёв, поэтому отсутствие обучения не означает отсутствие коммуникаций.
Можно ли свободно смешивать разные GPU?
Это зависит от движка, поддержки оборудования и схемы разбиения. Разная память и скорость создают дополнительные ограничения. Проверяйте конкретную комбинацию и измеряйте её поведение.
Если модель помещается на одном устройстве и задержка устраивает, для растущей очереди имеет смысл сначала оценить реплики. Если памяти не хватает, изучите поддерживаемое разбиение и стоимость обменов. После изменения повторите ту же нагрузку: выигрыш должен проявиться в показателе, ради которого вы добавляли GPU.