Квантовая коррекция ошибок: физические и логические кубиты
Чем логический кубит отличается от физического, как работает surface code и какие показатели проверять в новостях об отказоустойчивых квантовых компьютерах.
Квантовая коррекция ошибок защищает информацию, распределённую по нескольким физическим кубитам, аппаратным элементам для хранения квантовой информации. Полученная защищённая единица называется логическим кубитом. Система регулярно выполняет проверочные измерения, обрабатывает результаты классическим алгоритмом и учитывает обнаруженные ошибки, сохраняя возможность продолжать вычисление.
В заголовке новости написано «сто кубитов». Что за этим стоит: аппаратные элементы, защищённая память или система, уже выполнившая алгоритм? Эти варианты описывают разные достижения. Сравнение потребует данных об операциях, ошибках и доле запусков, вошедших в результат.
Метафора логической структуры, которую поддерживает множество физических элементов. Это не изображение архитектуры квантового процессора.
Что отличает физический кубит от логического
Кубит представляет квантовую единицу информации; при считывании в выбранном режиме получаем один из двух результатов, обозначаемых 0 и 1. Физический кубит реализуют в аппаратной системе: например, в сверхпроводящей схеме или состоянии захваченного иона. Устройство управляет его состоянием и измеряет результат. На процесс влияют окружающая среда, неточность управляющих импульсов, ошибки измерения и взаимодействие с соседними элементами.
Логический кубит описывает защищаемую информацию внутри выбранного кода. Для хранения и проверки этой информации используют физические кубиты данных и вспомогательные кубиты. Поэтому отношение физических кубитов к логическим нельзя считать постоянным коэффициентом. Часть оборудования занята проверками, часть поддерживает соединения и операции. Учебный материал IBM отдельно определяет физические кубиты, логические кубиты, вспомогательные элементы и результаты проверок.
Для читателя практический вывод простой: сначала выясните, что авторы посчитали. Если в одной таблице указаны только кубиты данных, а в другой все элементы процессора, арифметическое сравнение создаст ложное преимущество. Уточните состав системы до обсуждения эффективности.
| Показатель | Что он описывает | Чего из него не следует |
|---|---|---|
| Число физических кубитов | Размер аппаратной системы или её задействованной части | Число доступных защищённых кубитов |
| Число логических кубитов | Объём закодированной информации | Возможность выполнить произвольный длинный алгоритм |
| Ошибка за цикл | Надёжность конкретного цикла проверки | Ошибка всей программы любой длины |
| Ошибка логической операции | Качество указанной операции | Такое же качество остальных операций |
| Доля принятых запусков | Сколько результатов осталось после отбора | Производительность без учёта отброшенных запусков |
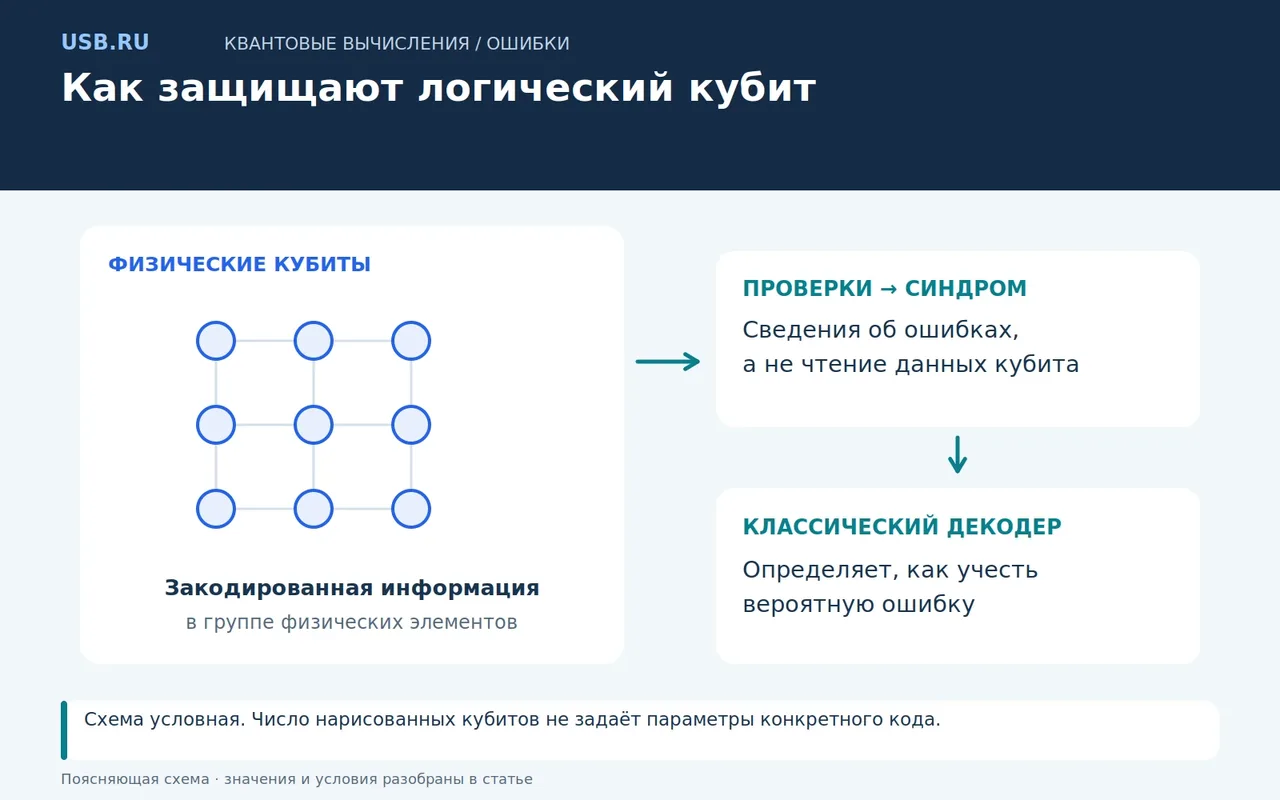
Схема: от физических кубитов через синдром к декодеру.
Почему нельзя просто прочитать и переписать состояние
Обычная проверка значения кубита способна разрушить информацию, которую алгоритм ещё должен использовать. Задача коррекции состоит в получении сведений об ошибке без прямого чтения защищаемого состояния. Для этого измеряют согласованные свойства группы кубитов, а не неизвестное содержимое каждого элемента по отдельности.
Набор результатов таких проверок называют синдромом. Декодер, классический алгоритм обработки результатов, сопоставляет синдром с моделью ошибок и выбирает вероятное объяснение. Результат используют для исправления состояния или изменения классического учёта последующих операций. Последний вариант часто называют обновлением Pauli frame. Физическое применение отдельного исправляющего импульса после каждой ошибки не является обязательным свойством всех реализаций.
Представьте редакционную проверку заявления: «Система обнаруживает ошибку». Следующий вопрос должен звучать конкретнее: что происходит после обнаружения? Если запуск отбрасывают, речь идёт об отборе результатов. Если вычисление продолжают с обработкой синдрома, это другая процедура с другими требованиями. Именно это различие помогает избежать некорректного сравнения.
Surface code: что это и за что приходится платить
Surface code, или поверхностный код, организует проверки на двумерной структуре с локальными взаимодействиями. Такая организация подходит оборудованию, где удобно связывать ближайших соседей. Цена защиты выражается в дополнительных физических элементах, повторных измерениях и работе декодера.
Расстояние кода d показывает, на скольких физических кубитах должна действовать наименьшая ошибка, способная изменить логическую информацию и остаться незамеченной проверками. Увеличение расстояния усиливает защиту при подходящем качестве физических операций, но требует дополнительных ресурсов. Подробную связь геометрии, расстояния и стоимости объясняет курс IBM по коррекции ошибок.
Здесь особенно легко неправильно прочитать формулу. Если авторы приводят количество кубитов данных для одного блока, к этому числу нельзя автоматически приравнивать полный аппаратный бюджет. У другой архитектуры будут свои вспомогательные элементы, маршрутизация и способы выполнения логических операций. Поэтому формула из одного исследования описывает выбранную конструкцию, а не обязательный размер любого квантового компьютера.
Что означает работа ниже порога ошибок
Пороговое поведение отвечает на вопрос: становится ли логическая информация надёжнее при увеличении защиты? Если физические операции слишком неточны, добавленные элементы сами приносят столько ошибок, что ожидаемого выигрыша не возникает. Ниже соответствующего порога увеличение размера кода способно уменьшать вероятность логической ошибки.
В работе Google Quantum AI о Willow авторы исследовали квантовую память на поверхностном коде. Для конфигурации с расстоянием 7 они указали 49 кубитов данных, 48 измерительных и 4 дополнительных кубита удаления утечек и ошибку (1,43 ± 0,03) × 10⁻³ за цикл коррекции. При увеличении расстояния на два ошибка снижалась с коэффициентом 2,14 ± 0,02. Это результаты конкретного эксперимента, опубликованного онлайн 9 декабря 2024 года, а не универсальные характеристики технологии. Первичная публикация в Nature содержит методику и условия измерений.
Смысл примера заключается в проверенной тенденции масштабирования. Из него не следует, что любой процессор такого размера обладает такой же надёжностью. Нельзя также перенести ошибку памяти за цикл на ошибку произвольной программы. Для такого вывода понадобились бы дополнительные измерения операций и всей последовательности вычисления.
Чем защищённая память отличается от отказоустойчивого компьютера
Хранение состояния, выполнение одной логической операции и запуск полноценного алгоритма представляют разные задачи. Для полезного вычисления нужно подготовить состояния, провести нужные операции, обработать ошибки на протяжении работы и получить результат с заданной достоверностью.
Важна скорость классической части. Проверки производят поток данных, который декодер должен успевать обрабатывать. Также требуется устойчивость параметров во времени. Объяснение Google Research связывает результат эксперимента с дальнейшими требованиями к масштабированию и вычислениям.
При оценке заявления об отказоустойчивом квантовом компьютере составьте короткую карточку. Запишите размер защищённой системы, поддерживаемые логические операции, длительность работы, ошибку выбранной задачи и затраты на обработку. Если доступен лишь один показатель, описание результата должно оставаться таким же узким. Например, результат хранения состояния ещё не показывает, с какой ошибкой система выполнит последовательность логических операций.
Как проверить новость о квантовой коррекции ошибок
Начните с первичной статьи и её исправлений, если они опубликованы. Затем найдите раздел, где авторы определяют метрику. Ошибка за цикл, ошибка считывания и доля неуспешных программ измеряют разные события. Проверьте, одинаковы ли условия у сравниваемых систем.
Отдельно изучите постселекцию, то есть отбрасывание запусков по результатам проверок. Высокая точность оставшихся результатов полезна, но для оценки стоимости нужны исходное число запусков и доля принятых. Если статья сообщает только качество после отбора, не превращайте этот результат в утверждение о производительности без отбора.
Наконец, отделите продемонстрированное от запланированного. Прототип памяти, оценка ресурсов будущего алгоритма и дорожная карта производителя относятся к разным видам доказательств. В собственной таблице достаточно трёх колонок: «измерено», «рассчитано при допущениях», «запланировано». Такая запись сохраняет смысл исследования без необоснованного прогноза даты появления готовой машины.
Частые вопросы
Сколько физических кубитов нужно для одного логического?
Единого числа нет. Ответ зависит от кода, качества операций, требуемой ошибки и состава учитываемого оборудования. Просите параметры конкретной конфигурации вместе с методикой подсчёта.
Surface code полностью устраняет ошибки?
Он уменьшает вероятность логической ошибки при определённых условиях. Конечная система сохраняет ненулевой риск, поэтому разработчики задают допустимую ошибку всей задачи и подбирают ресурсы под этот бюджет.
Достаточно сравнить число логических кубитов?
Нет. Дополнительно нужны операции, глубина вычисления (число последовательных слоёв операций), точность и стоимость получения результата. Логическая память и система, выполняющая алгоритм, не становятся сопоставимыми из-за одинакового числа в названии.
Почему используют классический декодер?
Результаты измерений синдрома представляют классические данные. Алгоритм обрабатывает их и определяет, как учесть вероятную ошибку при продолжении вычисления.
Что проверить перед следующим сравнением
Вернувшись к новости о ста кубитах, найдите три вещи: тип кубитов, измеренную ошибку и выполненную задачу. Если авторы показали защищённое хранение состояния, так и запишите. Если выполнили алгоритм, сохраните его параметры и результат. Сравнение начинается с совпадающей задачи, а число кубитов объясняет, каких ресурсов она потребовала.