Новости ИИ за неделю: Kimi K3.1 раздала веса, Gemini Omni снимает по 15 секунд, а GPT-6 Astra подтянула чужой модели математику
Главное в ИИ за первую неделю ноября: открытые модели на сотни миллиардов и триллионы параметров, видео Gemini Omni и картинки OpenAI, голосовой режим Muse, роботы, обученные в симуляции, и 3D-сцены по одной фотографии.
Первая неделя ноября выдалась щедрой на открытые модели. Moonshot выложила веса Kimi K3.1 Pro, Thinking Machines показала Inkling 2 Small, а маленькая лаборатория Ricursive обучила свою модель с нуля за деньги, которые по меркам индустрии выглядят скромно. Google сделала ролики Gemini Omni длиннее и дешевле, OpenAI научила генератор картинок делать GIF. Самая странная история недели пришла из MIT: там GPT-6 Astra улучшила маленькую языковую модель, ни разу её не обучая.
Триллионы параметров теперь можно скачать
 Inkling 2 Small. Изображение: Thinking Machines
Kimi K3.1 Pro теперь можно скачать с Hugging Face. Это смесь экспертов на 2,8 трлн параметров, из которых на каждый токен работают 104 млрд. Лицензия у неё собственная, Kimi K3.1 Pro License, так что перед тем, как строить на ней продукт, условия лучше прочитать целиком.
Inkling 2 Small от Thinking Machines маленькой можно назвать только в сравнении со старшими моделями: 594 млрд параметров, из них 17 млрд активных. Пока с ней работают через платформу Tinker, где модель можно попробовать и дообучить. Полные веса под лицензией Apache 2.0 компания обещает выложить после внешних тестов безопасности.
У Ripple-65B самое интересное в бюджете. Ricursive обучила плотную модель на 65 млрд параметров с нуля и оценивает всю разработку в $32 млн, включая эксперименты, данные и отладку. Модель изначально делали для собственной платформы проектирования чипов, а наружу выпустили её универсальную версию со статусом Preview.
Baidu опубликовала ERNIE 5.5 Flash Base: 280 млрд параметров, из которых активны 14 млрд. Это базовая модель сразу после предобучения, без настройки на диалог. Она нужна тем, кто будет доучивать её под свои задачи, а для чата лучше подождать готовых версий.
Для науки вышла Hydrogen-1.0 от Deep Principle. Её построили на GLM-5.3 и дообучили на данных по химии, материаловедению и наукам о жизни, а также на записях из собственных лабораторий компании. По замерам разработчиков, на тесте FrontierScience-Research модель обходит GPT-6 Astra.
Часть громких моделей недели пока работает только через API. Meituan выпустила LongCat-2.5 на 1,6 трлн параметров для долгих агентных задач, веса на GitHub и Hugging Face обещаны позже. Tencent показала Hy4: это первая модель Hunyuan, которая понимает изображения и управляет компьютером. MiniMax M3 с контекстом в 1 млн токенов тоже ждёт публикации весов. Ant Group выпустила мультимодальную Ling 3.2 Flash на 560 млрд параметров с 25 млрд активных, но про открытые веса в её документации ничего не сказано.
Видео Gemini подешевело, а картинки OpenAI научились двигаться
 Примеры P-H3 Image. Изображение: Pruna AI
Google выпустила Gemini Omni 1.2 Flash. Ролик теперь может длиться до 15 секунд, а у версии 1.1 предел был 10 секунд. Длину задают с шагом в одну секунду, минимум три. Видео можно править в несколько заходов прямо в диалоге, не генерируя всё заново. Цена снизилась на 30%: секунда видео в 720p стоит $0,07.
OpenAI обновила генератор изображений до Images 2.6. Он научился делать GIF-анимации. По словам OpenAI, новая версия лучше держит персонажа и детали бренда, когда сцену меняют несколько раз подряд, а генерация стала на 50% быстрее. В API доступны два варианта, Flare и Sunburst.
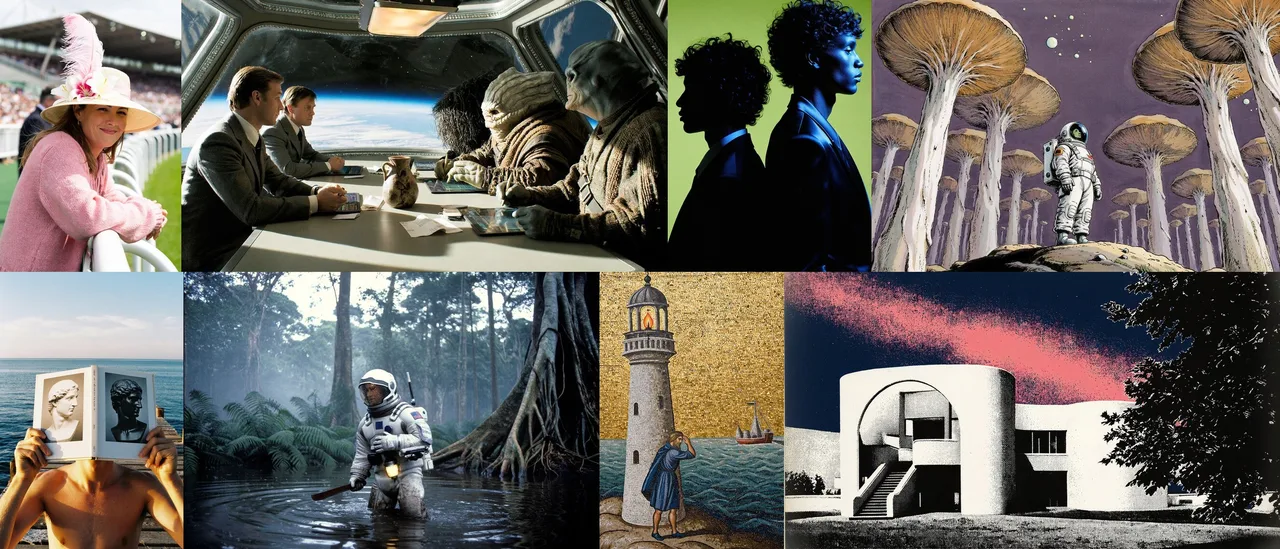
Открытых генераторов тоже прибавилось. Pruna переделала видеомодель MiniMax-H3 в генератор и редактор картинок P-H3 Image. Шагов генерации стало 8 вместо 50, и картинка на 4 мегапикселя на одном B200 получается за 2,6 секунды. Перед тем как скачивать, стоит прочитать лицензию MiniMax H3 Community: для ЕС, Великобритании, Южной Кореи и США без отдельного соглашения она не действует.
Linum посчитала, во что обходится своя модель. PJiT на 2 млрд параметров обучили с нуля примерно за $21 тыс. Она работает напрямую с пикселями, без VAE, и выложена под Apache 2.0. Писать текст на картинках она не умеет: обучающую выборку собирали без изображений, где много текста.
Ещё два открытых проекта для тех, кто работает с картинкой локально. NitroFusion 2 сокращает генерацию изображения до одного или двух шагов. RelayVSR повышает разрешение видео: большая генеративная модель готовит опорные ключевые кадры, а лёгкая по ним обрабатывает всё видео. На одной A100 он выдаёт 29,29 кадра в секунду при 1080p.
ИИ обучает ИИ: GPT-6 Astra подтянула маленькой модели математику без тренировки
 Три эксперимента: прочитать, починить, улучшить. Изображение: MIT CSAIL
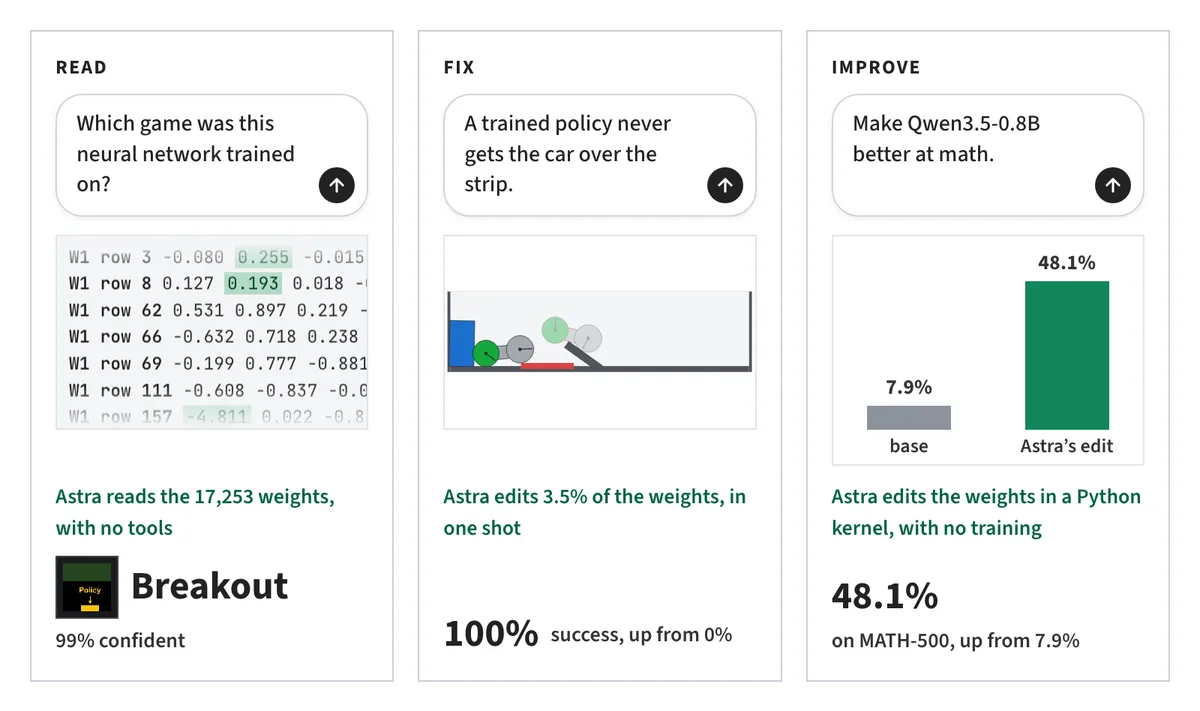
Рикия Такэхи, Джейден Тео, Алекс Чжан и Омар Хаттаб из MIT CSAIL дали GPT-6 Astra веса других нейросетей и попросили разобраться, как те устроены, а потом исправить. Градиентов и циклов обучения не было. Astra рассуждала о том, что вычисляет каждая часть сети, и переписывала нужные веса.
Начали с простого. По 17 253 сырым весам Astra определила, что сеть училась играть в Breakout, и была уверена в ответе на 99%. Потом ей дали сеть, которая управляла машинкой и никак не могла перебраться через полосу на трамплине. Astra поменяла 3,5% весов с первой попытки, и машинка прошла уровень во всех 1024 попытках.
Главный результат касается Qwen3.5-0.8B. Astra изменила 0,016% весов, и доля решённых задач MATH-500 выросла с 7,9% до 48,1%. Заодно втрое подрос результат на IFEval, тесте на следование инструкциям.
У такого скачка простое объяснение. Astra нашла в весах причину, из-за которой Qwen зацикливалась в рассуждениях, и об этой проблеме предупреждает сама карточка модели. Правка убрала именно эту поломку. В другом опыте Astra отличила «подхалимскую» копию Gemma 3 270M от честной во всех трёх парах, но для этого ей разрешили запускать обе модели на собственных текстах.
С ассистентом Meta теперь можно просто поговорить
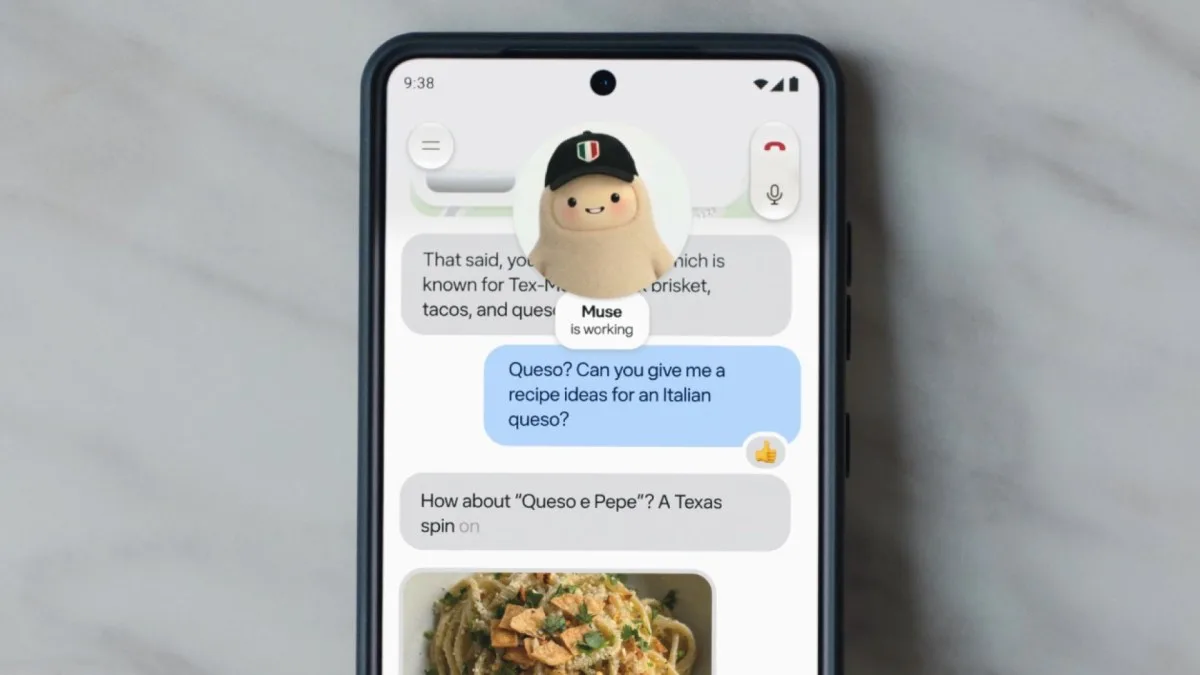 Голосовой режим Muse. Изображение: Meta
Meta добавила в приложение Muse голосовые разговоры и выразительные аватары. Ассистента можно перебить, как живого собеседника, а голос выбрать из сотен вариантов. Аватар отвечает мимикой и жестами, его можно держать рядом с чатом или развернуть на весь экран. Пока функция появилась только в США, в приложении для телефона, в вебе и на Mac.
Похожую идею развивает MOSS-Live от шанхайской компании Mosi. Ассистент слушает и говорит одновременно, по смыслу понимает, перебили его или просто поддакнули, и видит экран или камеру. Разговор ведёт одна модель, а долгие задачи и вызовы инструментов уходят фоновой, так что беседа не прерывается. Попробовать MOSS-Live можно в онлайн-демо или через API.
Роботы учатся в симуляции, а погоду считает нейросеть
 ZAP на реальном роботе. Изображение: Luma AI
Команда Luma AI описала ZAP, модель для управления роботом, которую обучали только в симуляции. За основу взяли Qwen 3.6 27B и научили её двигать манипуляторы на 40 виртуальных задачах, без единой записи с настоящего робота. На реальном двуруком роботе ZAP справилась с 97% заданий, это уровень GPT-6 Astra. При этом она в 3 раза быстрее и в 17 раз дешевле: 146 секунд против 397 и $0,29 против $4,87 на задачу. Препринт вышел в октябре.
NVIDIA выложила на Hugging Face веса STRATA, глобальной модели атмосферы. Она имитирует физическую симуляцию SCREAM на сетке с шагом около 4,9 км и считает состояние атмосферы шагами по 10 минут, а параметров у неё всего 331,7 млн. Код и рецепты обучения доступны под Apache 2.0, а сами веса распространяются по лицензии OpenMDW 1.1. Ещё NVIDIA открыла четыре модели мира Cosmos 3 Nano для симуляции вождения и роботов.
Для тех, кто собирает роботов сам, появился набор открытых библиотек OpenRoboKit: RoboKit для оптимизации, RetargetingKit для переноса движений, GraspKit для манипуляций и RoboSkills с навыками для ИИ-агентов. FlowHMR восстанавливает физически правдоподобное 3D-движение человека по обычному видео, и авторы переносят его на гуманоида Unitree G1. DreamX от KAIST и NVIDIA учится переносить движения из видео с людьми на роботов, код пока обещают выложить позже.
Самую компактную модель недели выпустила Cactus. Mirage на 51,3 млн параметров после 2-битного квантования занимает около 22 МБ. На NPU смартфона Galaxy S26 она за 74 мс описывает сцену, находит объекты, читает текст и строит маски.
Одна картинка, и готова 3D-сцена
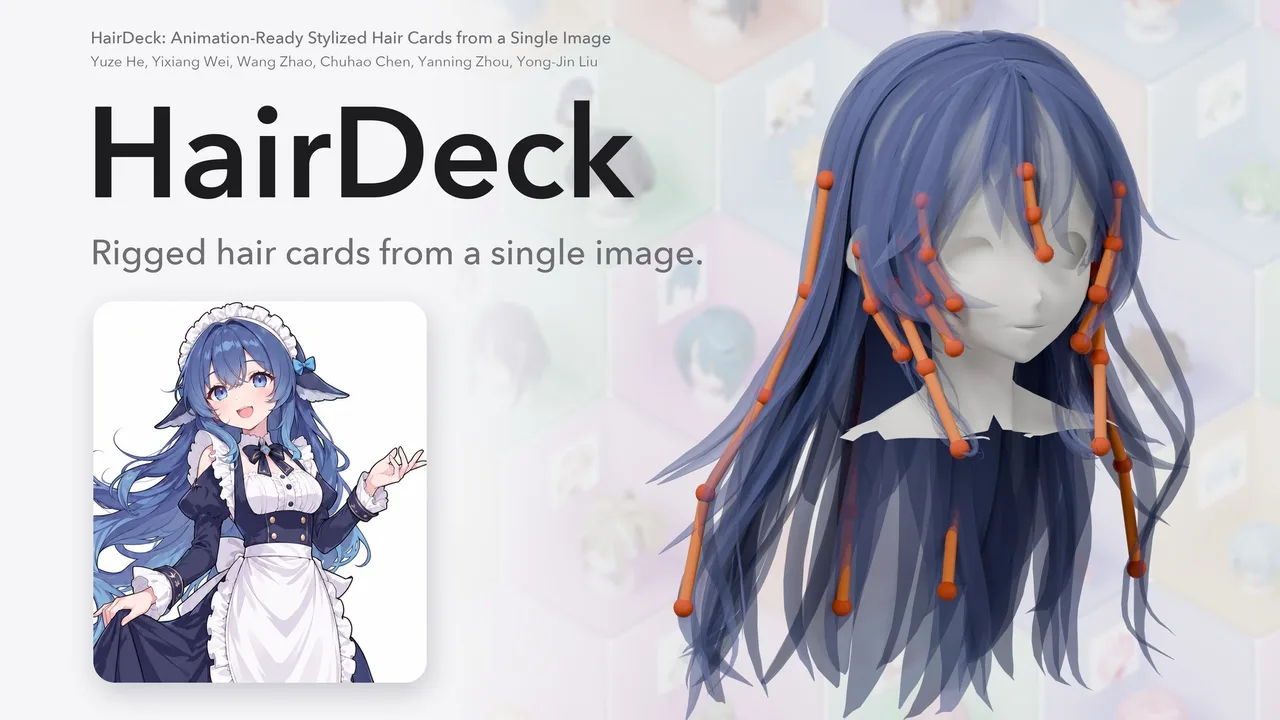 HairDeck: причёска для анимации по одному рисунку. Изображение: авторы HairDeck
HairDeck от исследователей Университета Цинхуа, Университета Карнеги-Меллон и Китайского университета Гонконга делает из одной картинки персонажа причёску, готовую к анимации. Пряди собираются из карточек с цепочками пружинных костей, а результат экспортируется в аватар VRM. На тестовом наборе CHARM ошибка геометрии на 44% ниже, чем у самого CHARM, а работает HairDeck в 33 раза быстрее.
Lucid Lyra из лаборатории NVIDIA превращает одно изображение в 3D-сцену, в которой модель различает отдельные объекты и понимает, что это за предметы, код обещают позже. CoLa3D из Жэньминьского университета и NTU за один проход раскладывает сцену на отдельные 3D-модели, вдвое быстрее, чем при генерации по объектам, и код уже выложен. VoxLution из Мюнхенского технического университета генерирует обставленные комнаты, уточняя воксели с 25 см до 1,5625 см.
Ещё две работы про движение. ReLift от Техниона и NVIDIA восстанавливает 3D-траектории точек на видео, в том числе пока объект скрыт за другими. Möbius одной моделью генерирует движения человека по тексту, описывает их словами, дополняет и редактирует.
Что ждать дальше: Thinking Machines обещает открыть веса Inkling 2 Small после проверки безопасности, у LongCat-2.5 и MiniMax M3 публикация весов тоже стоит в планах. Прошлый выпуск обзора лежит здесь.