AI и дата-центры
Ricursive выпустила Ripple-65B: открытая модель на 65 млрд параметров обходит гигантов в коде
Публикация:
Лаборатория из пяти человек обучила языковую модель с нуля за $32 млн, а на тесте Terminal-Bench 2.1 она набрала 80.52 и обошла открытые модели на 501-975 млрд параметров.
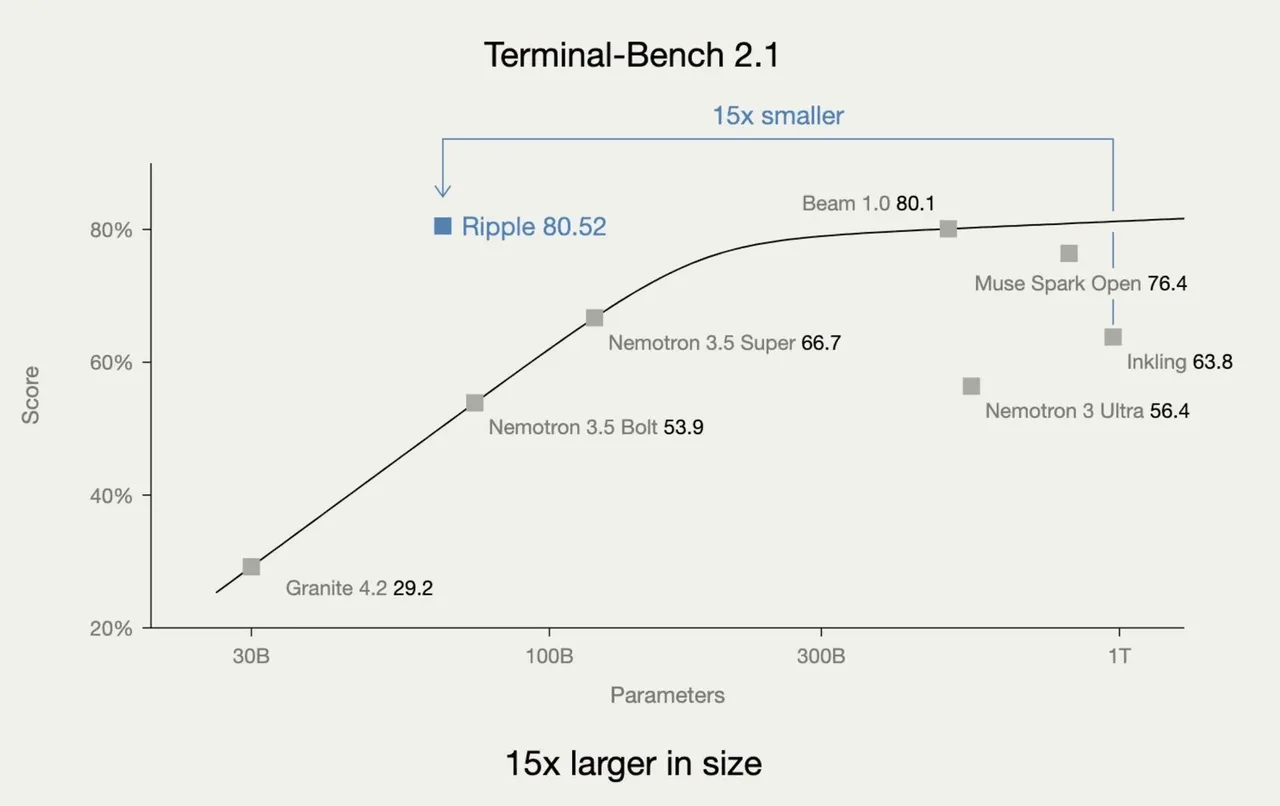
4 ноября Ricursive Intelligence выпустила Ripple-65B Preview, открытую языковую модель на 65 млрд параметров. Компания обучала ее с нуля на 12 трлн токенов, а веса лежат на Hugging Face под лицензией Apache 2.0. Контекст модели, до 1 млн токенов. Это общая версия внутренней модели, на которой работает платформа проектирования чипов Ricursive, и первый публичный релиз лаборатории.
Главный результат компания ставит в тест Terminal-Bench 2.1: 80.52, лучший показатель среди открытых моделей из США. Ближайший соперник, Reflection Beam 501B, набирает 80.1, дальше идут Muse Spark Open 816B с 76.4, Thinking Machines Inkling 975B с 63.8 и NVIDIA Nemotron 3 Ultra 550B с 56.4. Meta Platforms Inc. включена в перечень организаций, признанных в Российской Федерации экстремистскими; её деятельность по реализации Facebook и Instagram запрещена в РФ. Все цифры пока только от самой Ricursive: независимых замеров к 5 ноября не было.
Отдельная строка анонса, это цена разработки. Ricursive пишет, что потратила на модель $32 млн от начала до конца, включая данные, обучение и отладку, и называет это десятой частью затрат прошлого лидера среди открытых моделей в агентском коде. Набор из 1.4 млн роллаутов в обучении с подкреплением дал тот же результат, что у Reflection Beam, при этом, по словам компании, примерно в 70 раз меньше попыток. Архитектура плотная, а не смесь экспертов: 80 слоёв, ширина скрытого слоя 5,120, все 65 млрд параметров работают на каждом токене.
По остальным тестам картина смешанная, и карточка модели этого не скрывает. На SWE-bench Pro v2.0 Hard Ripple набирает 79.1 против 76.5 у Beam, а на SWE-bench Verified уступает: 76.5 против 81.6. На задачах со знанием модель уступает лидерам на несколько пунктов. Зато плотная архитектура дает 250 токенов в секунду на двух ускорителях B200 и позволяет запускать модель на одной рабочей станции вроде NVIDIA DGX Spark. Веса доступны на Hugging Face, а по API модель отдают Together AI, GMI Cloud, OpenRouter и Fireworks. Из нашей ленты по теме: открытая модель MiniMax и семейство NorthCUA.