AI и дата-центры
Meituan выпустила LongCat-2.5: модель на 1.6 трлн параметров для долгой агентной работы
Публикация:
Модель понимает картинки и текст в едином потоке токенов, работает с кодовыми базами целиком и уже доступна в чате и API, а веса на GitHub и Hugging Face пока только обещаны.
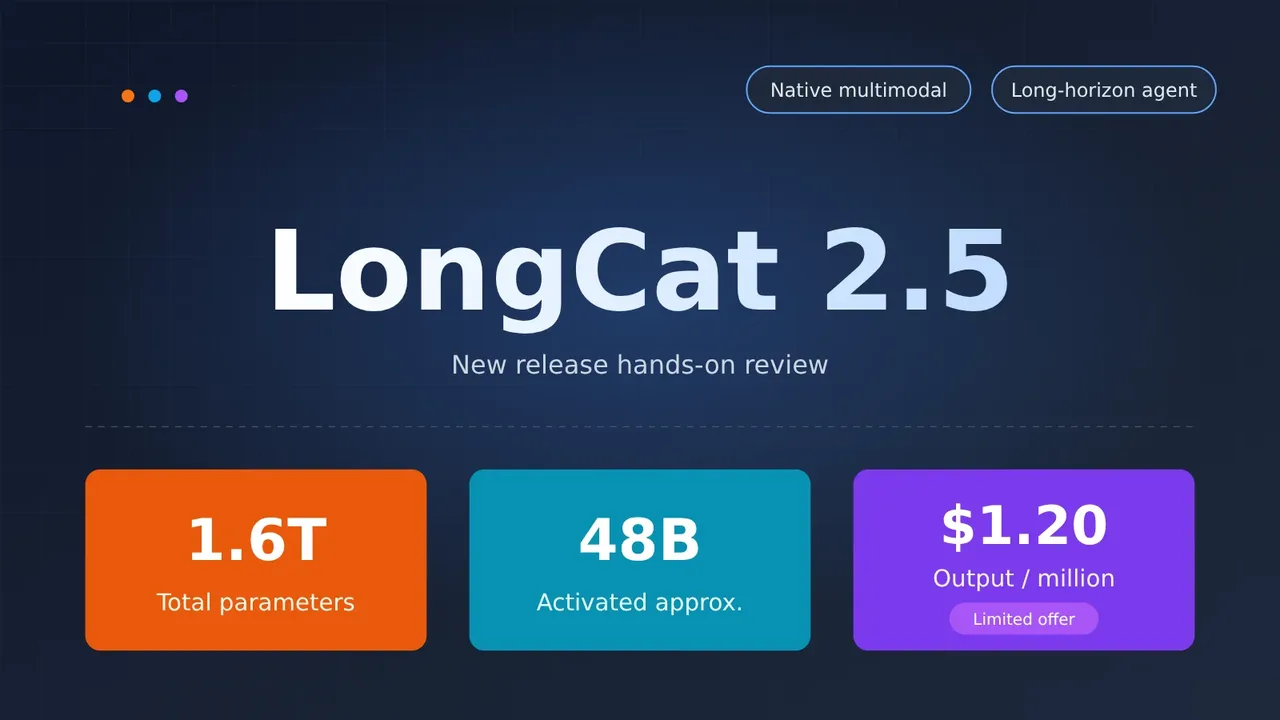
Meituan выпустила LongCat-2.5, нативную мультимодальную модель для долгих агентных задач: правка сложных кодовых баз и сборка целых проектов вместо разовых подсказок. Модель уже доступна в чате longcat.chat и через API, а выход весов на GitHub и Hugging Face пока только обещан.
Масштаб модели: 1.6 трлн параметров всего и около 48 млрд активных на токен. Контекст составляет 1 млн токенов, а выход ограничен 128 тыс. токенов. Картинки превращаются в дискретные токены на нескольких уровнях детализации и обрабатываются той же основой, что и текст, отсюда визуальный кодинг, дизайн и 3D-задачи.
Обучение строилось на длинных последовательностях действий с подкреплением, а неудачи реальных агентов превратили в воспроизводимые учебные задачи. По собственным замерам компании, LongCat-2.5 набирает 88.4 на Terminal Bench v2.1 против 70.8 у LongCat-2.0, 51.8 на AutomationBench против 15.8 и 91.9 на BrowseComp. На Program Bench у модели 25.5, и в той же таблице компании это ниже лучшего результата 37. Независимой проверки этих цифр пока нет.
Цены по ограниченной скидке: вход 0.30 доллара за 1 млн токенов, кэшированный вход 0.006 доллара, выход 1.20 доллара. Инференс сжат до W4A4, а обучение шло на отечественных китайских ускорителях. Поддержка Claude Code, Codex и Hermes уже заявлена.