ИИ-инфраструктура
OpenAI улучшила схемы GPU AMD: до 14% по PPA менее чем за пять месяцев
Публикация:
Модели переписывали уже тщательно оптимизированное описание схем. Часть изменений AMD отправила в производство, а результаты на чипе Jalapeño проверили на кремнии.
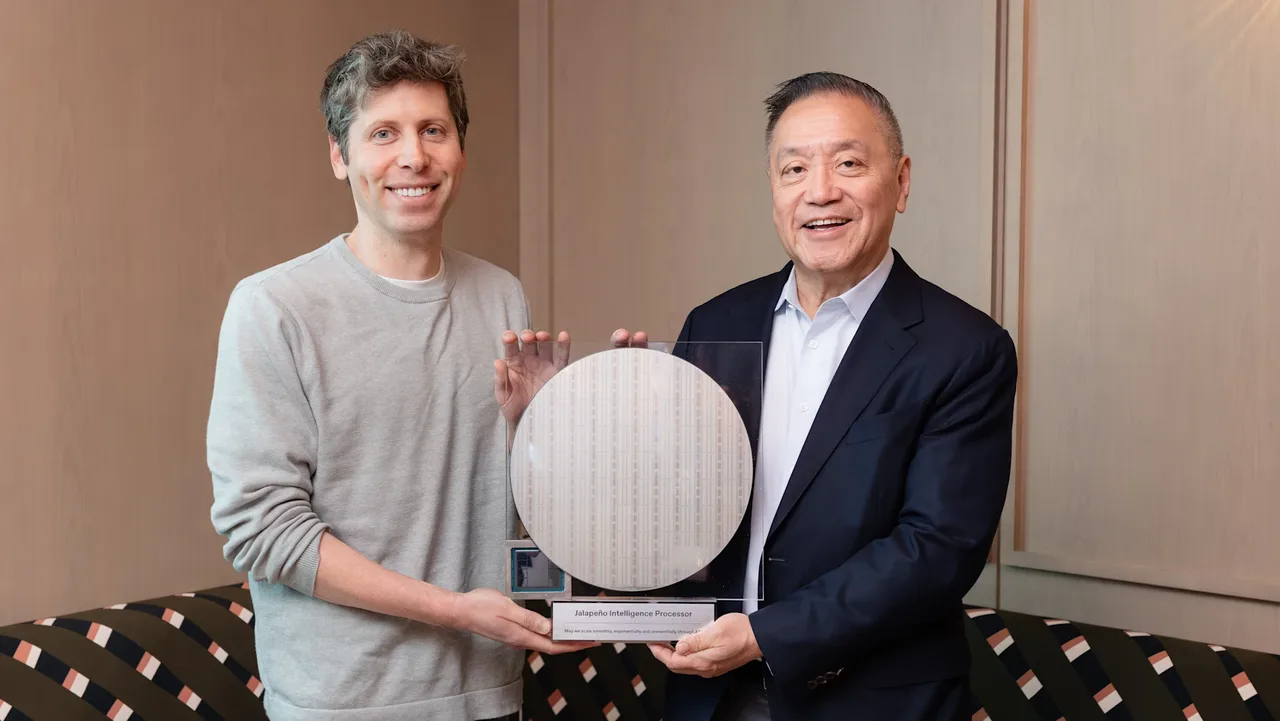
OpenAI 18 ноября раскрыла результаты работы с AMD над схемами флагманских GPU. По данным компании, модели добились улучшения до 14% по PPA менее чем за пять месяцев на базе тщательно оптимизированных проектов AMD. Часть изменений AMD уже включила в проект, отправленный на производство, другие добавила в рабочие файлы будущих версий.
Не готовый GPU на 14% быстрее
PPA означает power, performance, area: энергопотребление, производительность и площадь схемы. Это оценка инженерных компромиссов при проектировании, а не обещание такого же прироста скорости готовой видеокарты. OpenAI не называет модели GPU и не приводит единого набора публичных замеров для готовых устройств.
Модель переписывала SystemVerilog RTL, код описания цифровых схем: вычислительных блоков, управляющей логики и передачи данных. Инструменты Synopsys проверяли, что новая схема сохраняет поведение исходной, и оценивали мощность, быстродействие и площадь. OpenAI также сообщает, что AMD проверила однозначный процентный прирост PPA в ключевых блоках своего будущего флагманского CPU.
Jalapeño: меньше площадь, короче задержка
На собственном ускорителе инференса Jalapeño OpenAI начала применять GPT-4o в начале 2025 года. По оценке команды, предложенные моделями изменения уменьшили площадь стандартных ячеек примерно на 13% в warp engine, управляющем параллельными вычислениями, и на 10% в матричном блоке. Компания утверждает, что эти оптимизации подтверждены при запуске изготовленного кремния.
Один из переработанных умножителей в матричном блоке занял примерно на 15% меньше площади ячеек при синтезе, а его задержка сократилась с двух тактов до одного. Отдельный сумматор тоже уменьшился примерно на 15%, сохранив задержку в два такта. Экономию дали изменения логики, разделения вычислений по стадиям и промежуточного хранения данных.
Что проверяли на RISC-V
Для сравнения поколений моделей OpenAI использовала открытые 32-битные ядра PicoRV32 и Ibex. В одном задании модели улучшали существующее описание, в другом строили ядро по письменным требованиям. При сопоставимом бюджете около 112 000 токенов на запуск GPT-6.2 Astra показала наивысшую среднюю оценку на обоих ядрах в задаче оптимизации. Вся серия включила 9881 оценённый запуск.
Корректность проверяли в симуляции, а пропускную способность оценивали по скрытым от моделей нагрузкам и частоте, рассчитанной Yosys. Ошибочные варианты получали ноль, как и схемы площадью более чем в 16 раз выше исходной. Проектирование по требованиям давало моделям возможность убрать счётчики производительности и дополнительные инструкции, поэтому эти результаты нельзя напрямую переносить на промышленный CPU со всеми исходными функциями.
Работа с инструментами проектирования опирается и на партнёрство с Synopsys. Оно объявлено 30 сентября 2026 года: компании разрабатывают GPT-Synopsys, специализированную модель для работы с EDA-инструментами. Поэтому отчёт от 18 ноября об AMD и Jalapeño не является первым анонсом этого партнёрства.
Ранее мы рассказали о выпуске GPT-6.2 Astra и Sol и заказных ускорителях OpenAI в отчёте Broadcom.