AI и дата-центры
Reshard от NVIDIA: обновление весов при дообучении ускорилось до 5.7 раза
Публикация:
NVIDIA опубликовала Reshard, новый тип коллективной коммуникации для дообучения с подкреплением: вместо сборки полных весов на каждом GPU она пересылает только пересечения шардов, и в тестах NeMo RL обновление весов ускорилось в 2.7-5.7 раза.
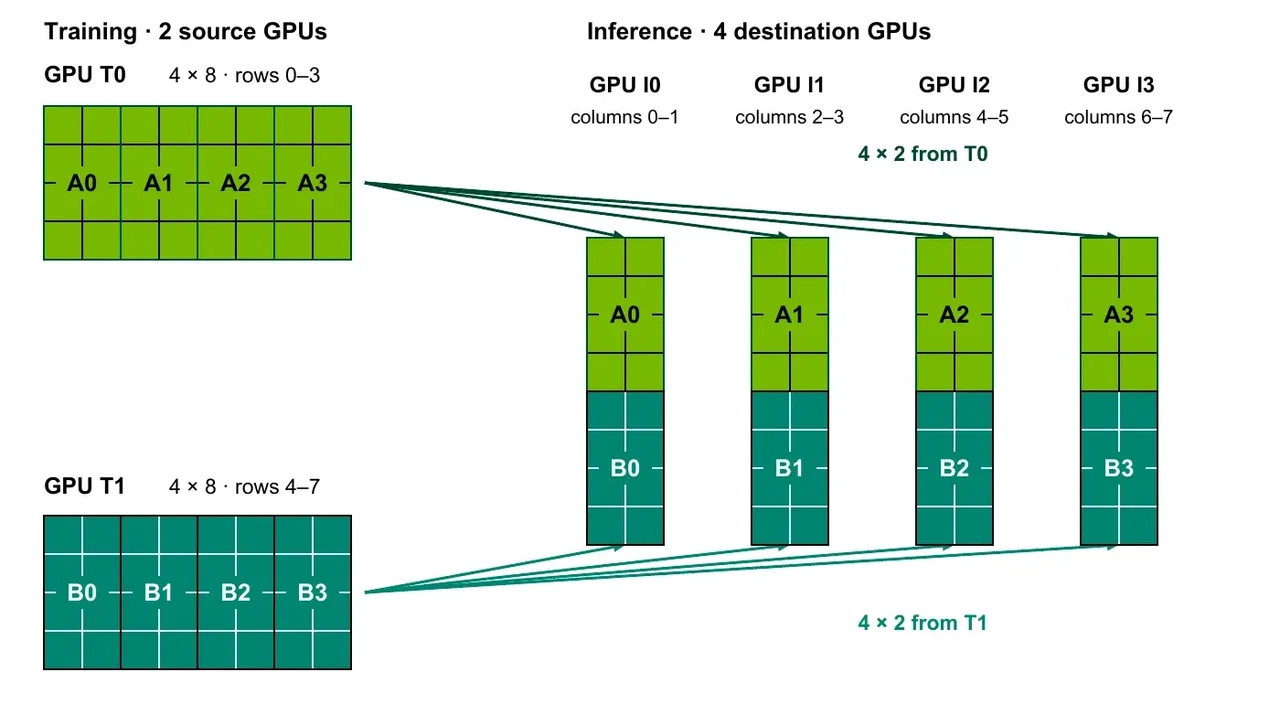
При дообучении с подкреплением обучение и инференс обычно идут параллельно на разных GPU: траектории генерируются на лету запуском инференса с текущей моделью, а веса на инференсных GPU нужно периодически обновлять свежими параметрами с обучающих GPU. Эта пересылка весов называется refit, и у крупнейших открытых моделей её объём уже достигает около 10 ТБ на обновление при каждом шаге обучения. Например, веса Kimi K3 на 2.8 трлн параметров занимают около 5.6 ТБ, а у Qwen 3.8 2.4T около 4.8 ТБ, так что двухступенчатая схема gather-and-broadcast даёт логическую нагрузку около 11.2 ТБ и 9.6 ТБ соответственно.
Обычная схема gather-and-broadcast сначала собирает все шарды в полный тензор, рассылает его всем инференсным GPU, и каждый берёт свой кусок, хотя ему нужна лишь его часть. Reshard переформулирует задачу как перенос DTensor из раскладки обучения в раскладку инференса: по описаниям исходной и целевой раскладок система вычисляет точные пересечения шардов и пересылает только те области, которые нужны каждому целевому GPU. Реализация NCCL M2N Reshard открыта в репозитории NVIDIA/nccl-extensions на GitHub, а в NeMo RL есть готовая реализация для дообучения.
Внутри одного домена NVLink реализация группирует реплики и распределяет входящие данные между ними так, чтобы каждая получала свою часть по сети, а недостающее добирала по NVLink, без дублирования трафика. Сеть и обмен по NVLink идут одновременно, скрывая задержки друг друга.
В тестах NeMo RL на DGX H100 и DGX GB200 обновление весов ускорилось в 2.7-5.7 раза по сравнению с gather-and-broadcast. Для Qwen 3 235B задержка упала с 6.4 секунды до 1.9 секунды, для DeepSeek v3 671B с 14.9 секунды до 2.6 секунды на DGX H100 и с 6.1 секунды до 2.3 секунды на DGX GB200, а для Nemotron Ultra v3 с 8.2 секунды до 2.3 секунды. В отдельном микротесте обновление весов Qwen 3.8 2.4T заняло всего 4.3 секунды.
Reshard рассчитан на триллионные модели: на веса feed-forward проекций приходится около 95% параметров современных моделей, и именно они идут по пути reshard, а мелкие веса вроде QKV-проекций остаются на обычной схеме. Все цифры выше это замеры самой NVIDIA в её NeMo RL. Из нашей ленты по теме: открытые веса Kimi и тесты NVIDIA Vera.