AI и дата-центры
NVIDIA выпустила открытые модели Nemotron 3.5: Super VL и Bolt
Публикация:
Флагманская Super VL на 120 млрд параметров для агентских задач и Bolt 74B, целиком уместившаяся в 24 ГБ памяти.
NVIDIA 15 октября выпустила две открытые модели семейства Nemotron 3.5. Старшая, Super VL на 120 млрд параметров, задумана как самая быстрая открытая модель для постоянно работающих агентских систем. По собственным данным NVIDIA и рейтингу Artificial Analysis Intelligence Index она до пяти раз быстрее ближайшей модели своего класса по пропускной способности.
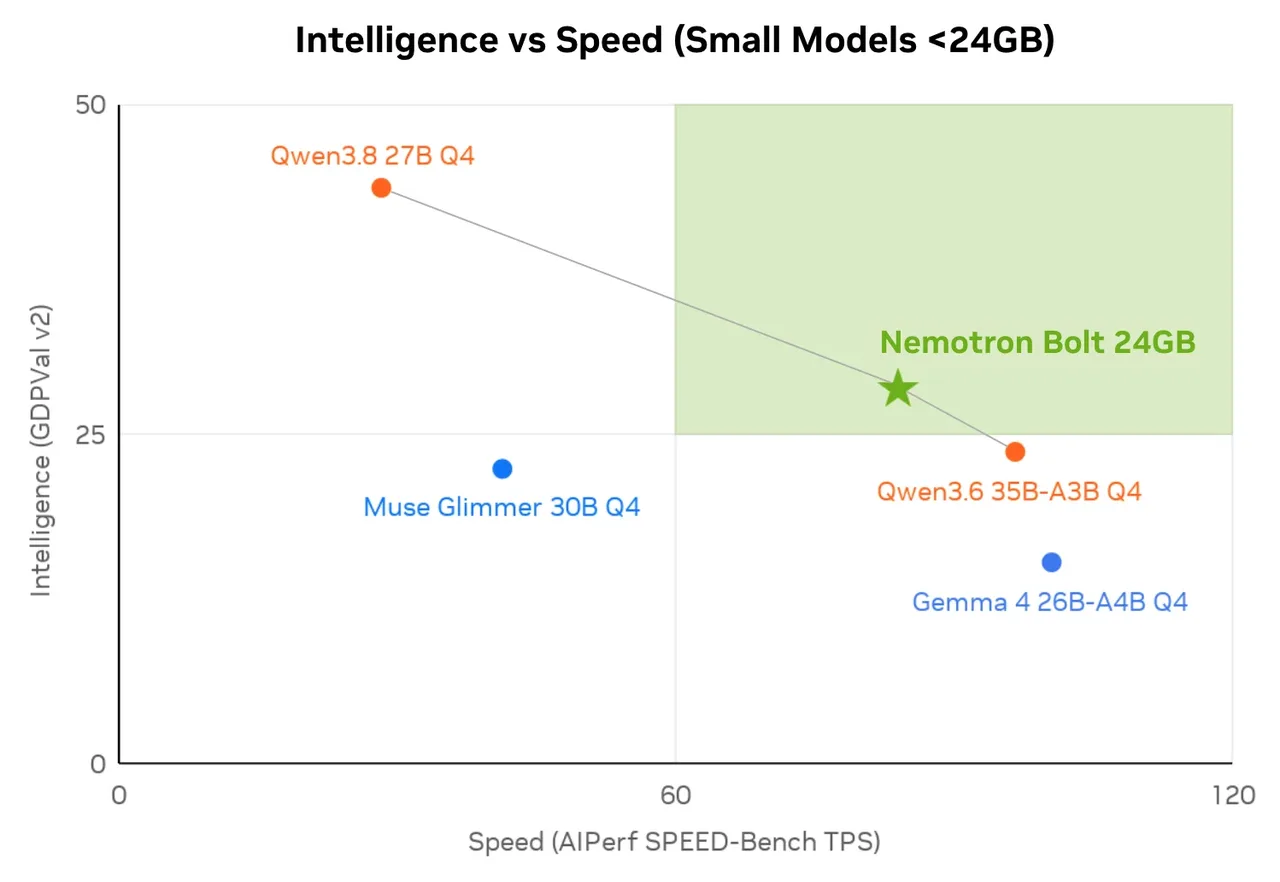
Младшая, Bolt 74B-A9B, хранит свои 74 млрд параметров в нативном 2-битном квантовании и целиком помещается в 24 ГБ памяти - NVIDIA тестировала ее на ПК с GeForce RTX 5090. Контекст - 256 000 токенов, веса доступны на Hugging Face, модель поддерживают llama.cpp, Ollama, LM Studio, Unsloth и vLLM. По заявлениям компании это лучшая открытая модель своего класса на PinchBench и вторая на BrowseComp. Третья модель, компактная Bolt E4B на 4 ГБ, выйдет 23 октября.
Super VL читает текст, изображения, короткие видео и PDF и рассчитана на распознавание таблиц, графиков и документов. Она уже доступна через Hugging Face, OpenRouter, ModelScope и как микросервис NVIDIA NIM. Вместе с весами NVIDIA отдала открытые датасеты и рецепты обучения. По данным вторичных источников модели вышли под лицензией OpenMDW-1.1, которая разрешает коммерческое использование.
Super VL построена как смесь экспертов: из 120 млрд параметров на каждый токен активны 12 млрд. По заявлению NVIDIA, точность на мультимодальных агентных задачах у неё сравнима с самой крупной рассуждающей моделью компании при примерно пятой части числа параметров, а собрана модель совместно с Nemotron Coalition. Обучение заняло около 26 трлн токенов предобучения и продолженного предобучения, затем около 3,8 млн примеров постобучения и обучение с подкреплением в десятках сред. В замерах компании: 63,44% на Hermes Bench против 56,33% у Nemotron 3 Ultra, 87,05% на поведенческих оценках LangChain против 84,3%, на CharXiv - 80,8% против 63% у Nemotron 3 Nano Omni, а с интерпретацией Python-кода - 84%. NVIDIA также относит Super VL к лучшим открытым моделям рейтинга OCRBench v2.
Отдельно NVIDIA добавила 10 млрд токенов на индийских языках и публикует датасет примерно на 2,8 трлн токенов по 22 индийским языкам, собранный с IIT Madras и лабораторией AI4Bharat. Для развёртывания предлагается микросервис NIM с обновлениями каждые две недели: по данным компании, на 16 GPU B200 при 50 токенах в секунду на пользователя обслуживание с маршрутизацией Dynamo держит до 8 раз больше пользователей и снижает задержку первого токена на 85%.