AI и дата-центры
NVIDIA открыла пять моделей Nemotron 3.5 для поиска: Embed, Rerank и Parse
Публикация:
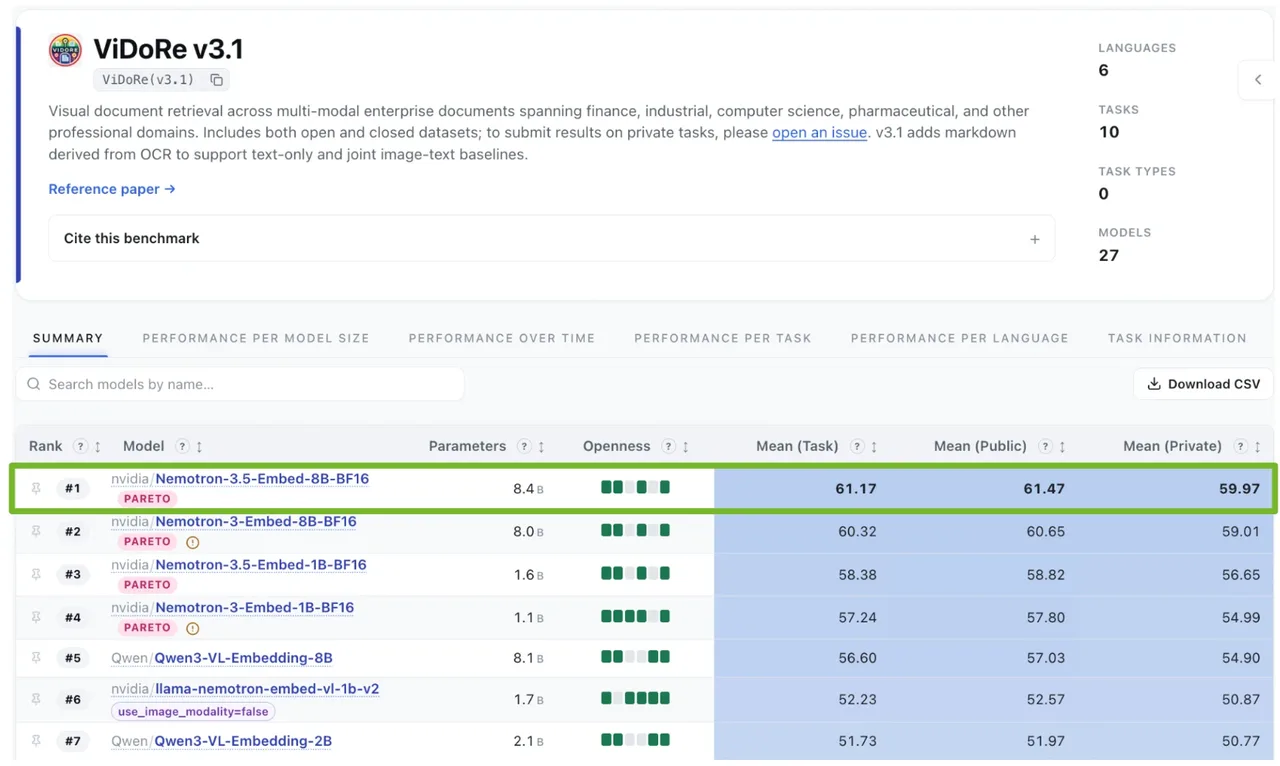
NVIDIA расширила коллекцию Nemotron Retriever пятью открытыми моделями: Embed 8B BF16, Embed 1B BF16, Embed 1B NVFP4, Rerank 8B BF16 и Parse на 631M параметров. Embed 8B - первый среди dense-моделей на ViDoRe v3.1, а Parse - первый на ParseBench среди моделей меньше 1B параметров.
NVIDIA расширила коллекцию Nemotron Retriever: вышли пять открытых моделей, доступных для коммерческого использования, - Nemotron 3.5 Embed 8B BF16, Embed 1B BF16, Embed 1B NVFP4, Rerank 8B BF16 и Parse на 631M параметров. Это строительные блоки для агентных RAG-систем: поиск доказательств по тексту и изображениям, переоценка релевантности выдачи и превращение PDF в структурированный текст. От качества поиска зависит, сколько лишних токенов агент сожжет на повторные запросы, прежде чем найдет ответ.
Embed ищет одновременно по тексту и изображениям: таблицам, графикам, инфографике, даташитам и схемам. Текстовый поиск оценивался на 34 языках, визуальный - на наборах MIRACL Vision (18 языков) и KoViDoRe. Компактная версия 1B дистиллирована из 8B-учителя и сохраняет 95.4% его качества при 58.38 nDCG@10. Вариант 1B NVFP4 квантует оба энкодера для высокопроизводительного инференса. Rerank 8B - кросс-энкодер: он попарно оценивает запрос и каждый кандидат, чтобы переупорядочить выдачу для текстовых и визуальных входов.
Все замеры - из тестов самой NVIDIA: агент, LLM, набор задач, корпус и политика выполнения были зафиксированы, менялась только конфигурация поиска. На ViDoRe v3.1 модель Embed 8B BF16 набрала 61.17 nDCG@10 и заняла первое место среди dense-моделей - на 8.94 пункта выше 52.23 у Llama Nemotron Embed VL 1B. На MIRACL Vision 8B-модель показала 72.6 nDCG@10, опередив Qwen3-VL-Embedding-8B на 4.3 пункта. Rerank 8B набрал 60.49 nDCG@10 против 59.17 у Qwen-3-VL-Reranker-8B. Добавление реранкера сократило расход агентных токенов на запрос примерно на 14% с Embed 8B и на 13% с Embed 1B при росте точности выдачи. Цифры лидбордов актуальны на 20 октября 2026 года.
Parse на 631M параметров превращает изображения документов в Markdown и HTML-таблицы: первое место на ParseBench среди моделей меньше 1B параметров с результатом 75.20 при 10.5 страниц в секунду на одном H100 (одинарный проход - 72.74 при 16.1 стр/с, двойной - 74.92 при 11.2 стр/с). Embed 1B NVFP4 на NVIDIA GB200 обрабатывает 128.8 документов в секунду против 101.3 у версии BF16 - на 27.1% быстрее при сохранении 99.85% точности. Через NVIDIA NIM на RTX PRO 6000 Blackwell Server Edition модель обслуживает 6,031 запросов в секунду против 2,099 у сравнимой конфигурации vLLM - примерно в 2.9 раза быстрее. Веса, данные и рецепты обучения открыты на Hugging Face, продакшен-деплой - через NIM, Baseten, DeepInfra и FriendliAI. Оговорка: оценки партнеров (Elastic, Vectorize, Perplexity, Turbopuffer) - самозаявленные, независимой проверки этих замеров нет.