ИИ и дата-центры
NVIDIA показала экспериментальных ИИ-агентов для эксплуатации GPU-кластеров
Публикация:
NVIDIA описала экспериментальный открытый пример мультиагентной системы, которая помогает инженерам эксплуатации (SRE) искать причины сбоев в GPU-кластерах. Компания предупреждает, что API, конфигурация и требования к развёртыванию могут меняться.
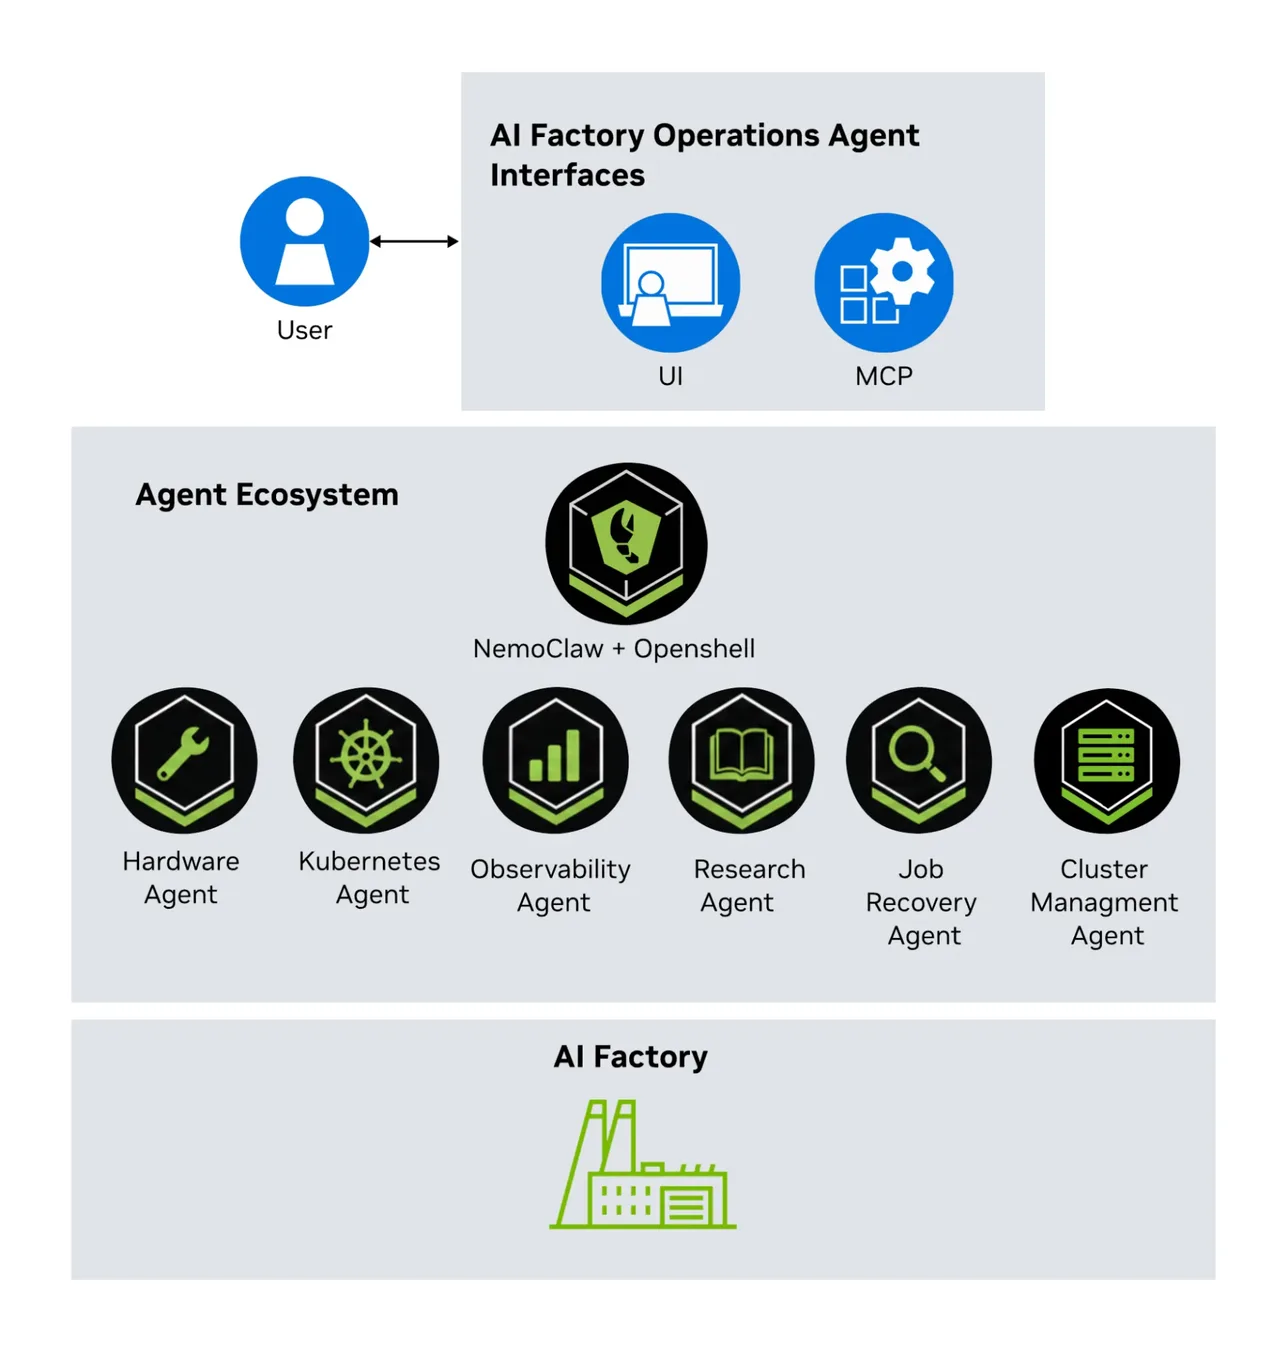
4 ноября 2026 года NVIDIA описала AI Factory Operations Agent, экспериментальный открытый пример системы для эксплуатации крупных GPU-кластеров. Компания разработала её для собственных операций DGX SuperPOD. Специализированные агенты сопоставляют сбои в вычислениях, сети, оборудовании и планировщике, затем показывают оператору возможную причину и рекомендации. Публикация объясняет, как собрать систему, и не представляет её готовым коммерческим сервисом.
Пример основан на базовом проекте NemoClaw и использует OpenShell для управления средой агентов. NVIDIA пишет, что систему можно развернуть локально, а модели Nemotron запускать на собственном оборудовании. Внутри компании она работает с кластерами DGX H100, DGX B200 и DGX GB300. Другие организации могут выбрать локальную или облачную точку доступа модели с учётом требований к данным, размера кластера и доступных GPU.
AI Factory Operations Agent работает как приложение управляющего слоя Kubernetes. Helm разворачивает интерфейс, шлюз OpenClaw, MCP-серверы инструментов, точку доступа модели и среду OpenShell. Shell-команды выполняются в отдельной Kubernetes-песочнице для каждой сессии; основной шлюз их не исполняет. Для проверки Kubernetes серверный инструмент использует зарегистрированные учётные данные только для чтения. OpenShell не получает kubectl или учётные данные кластера, а роли Kubernetes определяют, какие ресурсы можно просматривать.
Внутренний набор NVIDIA включает агентов восстановления заданий, диагностики оборудования, наблюдаемости, поиска по документации, Kubernetes и управления кластерами. Job Recovery сопоставляет состояние планировщика, приложения, аппаратуры и сети. Hardware Agent ищет неисправности GPU, NVMe и температурные аномалии. Observability Agent использует Prometheus и Grafana Loki для создания панелей мониторинга. Агенты дают рекомендации, а инженеры могут проверить ход работы и её основания перед тем, как действовать.
Для крупных AI-фабрик NVIDIA рекомендует выделенный GPU-ускоренный управляющий кластер, изолированный от производственной системы. Он координирует агентов и анализирует телеметрию, не отнимая GPU у задач обучения. В многопользовательской среде доступ к данным, инструментам и узлам ограничивают отдельными разрешениями и песочницами. Для внедрения нужны Kubernetes и MCP-интеграции, а права доступа следует проверять на своей инфраструктуре. В USB.RU уже выходил материал о [платформе NVIDIA Minerva для мониторинга AI-фабрик](https://usb.ru/news/nvidia-minerva-aiops-2026/) и о [системе NVKE для управления Kubernetes-кластерами на GPU-серверах](https://usb.ru/news/nvidia-nvke-kubernetes-preview-2026/).
NVIDIA публикует код как экспериментальное ПО с открытым исходным кодом. Компания предупреждает, что API, конфигурация и требования к развёртыванию могут меняться. Доступ к созданным NVIDIA агентам для операций с кластерами предлагается запрашивать через менеджера аккаунта. Открытый пример можно изучать и проверять в пилоте, но его пригодность для рабочей инфраструктуры требует отдельной оценки безопасности и надёжности.