ИИ и программы
Microsoft показала RDMA по USB4: одна большая модель на нескольких ПК с Windows
Публикация:
Developer preview соединяет два и более компьютера кабелями USB4 и складывает их память и GPU для одной модели: NetworkDirect без адаптеров, задержка 28-50 мкс, открытый код провайдера и стенд на llama.cpp.
Microsoft анонсировала 19 ноября 2026 года developer preview технологии RDMA over USB4 для Windows. Два и более ПК с портами USB4 соединяются обычными кабелями, и совместимый инференс-фреймворк может разложить одну модель по их суммарной памяти и вычислительной мощности GPU. Отдельный RDMA-адаптер, коммутатор и сторонние драйверы не нужны.
Идея в том, что крупные открытые модели часто не помещаются в память одного ПК: раньше оставалось сжимать модель, уходить в облако или собирать серверный кластер. Теперь Microsoft предлагает четвертый вариант - маленький кластер на столе из обычных машин с USB4. Это часть стратегии гибридного интеллекта, где ИИ-задача выполняется там, где ей удобнее: на ПК или в облаке.
Задержка и полоса
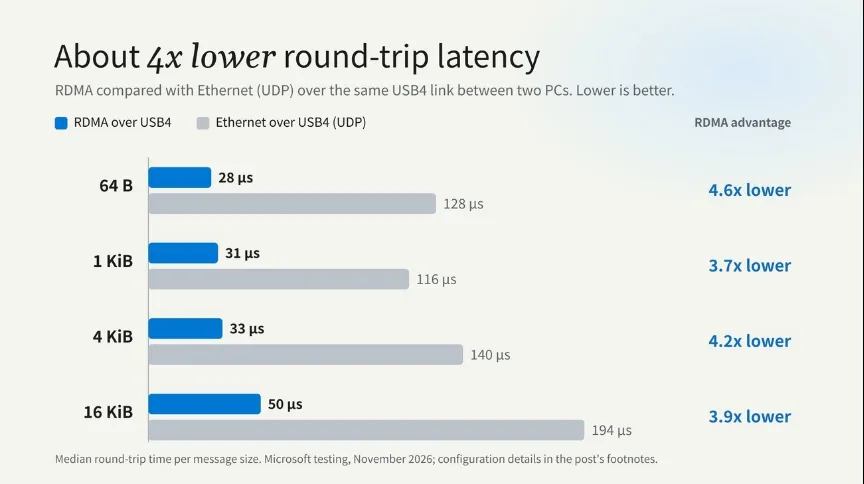
По измерениям Microsoft между двумя ПК, RDMA over USB4 снижает round-trip задержку мелких сообщений до 28-50 мкс - примерно в 4 раза ниже, чем Ethernet (UDP) по той же линии USB4. На 40 и 80 Гбит/с задержка держится на одном низком уровне, а 80 Гбит/с дают вдвое больше полосы.
Что входит в превью
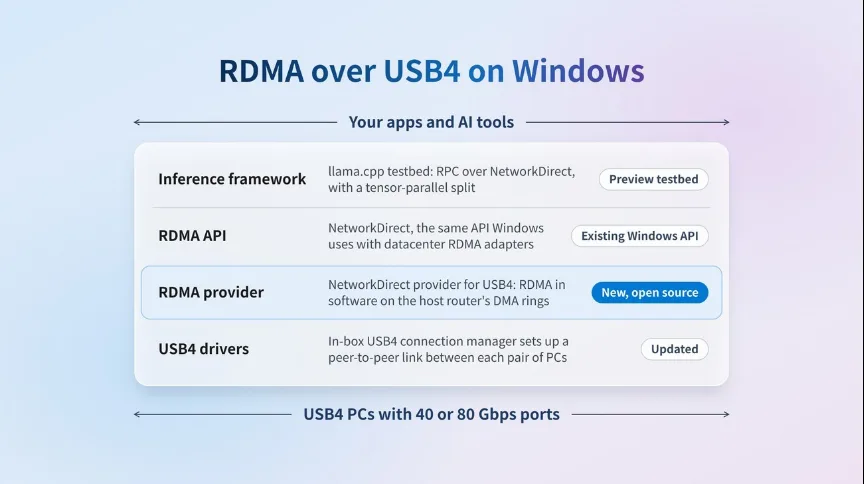
В комплекте - обновленные встроенные драйверы USB4 и новый провайдер NetworkDirect: приложения используют тот же RDMA API, что Windows применяет с датацентровыми сетевыми адаптерами. Провайдер, примеры и утилиты для проверки линии выложены в открытый код, а тестовый стенд - форк llama.cpp, у которого RPC-бэкенд работает по NetworkDirect вместо TCP. Превью появится в канале Experimental (Future Platforms) программы Windows Insiders; включать его нужно вручную через реестр и тестовую подпись.
Технически RDMA-провайдер реализован программно поверх DMA-колец хост-маршрутизатора USB4: менеджер подключений Windows строит peer-to-peer туннель между каждой парой ПК, а операции отправки и приема отображаются на эти кольца без лишних копирований данных. Каждый линк занимает две пары колец - под данные и под управление, поэтому размер кластера ограничен числом колец и USB4-портов. Линии работают на портах под управлением Windows с Kernel DMA Protection.
Первые результаты AMD и Intel
Microsoft тестировала превью на мини-ПК с AMD Ryzen AI Max и на системах с Intel Core Ultra Series 3. Три мини-ПК с Ryzen AI Max, графикой Radeon 8060S и 128 ГБ unified-памяти каждый, собранные в полносвязную сеть USB4 40 Гбит/с, прогоняют Qwen3-235B-A22B - MoE-модель на 235 млрд параметров - со скоростью около 18,5 токена в секунду в 4-битном квантовании. В собственном стенде из трех ПК AMD замерила 21,98 токена в секунду на генерации и 117,98 - на обработке промпта.
Intel запускала GPT-OSS-120B - открытую модель примерно на 120 млрд параметров, которая не помещается в один ПК с 64 ГБ, - на трех и четырех системах Core Ultra Series 3 с Thunderbolt 4 и памятью 9 600 MT/s. С тремя ПК получается около 49 токенов в секунду, с четырьмя - около 54.
Пока это раннее превью с оговорками: Microsoft просит разработчиков тестировать и делиться результатами, а форк llama.cpp называет демонстрацией, ожидая, что те же API подхватят другие фреймворки. Для владельцев ПК с USB4 и Thunderbolt 4 это первый штатный способ собрать домашний кластер без серверной сетевой карты.