AI и дата-центры
DeepSeek открыла веса V4.1 Flash: 552 млрд параметров под лицензией MIT
Публикация:
Облегченный флагман DeepSeek теперь можно скачать и запускать самим: миллион токенов контекста, вход текста и изображений, а независимые тесты уже нашли завышение в официальных бенчмарках.
6 октября веса DeepSeek V4.1 Flash появились на хабе Alibaba ModelScope, а сама модель заработала на платформе Alibaba Qwen. На собственном API DeepSeek модель под именем deepseek-flash работает с сентября. Веса распространяются под лицензией MIT: коммерческое использование разрешено.
Это смесь экспертов (MoE) на 552 млрд параметров, из которых на каждый токен работают лишь 8 млрд при чтении и 16 млрд при генерации. Архитектура - 40-слойный причинный энкодер-декодер (20+20), один общий и 384 направленных эксперта с маршрутизацией top-6. Контекст - 1 048 576 токенов, на вход принимает текст и изображения.
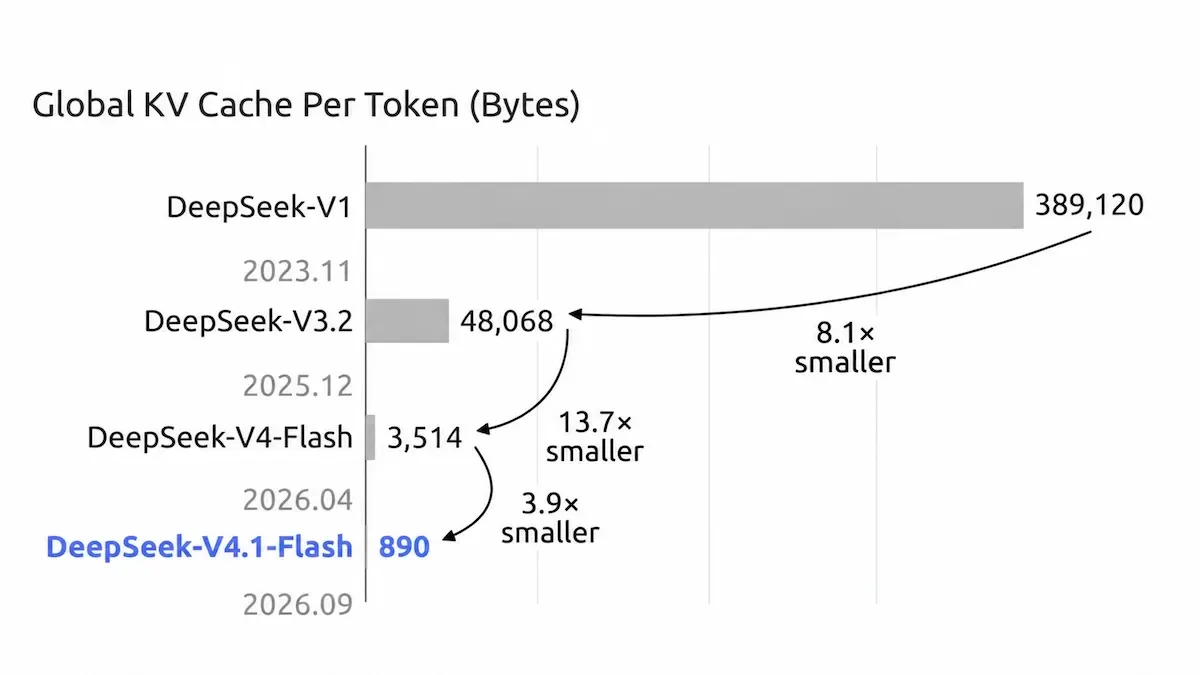
Главная инженерная находка - крошечный KV-кеш: около 890 байт на токен благодаря ключам и значениям в FP4 и схеме Compressed Sparse Attention 2. Полный миллионный контекст укладывается менее чем в гигабайт памяти: в четыре раза меньше, чем у V4-Flash, и в 437 раз меньше, чем у модели первого поколения.
Цены на API DeepSeek: в пиковые часы $0.30 за миллион входных и $1.20 за миллион выходных токенов, в остальное время вдвое дешевле, а попадания в кеш стоят $0.006 и $0.003 соответственно. Пик - с 01:00 до 04:00 и с 06:00 до 10:00 UTC по будням.
Независимый оценщик Vals AI ставит V4.1 Flash первым среди открытых моделей в своем индексе (57.86%, 15-е место из 56). Но он же намерил 74.53% на Terminal-Bench 2.1 против заявленных DeepSeek 90.6%: разрыв объясняется собственным харнессом вендора. Для самостоятельного запуска нужны веса примерно на 510 ГБ и сервер уровня 8x H200.