AI и дата-центры
SGLang-Neuron стал доступен на AWS Trainium: SGLang работает на чипах Amazon без смены интерфейса
Публикация:
Amazon открыла SGLang-Neuron: плагин запускает привычный сервер SGLang на чипах Trainium через контейнер AWS Deep Learning Container. Проект ведут RadixArk и Annapurna Labs, версия v0.1.0 вышла в публичном превью с открытым кодом.
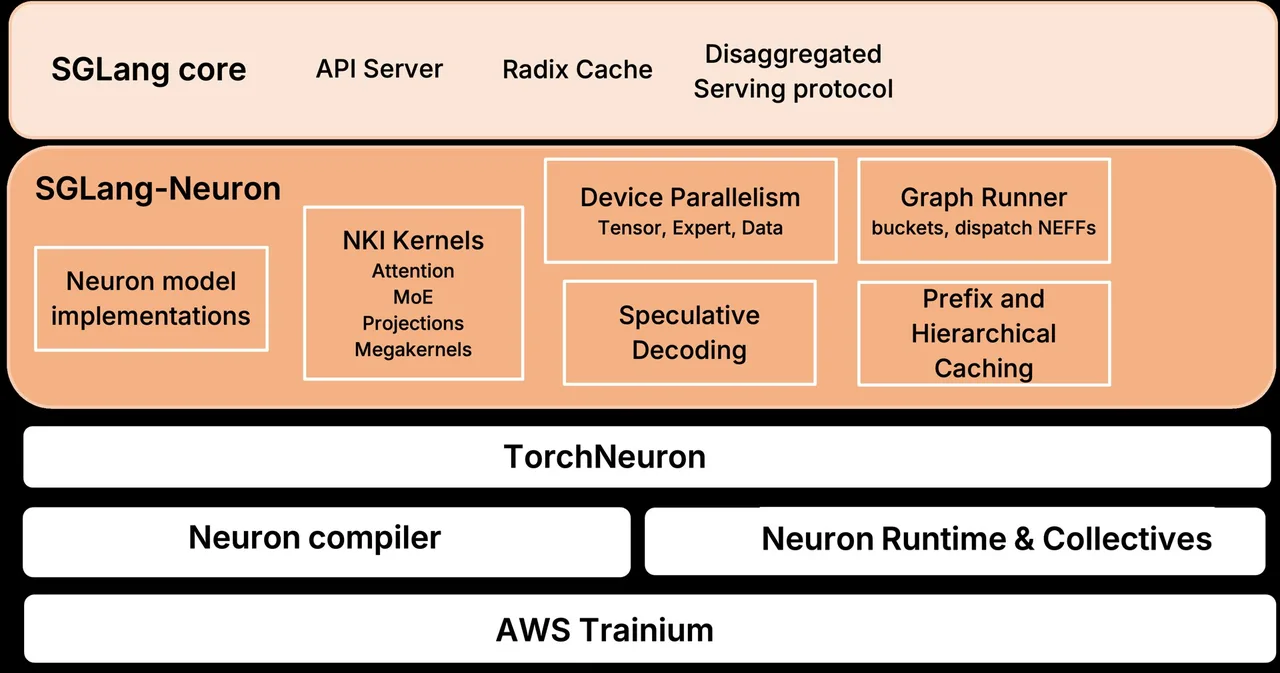
Amazon объявила, что SGLang-Neuron доступен публично. Его выпустили RadixArk и Annapurna Labs в виде AWS Deep Learning Container. С ним можно обслуживать модели и генерировать RL-роллауты на AWS Trainium через тот же интерфейс SGLang, что и раньше.
Как это устроено
SGLang-Neuron работает как внешний плагин: после установки он регистрирует платформу neuron, а выбирается она переменной SGLANG_PLATFORM=neuron. Ядро SGLang по-прежнему отвечает за API-сервер, жизненный цикл запросов, RadixAttention и кэш префиксов, а плагин берёт на себя модели, внимание, mixture of experts и исполнение графов на Trainium. Внизу лежит TorchNeuron, нативный бэкенд PyTorch для Trainium.
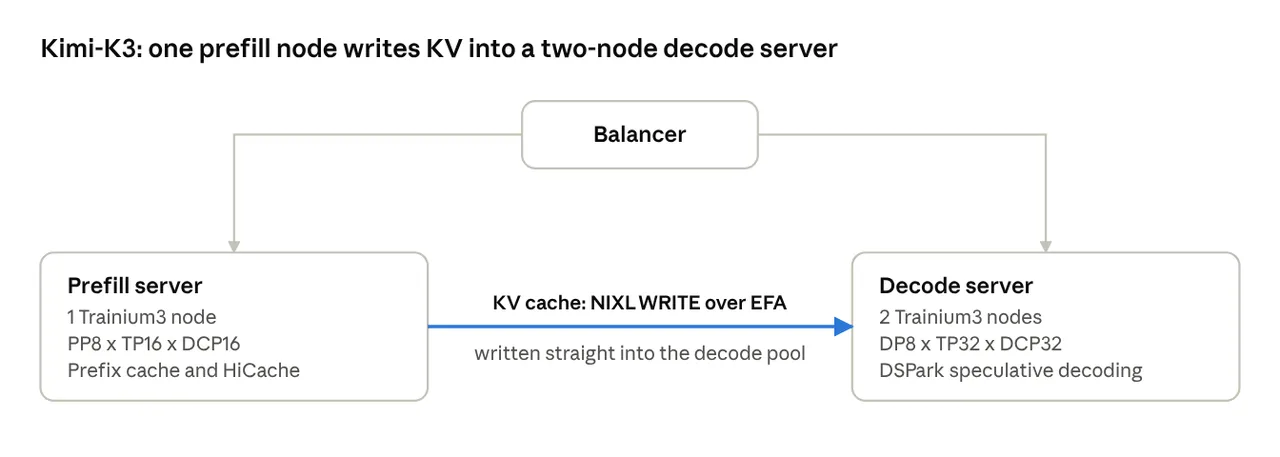
Поддерживается и разделение prefill и decode: один сервер считает KV-кэш запроса, другой получает его по NIXL через Elastic Fabric Adapter и дописывает ответ. По разбору LMSYS, все модели идут на одном полностью асинхронном рантайме, где шаги декодирования выполняются подряд без простоев, а мегакернелы прогоняют все слои декодера за один вызов NKI.
Модели и цифры
Самая крупная конфигурация релиза - Kimi-K3 на трёх узлах Trainium3: один узел под prefill, два под decode. По данным LMSYS, она выдаёт 67 токенов в секунду на пользователя на смешанных промптах от 4K до 1M. GLM-5.2 в MXFP4 обслуживает контекст в 1M токенов для агентных задач кодирования.
Кэш HiCache держит вытесненные префиксы в памяти хоста, чтобы не пересчитывать их при повторном обращении. На GPT-OSS-120B при TP8 и контексте 32K это даёт от 72% до 75% больше выходной пропускной способности. Диффузионные модели тоже переехали: SGLang Diffusion на Trainium2 запускает FLUX.1-dev, FLUX.3-Action, MiniMax-H3, Wan2.2 A14B и LingBot-World-V2.
Статус
Это публичное превью, и пока поддержка идёт через контейнер AWS. Релиз следует за закрытой бетой, о которой команда SGLang объявила в октябре. Он продолжает линию AWS на поддержку PyTorch для Trainium в Neuron и совпадает по времени с разговорами о продаже Trainium сторонним дата-центрам.