Инфраструктура ИИ
AWS Lambda получила поддержку GPU-инстансов
Публикация:
Event Functions на Lambda Managed Instances теперь запускаются на GPU-инстансах EC2 G-серии: контейнеры до 32 ГБ, до 48 одновременных запросов в одной среде выполнения и таймаут до 90 минут для асинхронных вызовов. Драйверы, масштабирование и балансировку берет на себя Lambda.
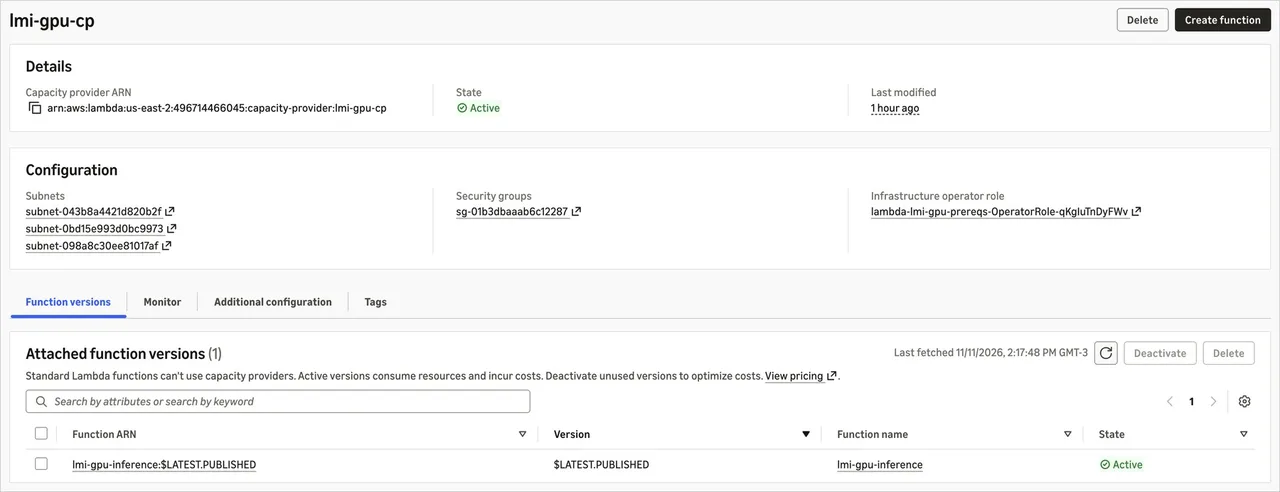
AWS добавила поддержку GPU в Lambda: функции Event Functions на Lambda Managed Instances теперь работают на GPU-инстансах EC2 G-серии. Об анонсе компания сообщила 18 ноября 2026 года. Функция развертывается как контейнерный образ OCI - разработчик указывает образ, а Lambda берет на себя провижининг, масштабирование и интеграцию с событиями, без драйверов, подбора версий CUDA и кластеров.
Поддерживаются и ИИ-нагрузки, и обычные вычисления на GPU: инференс собственных моделей (компьютерное зрение, speech-to-text, рекомендательные системы, анализ документов), обработка и транскодинг видео, 3D-рендеринг и генеративная графика, научные расчеты и финансовое моделирование. AWS подчеркивает, что возможность оптимизирована под инференс, а не обучение, и под собственные модели, а не крупные фундаментальные, которые уже доступны в Amazon Bedrock.
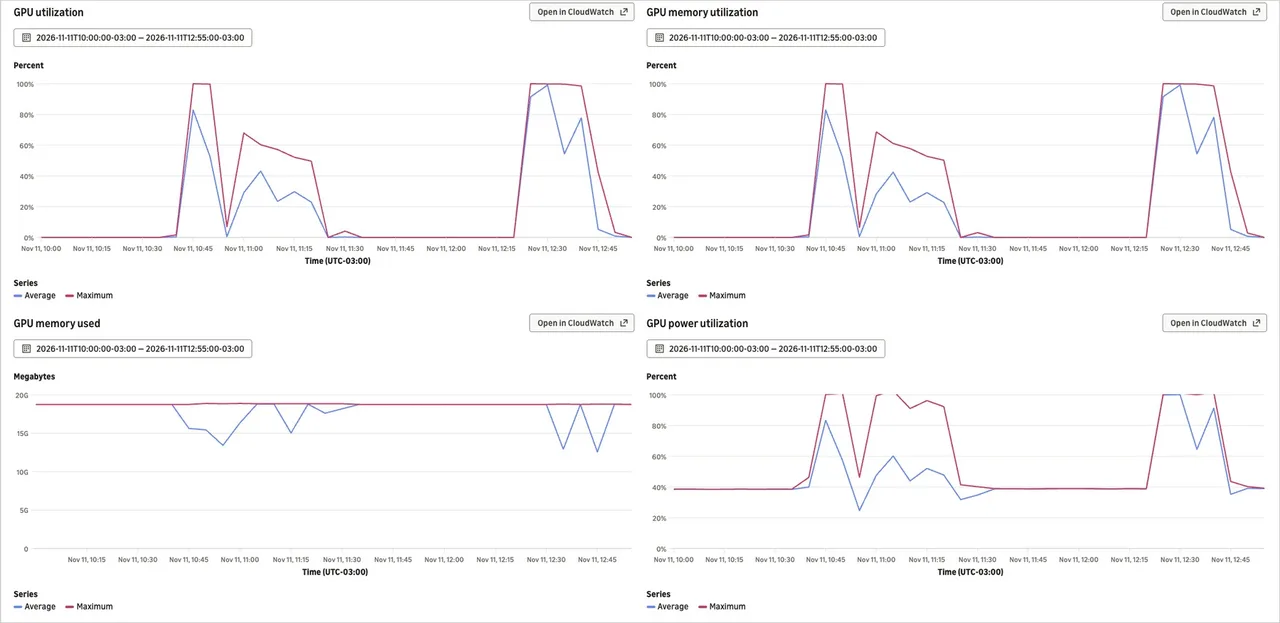
Лимиты и конфигурация
Образ контейнера - до 32 ГБ (один файл - до 10 ГБ), эфемерное хранилище NVMe - до 32 ГБ, оперативная память - от 2 048 до 32 768 МБ, память ускорителя - от 3 до 48 ГБ. Одна среда выполнения обрабатывает до 48 одновременных запросов, а на один capacity provider приходится до 15 000 vCPU. Для асинхронных вызовов и event source mapping действует расширенный таймаут - до 90 минут, что позволяет запускать длинные пакетные задачи вроде транскодинга или многошагового инференса.
Готовые образы и цены
Готовые базовые образы идут с предустановленными фреймворками: base:cuda (CUDA toolkit), cupy:cuda (CuPy, NumPy, SciPy, Pandas, Numba), pytorch:cuda (PyTorch, torchvision, transformers, FFmpeg) и serving-образы vllm:cuda и sglang:cuda - их можно использовать напрямую, расширять или заменить полностью своим образом. Оплата - по цене EC2 On-Demand (действуют Savings Plans и Reserved Instances) плюс комиссия Lambda 9,75% и 0,20 доллара за миллион запросов. Функция доступна во всех коммерческих регионах AWS, где работают Lambda Managed Instances и инстансы G-серии.