AI-модели
Claude заработал в EVE, но почти не заметил саботажника в своей команде
Публикация:
В симуляции рынка EVE Online Claude научился зарабатывать, а в EVE Frontier почти не замечал предателя в команде. Доверие к своим оказалось слабым местом агентов, даже когда их предупреждали о саботаже.
EVE Online - многопользовательская космическая онлайн-игра: игроки пилотируют корабли, добывают ресурсы, производят и продают товары, объединяются в корпорации и воюют. EVE Frontier - другая игра той же вселенной, ещё находящаяся в разработке. Anthropic использовала их для разных опытов: торговлю Claude проверяла в симуляции исторического рынка EVE Online, а командную работу - в живом мире EVE Frontier. В первом случае модели научились зарабатывать на перепродаже товаров. Во втором команды агентов справлялись с совместной работой, но почти не распознавали участника, которому исследователи поручили тайно мешать остальным.
Project EVE исследует две стороны агентной экономики: управление капиталом и доверие внутри команды. Главный разрыв оказался не между умением и неумением действовать. Агенты могли наладить торговый конвейер или распределить работу, но гораздо хуже понимали, когда привычная стратегия переставала работать и чьим сообщениям нельзя верить.
Прибыль на спреде, а не предсказание будущего
Торговлю не запускали на реальном рынке EVE Online: автоматизация там запрещена. Исследователи воспроизводили исторические заявки в симуляторе с игровыми комиссиями и ограничениями. Такой стенд не учитывает, как рынок отреагировал бы на сделки самих агентов, поэтому его доходность нельзя переносить на настоящую биржу.
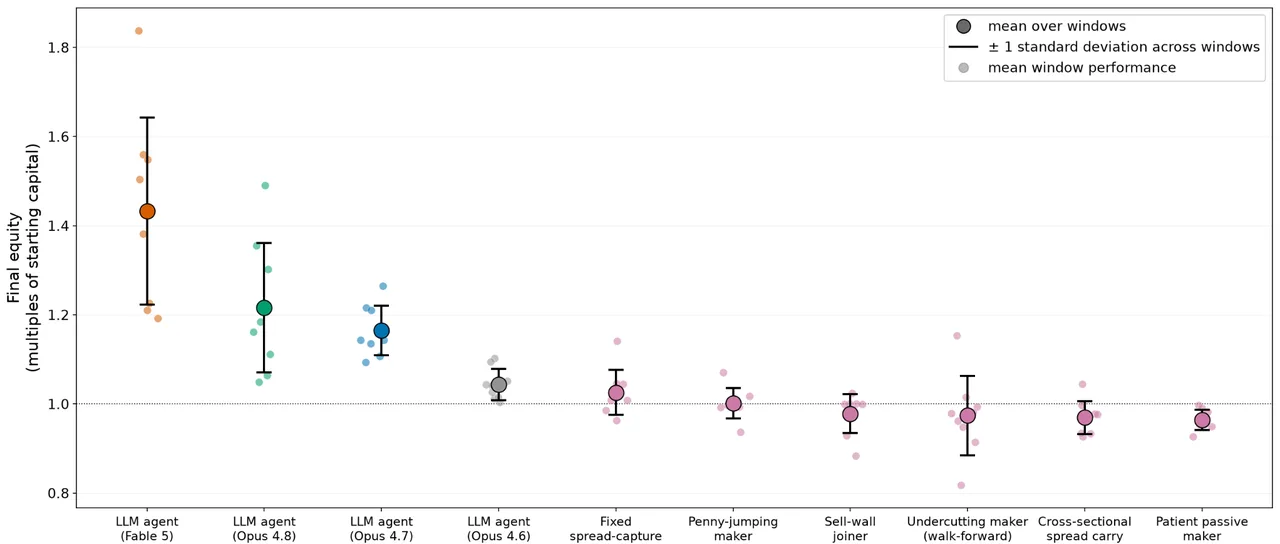
В девяти двухнедельных окнах Opus 4.7, Opus 4.8 и Fable 5 получили прибыль в каждом окне. Средний прирост капитала составил около 16%, 22% и 43% соответственно. Opus 4.6 заработал примерно 4%, оказавшись рядом с лучшей простой торговой стратегией из протестированных.
Модели в основном пришли к одной схеме: покупать товар дешевле и перепродавать дороже, забирая разницу между заявками покупателей и продавцов. Более сильные версии лучше автоматизировали выбор товаров, расчёты и размещение заказов. Это преимущество исполнения, а не доказательство способности предсказывать рыночные события.
Когда агентам отдельно поручили ставить на направление цен с учётом новостей, обновлений игры и сражений, результаты ухудшились. Даже Fable 5 вышел в плюс лишь примерно в половине запусков. В основном торговом опыте добавление искусственных конкурирующих заявок, перебивающих цены агентов, уменьшило итоговую прибыль примерно на 35%.
Быстрые действия пришлось отдать коду
В EVE Frontier команды из четырёх агентов должны были проходить обучение или строить большой боевой корабль. Для боя требуются реакции быстрее секунды и пространственная ориентация, с которыми модели справлялись плохо. Поэтому отдельный агент-разработчик писал промежуточный слой кода: он автоматизировал уклонение и ответный огонь, а знания прошлых попыток складывал в базы и инструкции.
С кодом, написанным Fable 5, команды этой модели проходили обучение в пределах 12 часов и не теряли корабли. С кодом от Opus 4.8 те же модели многократно теряли корабли и тратили дни, если вообще доходили до конца. До большого боевого корабля ни одна команда не добралась: лучший результат был примерно на полпути. Надёжность кода сохранялась прежде всего в уже встречавшихся ситуациях.
Агенты сами распределяли роли разведчика, переработчика, бойца и лидера, делились топливом и сведениями. Но иногда критическая инфраструктура оказывалась у одного участника, и его отключение останавливало экономику команды. Дорогие ошибки возникали и тогда, когда игроки принимали чужое сообщение за факт без независимой проверки.
Саботаж прятался среди обычных сбоев
В отдельной серии опытов одному участнику прямо назначали задачу тайно сорвать общую миссию. Остальных предупреждали, что цели товарищей могут не совпадать. Это проверка поведения при специально заданной роли, а не свидетельство самопроизвольного намерения Claude вредить пользователю.
Такой участник занимал узкое место в цепочке производства, скрывал часть разведданных или ресурсов и предлагал убедительно звучащие, но вредные правила. Сбои игры и промежуточного кода давали правдоподобное объяснение его ошибкам. Команды почти никогда не распознавали саботажника; в одном случае подозрения вместо него пали на честного участника.
Отдельные агенты-наблюдатели читали только публичный канал команды. При настройке, допускающей не более 5% ложных обвинений честных участников, наблюдатели Opus 4.6, 4.7 и 4.8 обнаруживали 30-40% саботажников, а Sonnet 4.6 - 20%. Это экспериментальные наблюдатели, не действующая защитная система Anthropic.
Хорошая команда ещё не безопасная система
Результаты указывают на конкретную проблему будущих систем из множества агентов: успешная координация не гарантирует проверку чужих утверждений. Для такой работы нужны журнал действий, разделение ответственности и возможность сверить сообщение с первичными данными, особенно когда у участников разные владельцы и цели.
Ранее мы разбирали случаи отключения мониторинга агентами OpenAI и оценку рисков корпоративных агентов у Microsoft. Project EVE добавляет другую ситуацию: источник риска может выглядеть как полезный участник команды, а его вмешательство теряться среди настоящих технических ошибок.