AI-модели
Alibaba выпустила Qwen4-Max: 2,4 трлн параметров, более дешёвые задачи и 48 часов в лаборатории
Публикация:
Флагман Qwen вышел после превью с миллионным контекстом и API от $1,50 за миллион входных токенов. Alibaba показала рост эффективности и научные эксперименты, но её тесты не означают победу над всеми конкурентами.
Alibaba выпустила Qwen4-Max 16 ноября, спустя несколько дней после ограниченного превью. Теперь компания раскрыла устройство модели, результаты тестов, цены API и примеры длительной работы агентов. Главная ставка сделана на сложные проекты: модель должна пользоваться профессиональными программами, проверять промежуточный результат и возвращаться к задаче, а не ограничиваться одним ответом в чате.
Что означают 2,4 трлн параметров
Qwen4-Max построена как смесь экспертов, MoE: на каждый токен используется лишь часть модели. Основная сеть содержит 2,4 трлн параметров, из которых активируются 71 млрд. В техническом описании отдельно указаны ещё 328 млрд параметров N-gram Embedding. Поэтому популярная цифра «2,4 трлн» описывает основную сеть, а не исчерпывает все перечисленные разработчиком компоненты.
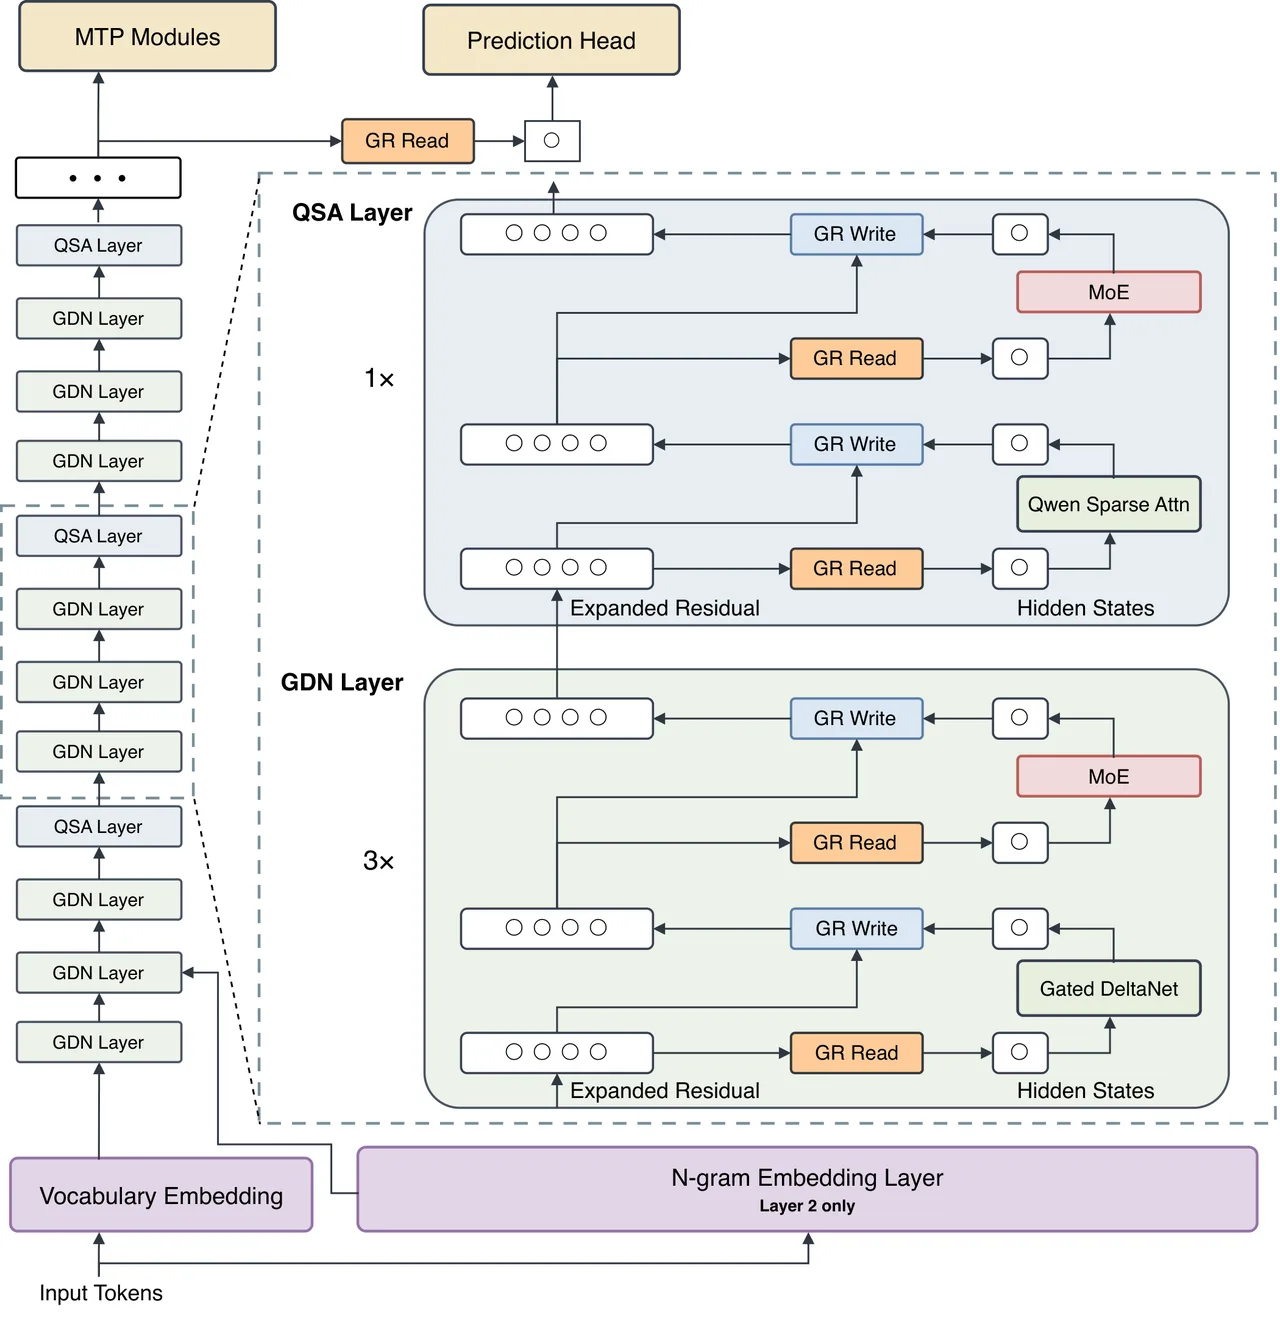
Модель принимает текст, изображения и видео, а выдаёт текст. Контекстное окно составляет миллион токенов. В новой архитектуре сочетаются Gated DeltaNet и разреженное внимание Qwen Sparse Attention: одни слои сжимают историю, другие выбирают важные участки контекста. Gated Residual помогает передавать информацию между слоями, а N-gram Embedding добавляет представления локальных сочетаний токенов.
В кодинге нет безоговорочной победы
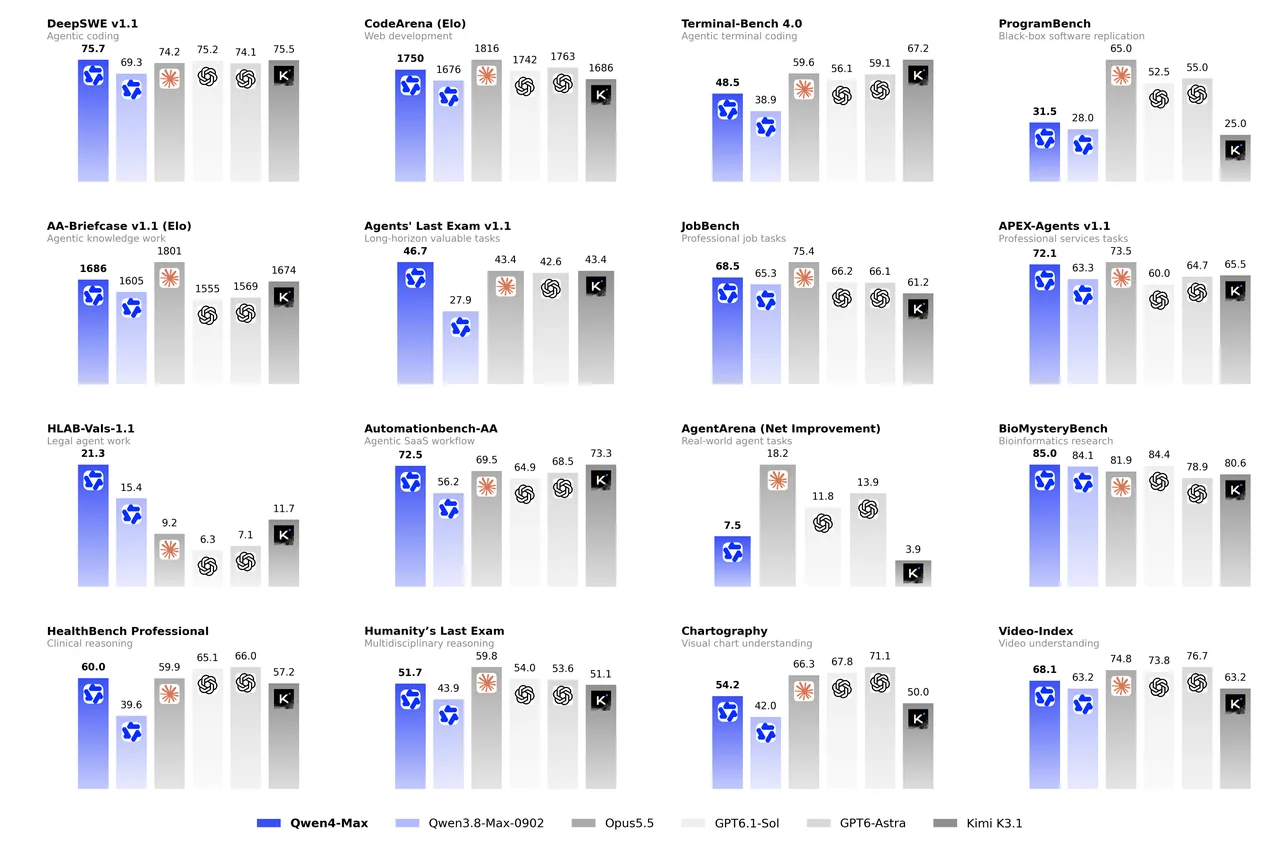
Собственная таблица Alibaba показывает рост относительно Qwen3.8-Max, но не лидерство во всех задачах. На DeepSWE v1.1 новая модель немного опережает Claude Opus 5.5, тогда как в работе через терминал и восстановлении программ уступает ей. Эти результаты нельзя свести к утверждению «Qwen обогнала Claude в программировании»: выбор теста заметно меняет картину.
| Тест | Qwen4-Max | Claude Opus 5.5 |
|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 |
| Terminal-Bench 4.0 | 48.5 | 59.6 |
| ProgramBench | 31.5 | 65.0 |
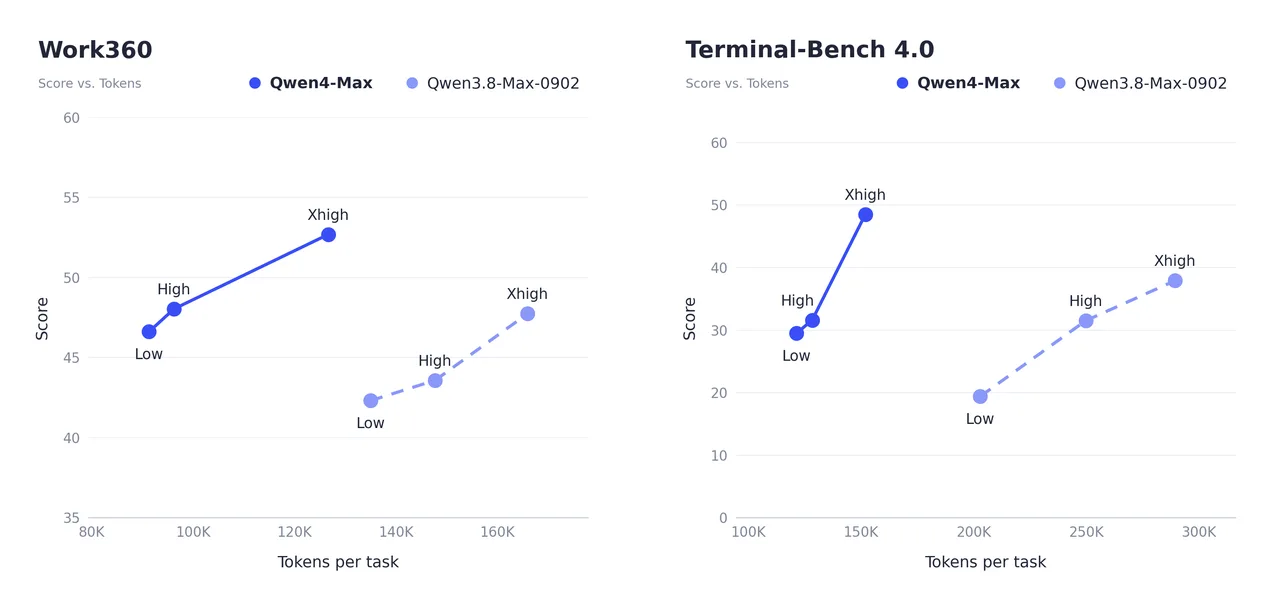
На собственном рабочем бенчмарке Work360 результат вырос с 47,74 до 52,69. Его таксономия охватывает 721 специализированную область. В этой же оценке средняя стоимость задачи снизилась с $4,43 до $1,67, то есть на 62%. Это измерение Alibaba для конкретного набора задач и настроек, а не обещание сократить любой пользовательский счёт на ту же величину.
Снижение расходов связано и с количеством токенов, и с тарифами. В Work360 при режиме рассуждения High новая модель использовала примерно на 35% меньше токенов, чем предшественница. Более высокий уровень усилий может менять и качество, и стоимость: сравнивать нужно одинаковые сценарии, а не только цену миллиона токенов.
Сколько стоит API и где доступна модель
На странице QwenCloud для Qwen4-Max указаны $1,50 за миллион входных токенов и $4,50 за миллион выходных. Попадание входных данных в неявный кэш стоит $0,075 за миллион токенов. Это отдельный льготный режим, а не обычная цена любого входного запроса; для создания явного кэша предусмотрены собственные тарифы.
Модель доступна на QwenCloud через Token Plan и API, а также в QwenWork, Qoder и QwenStudio. Карточка модели заявляет совместимость с API OpenAI и Anthropic, вызов функций, структурированный вывод и веб-поиск. В этом состоит важное отличие от ноябрьского превью: разработчик уже опубликовал обычные тарифы и техническое описание релиза.
Открытых весов Qwen4-Max в анонсе нет. Компания обещает выпустить меньшие модели семейства Qwen4 с открытыми весами, но точную дату не называет. Доступ к флагману через сервис не стоит путать с возможностью скачать его и запустить на собственном оборудовании.
48 часов на новую молекулу охладителя
Самая заметная научная демонстрация связана с охлаждением мощных чипов. По описанию Qwen, агент работал 48 часов в цифровой и физической лабораторной среде Mira от Deep Principle. Он сформировал пространство из 2,7 млн молекул, проводил отбор, расчёты свойств и планирование синтеза, а затем направлял работу автоматизированной лаборатории.
После четырёх циклов проектирования, синтеза и проверки был получен физический образец новой молекулы охладителя. Это результат демонстрации, о котором сообщает разработчик. Из него не следует, что жидкость уже готова к массовому использованию в дата-центрах: в анонсе не приведены данные о промышленной квалификации, сроке службы или коммерческом внедрении.
В отдельном исследовательском сценарии для болезни Альцгеймера модель работала с молекулами, нацеленными на NLRP3. Она выполнила 454 вызова инструментов и 3239 вычислительных оценок, разработав и оптимизировав 24 кандидата. Здесь результат остаётся вычислительным: сама Qwen пишет о необходимости дальнейшей лабораторной проверки. Это не испытанное лекарство и не доказанная терапия.
Игра, производство и проверка результата
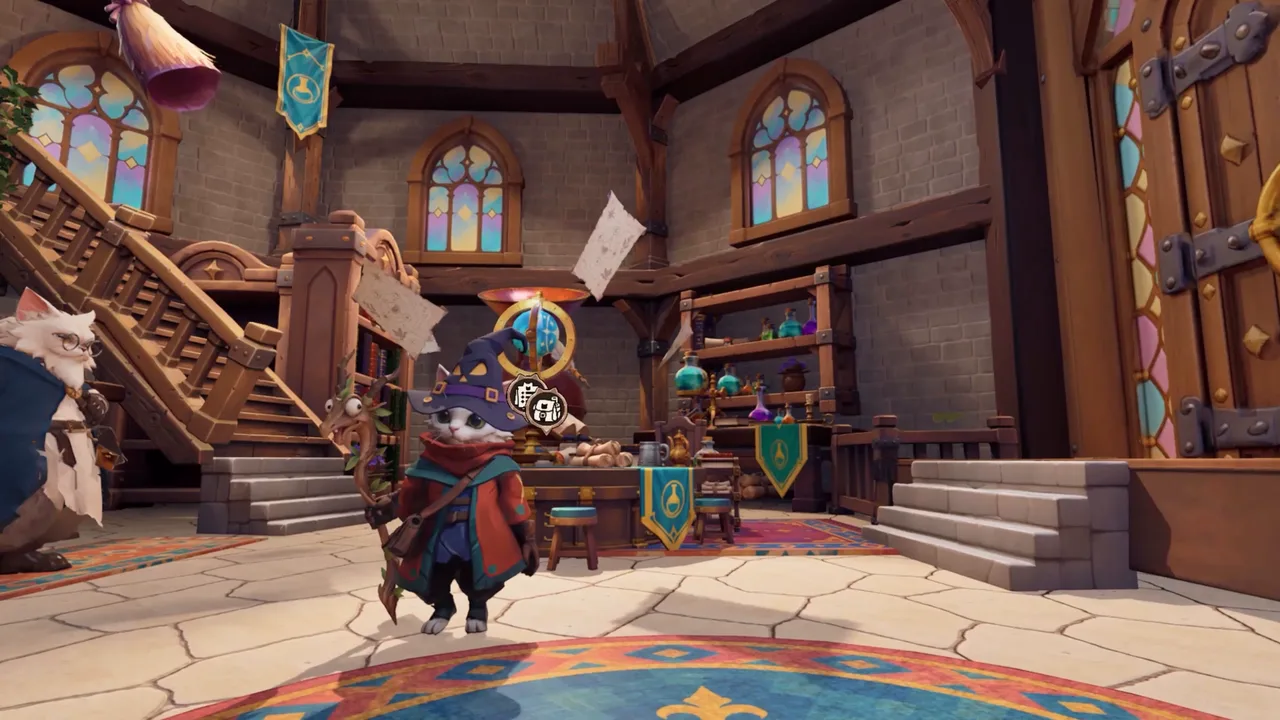
В демонстрации Meow of Magic Qwen4-Max собрала игру про кота-мага в Unreal Engine. По описанию команды, модель не только создавала сцену и механику, но и запускала игру, проверяла её по визуальной обратной связи и исправляла камеру, анимацию и темп. Поддержка Unity и Godot также заявлена в блоге.
В автомобильном производстве Alibaba показала планирование линий, проектирование деталей и проверку траекторий обработки. В одном демонстрационном примере ручная работа по программированию обработки детали сократилась примерно с 475 до 24 минут. Это частный пример с обратной связью и проверкой, а не подтверждённая средняя экономия для любого завода.
Для длительных проектов предусмотрен подход Live Delivery: агент сначала отдаёт пригодную к использованию версию, затем улучшает её итерациями. Пользователь может оценивать промежуточные результаты и менять направление работы до завершения всего проекта. Команда также объявила открытый плагин Qwen-Live-Delivery-Plugin.
Что уже известно, а что предстоит проверить
Релиз раскрывает намного больше, чем раннее превью: архитектуру, цены и подробные сценарии использования. При этом бенчмарки, заводские примеры и научные демонстрации нужно читать с указанием их происхождения. Они показывают, что именно проверяла Alibaba, но не заменяют независимую оценку надёжности в чужой рабочей среде.
Практический выбор здесь не сводится к числу параметров или одному месту в рейтинге. Для разработчика важны качество на собственных задачах, длительность выполнения, полный расход токенов и способность агента вовремя показать проверяемый результат. Опубликованные данные дают основания тестировать Qwen4-Max как более экономичное продолжение семейства, но не объявлять её универсально лучшей моделью.