Токены в нейросети и контекстное окно LLM: как считать
Что такое токены, как считать русский текст и планировать контекстное окно LLM. Вход, вывод, служебные данные и переполнение без неверных пересчётов.
Два текста с одинаковым числом слов могут занимать разный объём в запросе к модели. Она обрабатывает их в токенах, а границы токенов не обязаны совпадать со словами: отдельной единицей бывает часть слова, знак препинания или другая последовательность символов. Контекстное окно большой языковой модели (LLM, Large Language Model) задаёт предел доступного объёма для одного запроса.
Поэтому токены в нейросети приходится считать, когда вы загружаете длинный документ или планируете расходы на API, программный интерфейс доступа к модели. Счётчик страниц здесь не поможет. Нужны токенизатор выбранной модели, то есть программа разбиения текста на токены, полный состав запроса и место для ответа, а не только размер последнего сообщения.
Визуальная метафора ограниченного контекстного окна. Число и размер деталей не соответствуют реальным токенам.
Токены в нейросети: что это и почему они не равны словам
Токенизатор использует свой словарь и правила разбиения. Часто встречающаяся последовательность может стать одним токеном, а другая распадётся на несколько. Пробелы, регистр, пунктуация, числа и смешение языков влияют на результат. Поэтому два текста одинаковой длины в символах не обязаны иметь одинаковый размер для модели.
OpenAI объясняет, что количество токенов зависит от кодировки, языка и модели. Популярные приблизительные соотношения для английского текста нельзя объявлять универсальными правилами для русского. Особенно ненадёжно применять одно отношение к прозе, программному коду, таблицам и случайным идентификаторам.
Токену соответствует числовой идентификатор в конкретном словаре. Сам идентификатор не содержит общепринятого значения: одинаковый номер у разных токенизаторов может обозначать разные последовательности. При переносе данных между моделями сохраняйте исходный текст, а не рассчитывайте на совместимость списков идентификаторов.
Также не стоит считать, что визуальный символ всегда неделим. Некоторые токенизаторы работают с представлением текста через байты; граница токена способна пройти внутри многобайтового символа. Для объяснения разбиения полезно показывать байты или корректно восстановленный полный текст, чтобы не принять технический фрагмент за повреждение исходной строки.
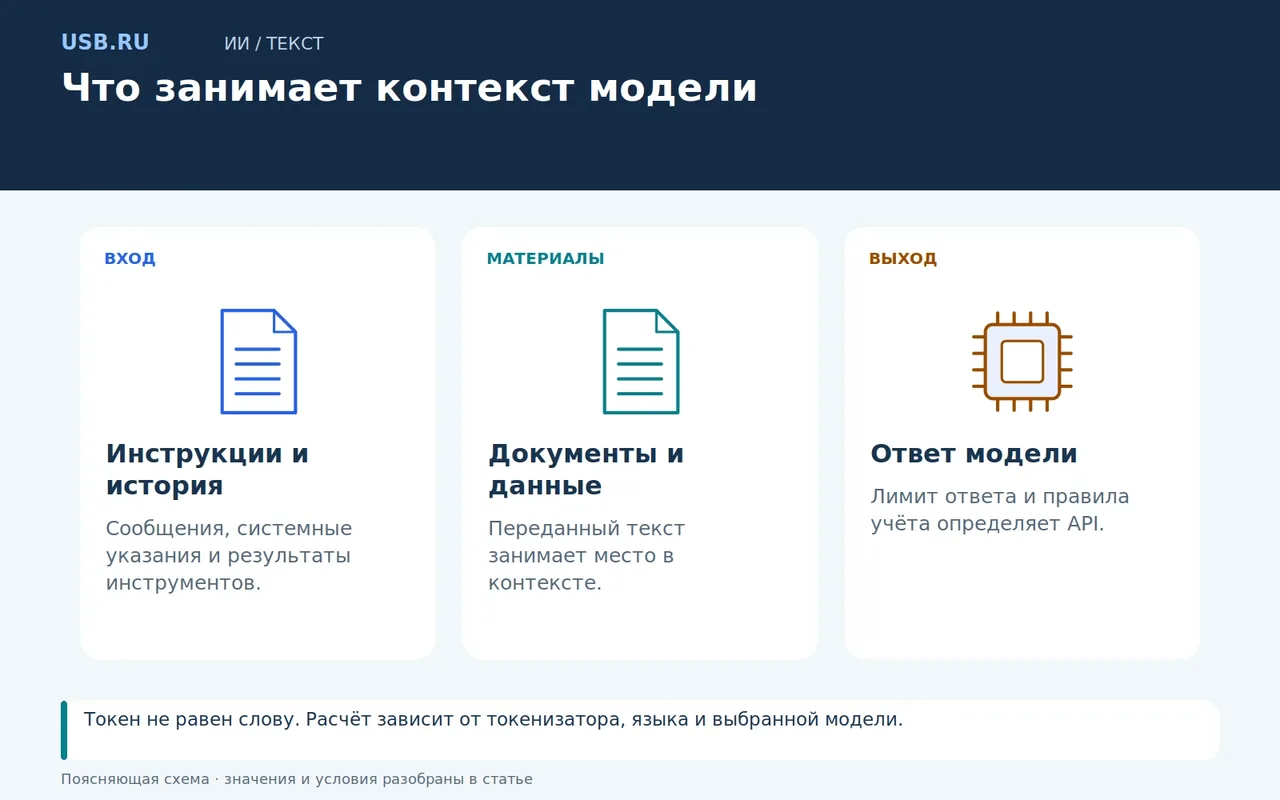
Схема: вход, материалы и ответ делят одно окно.
Как считать токены русского текста
Самый надёжный порядок начинается с выбора точной модели. После этого найдите её токенизатор или предусмотренный сервисом метод подсчёта. Калькулятор для другой модели подходит только для грубой предварительной оценки, даже если обе системы называются языковыми моделями.
Для обычного текста OpenAI предлагает библиотеку tiktoken. Следующий код выводит разбиение, число токенов и сведения о среде. В нём выбрана кодировка o200k_base; для другой модели может потребоваться другая кодировка. Для воспроизведения проверенного примера используйте Python 3 и установите пакет командой python -m pip install tiktoken в отдельной виртуальной среде Python.
from importlib.metadata import version
import tiktoken

text = "Смартфон записывает видео на внешний SSD."
encoding = tiktoken.get_encoding("o200k_base")
tokens = encoding.encode(text)

print("tiktoken:", version("tiktoken"))
print("encoding:", encoding.name)
print("token_count:", len(tokens))
print("token_ids:", tokens)
print("token_bytes:", [encoding.decode_single_token_bytes(t) for t in tokens])
assert encoding.decode(tokens) == text
При выполнении этого примера в tiktoken с кодировкой o200k_base фраза «Смартфон записывает видео на внешний SSD.» дала 11 токенов. Проверка обратного восстановления строки прошла. Результат относится только к указанной фразе и кодировке: это не универсальный счётчик для всех моделей и не полный размер API-запроса.
Для повторяемого эксперимента зафиксируйте установленную версию пакета, текст без изменений и название кодировки. Если считаете текст для реального запроса, используйте соответствие модели и кодировки из документации, а не название из этого демонстрационного фрагмента.
Первичная загрузка файлов токенизатора может требовать сети. Для чувствительного текста отдельно проверьте, где выполняется подсчёт и какие данные отправляет выбранный веб-калькулятор. Сам термин «токенизация» не сообщает ничего о расположении сервера.
Что занимает контекстное окно LLM
В запросе находится больше информации, чем последнее сообщение пользователя. Это могут быть инструкции приложения, выбранная история диалога, содержимое документов, описания инструментов и результаты их вызовов. У мультимодальных систем, принимающих не только текст, изображения и другие входы тоже учитываются по правилам модели.
В документации OpenAI об управлении контекстом окно рассматривается вместе с входными, выходными и reasoning-токенами, которые модель расходует на внутреннее построение ответа. Поэтому бюджет нужно планировать так, чтобы оставалось место для ответа. Точные правила и пределы следует брать для выбранной модели и метода API.
| Часть запроса или работы | Почему её нужно учитывать |
|---|---|
| Инструкции и текущий вопрос | Задают задачу и занимают входной объём |
| Переданная история | Предыдущие сообщения могут снова входить в обработку |
| Документы и результаты поиска | Добавляют содержимое, нужное для ответа |
| Описания инструментов | Описания команд и их параметров являются частью доступного модели контекста |
| Генерируемый вывод | Ограничивается отдельным пределом и общими правилами окна |
| Скрытые служебные элементы | Полный учёт может отличаться от видимого текста |
Большой лимит не означает, что все загруженные когда-либо файлы одновременно находятся в запросе. Приложение может выбирать фрагменты, хранить документы отдельно или сокращать историю. Видимый интерфейс чата и фактический ввод модели относятся к разным уровням системы.
Почему подсчёт строки не равен подсчёту запроса
Локальное кодирование абзаца даёт полезный результат для этого абзаца. Однако полный API-запрос содержит структуру сообщений и иногда дополнительные представления данных. Если сложить только видимые тексты, итог может отличаться от показателя использования сервиса.
В руководстве OpenAI по подсчёту токенов описан отдельный метод подсчёта входа Responses API. Он принимает сообщения, инструменты и поддерживаемые вложения в структуре запроса, учитывая также форматирование. Для проверки лимита перед отправкой рабочего запроса такой подсчёт полезнее приблизительного пересчёта символов.
После выполнения сравнивайте прогноз с фактическими полями использования. Различайте вход и выход, а также подкатегории вроде кешированных входных токенов. Кеширование, повторное использование уже обработанной части входа, может менять стоимость и объём вычислений, но не превращает переданное содержимое в бесплатное расширение контекстного окна.
Если видимая часть ответа короткая, это ещё не означает маленького полного вывода: отдельные модели учитывают внутренние и структурные токены. Уточните, какие токены ограничивает параметр максимального вывода, а не подбирайте его по желаемому числу слов.
Что происходит при переполнении
Реакция зависит от API и приложения. Запрос может быть отклонён, история может сократиться, либо система использует предусмотренное сжатие контекста. Не следует предполагать, что модель сама незаметно и без потерь выберет всё важное.
Рассмотрим условное окно: если полный вход занимает большую его часть, для продолжения остаётся меньшая часть в рамках такой простой модели бюджета. Однако отдельный предел вывода может быть меньше.
Сокращение истории имеет последствия. Если удалить раннее требование о валюте расчётов, последующий ответ может перестать ему следовать. Если заменить договор кратким резюме, точная формулировка исключения способна исчезнуть. Поэтому после сокращения проверяйте, сохранились ли условия, необходимые для текущего решения.
Для больших материалов полезнее разбить работу на этапы: извлечь вопросы, выбрать соответствующие разделы, сохранить подтверждающие фрагменты и затем сформировать ответ. Но и этот процесс нуждается в проверке полноты: недоступный модели раздел не сможет поддержать вывод.
Как организовать длинную задачу
Сначала определите, что должно получиться на выходе. Короткий ответ по одному пункту и подробное сравнение всего документа требуют разного входа и резерва генерации. Не заполняйте окно материалом, который никак не помогает задаче.
Далее составьте полный запрос, посчитайте его подходящим инструментом и проверьте лимиты модели. Удаляйте повторы и устаревшие промежуточные результаты, сохраняя решения и ограничения. Для каждого важного вывода оставляйте ссылку на исходный фрагмент, чтобы сокращённое представление можно было проверить.
Наконец, проверяйте завершённость ответа. Если текст оборвался, увеличения окна может быть недостаточно: причина иногда в отдельном лимите вывода. Если потеряна ранняя деталь, проверьте состав фактически переданной истории. Диагностика начинается с наблюдаемых параметров запроса, а не с предположения о «плохой памяти» модели.
Частые вопросы
Сколько русских слов помещается в тысячу токенов?
Единого точного числа нет. Результат зависит от текста и токенизатора. Для предварительной оценки посчитайте характерный фрагмент, а для проверки лимита используйте весь фактический вход.
Большое окно гарантирует правильный ответ по документу?
Нет. Вместимость позволяет передать больше информации, но не подтверждает правильность извлечения, расчётов и выводов. Ключевые утверждения всё равно сопоставляют с источником.
Один токен стоит одинаково у всех моделей?
Нет. Условия использования и тарифные категории определяются поставщиком и продуктом. Сравнение бюджета требует актуальных тарифов и собственного распределения входа и выхода.
Можно ли посчитать изображения тем же способом, что текст?
Обычный текстовый токенизатор этого не делает. Используйте документацию и метод подсчёта мультимодального входа конкретного сервиса; размер файла в байтах не заменяет такой расчёт.
Перед отправкой большого документа посчитайте запрос вместе с инструкциями, историей и инструментами. Затем оставьте предусмотренный моделью запас на вывод. Если текст всё равно обрывается, посмотрите причину завершения и отдельный предел ответа: увеличение входного окна решает не каждую такую проблему.