Зачем нейросетям «сон»: как SLEEP помогает закреплять новые знания
Закрепление новых знаний в параметрах модели: как устроен Sleep, что показали эксперименты и почему это ещё не готовая память чат-бота.
Языковая модель может прочитать инструкцию, разобраться в незнакомом устройстве и ответить на вопросы по документу. Но успешная работа с файлом ещё не означает, что она чему-то научилась надолго. Когда нужный текст исчезнет из доступного контекста, вместе с ним может исчезнуть и возможность правильно ответить.
Исследователи предложили подход Sleep: чередовать получение информации с отдельными периодами её закрепления. Во время такого «сна» модель перерабатывает накопленный материал и обновляет параметры. Цель состоит в том, чтобы сохранять новые знания, не разрушая прежние навыки. Google Research описала этот подход в публикации от 27 октября.
У исследования более длинная история, чем можно предположить по октябрьским заголовкам. Работа Language Models Need Sleep появилась на arXiv 2 июня 2026 года, а её вторая версия датирована 10 июля. Речь идёт об исследовательском методе, а не о новой функции памяти, которую уже можно включить в Gemini. Научная работа.
Слово «память» в разговорах об ИИ объединяет несколько разных механизмов. Для пользователя они могут выглядеть одинаково: помощник вспомнил имя, нашёл старый документ или применил правило. Внутри системы это разные процессы.
| Механизм | Что происходит |
|---|---|
| Контекст диалога | Модель использует сведения, переданные в текущем запросе: сообщения, инструкции, документы |
| Внешняя память | Приложение сохраняет факты отдельно и возвращает подходящие записи в последующие запросы |
| Знания в параметрах | Информация закрепляется при обучении и влияет на работу самой модели |
Например, помощник может помнить предпочтение пользователя благодаря записи во внешней базе. При следующем обращении приложение найдёт эту запись и добавит её к вопросу. Такой принцип используется в системах памяти вроде Mem0, которую мы разбирали отдельно. Для этого не требуется заново обучать языковую модель после каждой беседы.
Похожим образом устроен поиск по документам с последующей генерацией ответа, или RAG. Система извлекает подходящие фрагменты из внешнего хранилища и передаёт их модели. Источник остаётся отдельно, его можно обновлять, а найденный текст помогает сформировать ответ. В исходной работе о RAG этот подход описан как сочетание знаний в параметрах и внешней памяти.
Sleep исследует другой способ сохранения информации: перенос опыта в параметры самой модели.
Обычное дообучение уже позволяет менять эти параметры. Трудность возникает, когда обновления следуют одно за другим. Осваивая новую задачу, система может ухудшить результаты на старых. Этот эффект называют катастрофическим забыванием. Он особенно мешает помощнику, от которого ожидают накопления опыта: новая инструкция должна расширять его возможности, сохраняя ранее освоенные.
С этой проблемой связано направление Nested Learning. В нём модель рассматривается как система компонентов с разной частотой обновления. Одни быстро реагируют на поступающую информацию, другие меняются медленнее и удерживают более устойчивые знания. Исследовательская архитектура Hope использует такую организацию памяти. Объяснение Google Research.
Аналогию можно представить на работе с технической документацией. Пока инструкция лежит перед вами, достаточно находить нужные страницы. Чтобы пользоваться устройством без постоянного обращения к тексту, приходится усвоить правила и связи между ними. При этом буквальные формулировки, номера деталей и исключения всё равно удобнее проверять по оригиналу. Запоминание и доступ к источнику решают разные задачи.
В Sleep выделены два состояния. Во время активной фазы система получает новые данные. Затем наступает период внутренней переработки накопленного материала. Авторы разделяют его на закрепление памяти и «сновидения».
Закрепление построено вокруг дистилляции: более устойчивые компоненты учатся воспроизводить полезные знания и поведение предыдущего состояния модели. Для новой информации выделяется дополнительная ёмкость. Такой перенос авторы называют Knowledge Seeding. Задача состоит в сохранении освоенного при дальнейшем обучении. Описание метода.
«Сновидения» относятся к работе с синтетическими упражнениями. Модель создаёт обучающие примеры, система отбирает полезные и использует их для дальнейшего обучения. В результате появляются повторение и тренировка на материале, который не обязательно каждый раз готовит человек. Все эти операции выполняются внутри заданной исследователями архитектуры и правил обучения. Биологический термин здесь служит метафорой вычислительного процесса. Объяснение этапов Sleep.
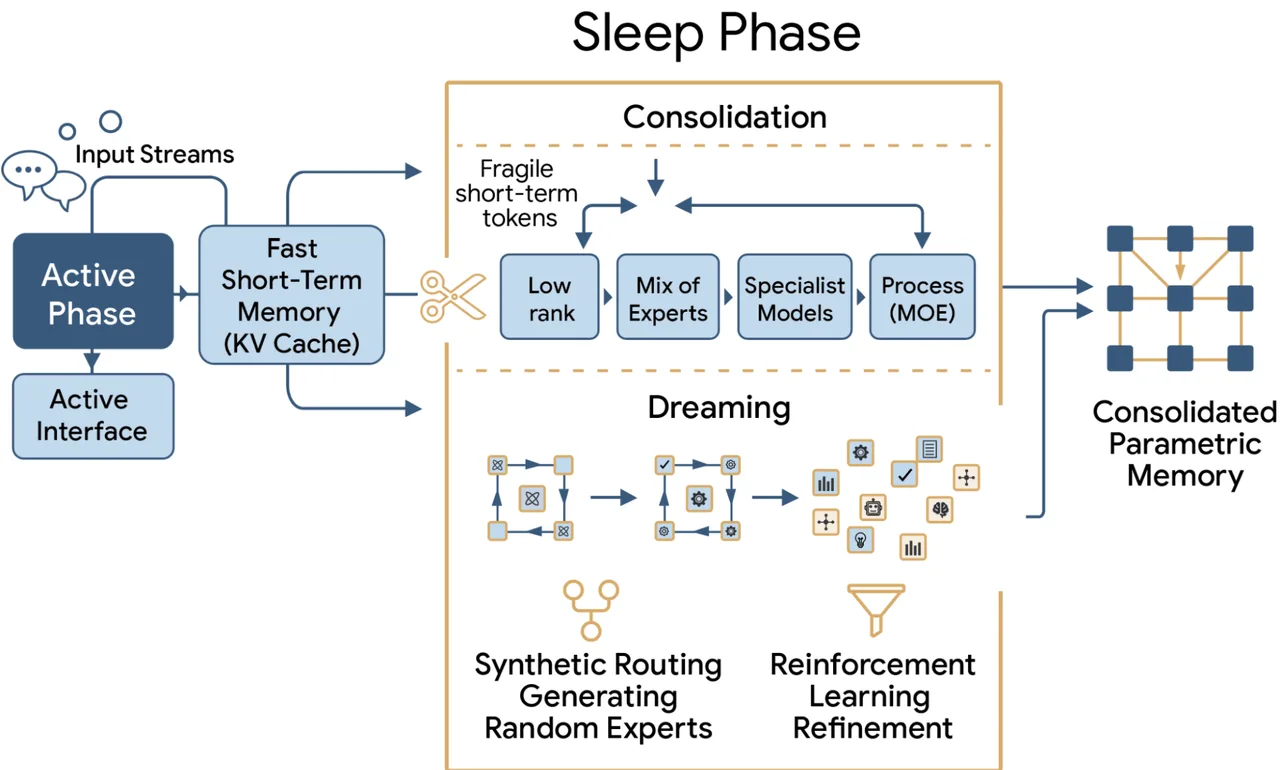
Фаза Sleep включает закрепление памяти и обучение на синтетических примерах. Схема: Google Research.
Самая заметная цифра в пересказах исследования: 10 миллионов токенов. Авторы сообщают об устойчивых результатах на длинных последовательностях в BABILong. Но смысл этой оценки определяется устройством теста.
BABILong проверяет рассуждения по фактам, распределённым среди большого объёма текста. Модели нужно найти сведения и связать их для ответа. Например, правильный вывод может зависеть от нескольких сообщений, находящихся далеко друг от друга. Это позволяет проверять, как увеличение длины входа влияет на выполнение определённой задачи. Описание BABILong.
Поэтому результат на таком тесте нельзя превращать в обещание полного понимания любой библиотеки документов. В работе Sleep малые модели специально дообучались по протоколу бенчмарка. Сравнение относится к этим условиям. Отдельно авторы показали улучшение математических результатов: у Qwen3-8B оценка на AIME-24 выросла с 73,8 до 79,2 по метрике average@16. Эксперименты.
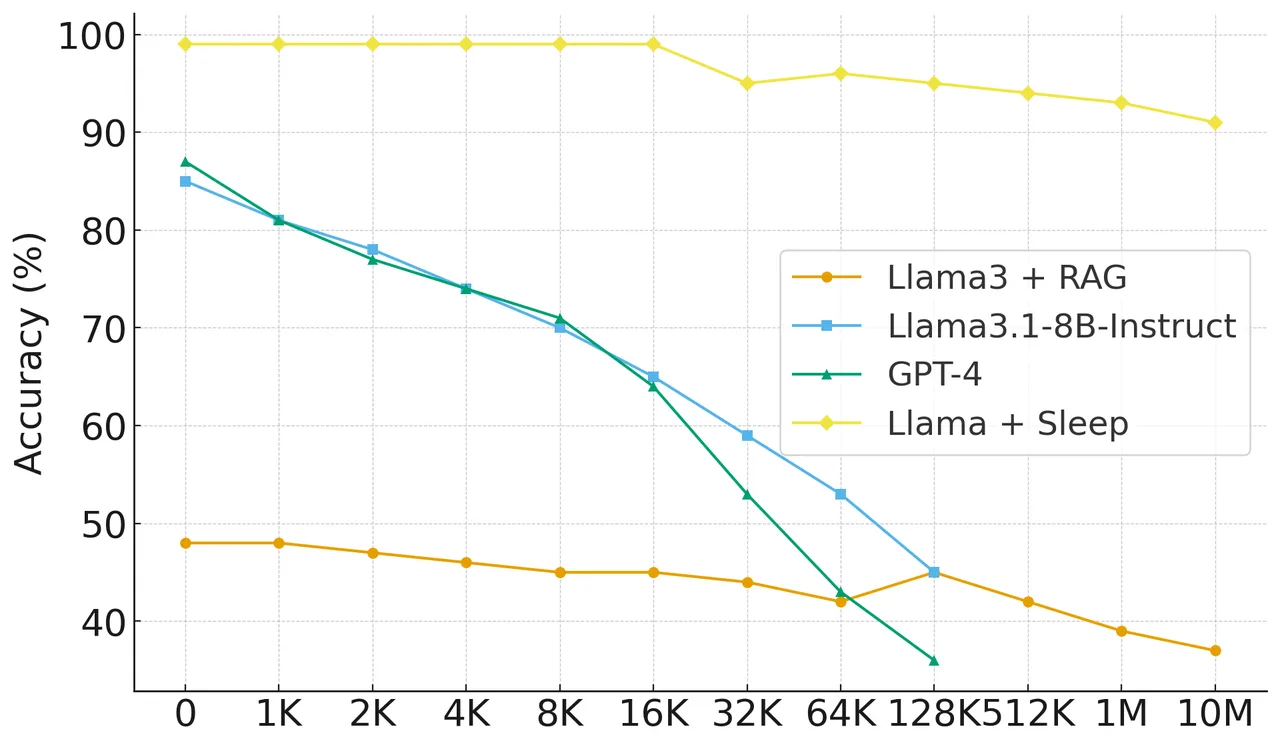
Точность ответов при увеличении контекста в эксперименте BABILong. Условия настройки моделей описаны в тексте. График из Language Models Need Sleep: Али Бехруз и соавторы, CC BY 4.0.
Число токенов также не стоит переводить в фиксированное количество слов или страниц. Результат зависит от языка, текста и токенизатора. Один и тот же объём прозы, кода и таблиц занимает разное место. Этот вопрос подробнее разобран в нашем руководстве о токенах и контекстном окне.
Для готового помощника остаётся ещё один существенный вопрос: сколько стоит такое обучение. «Сон» занимает вычислительные ресурсы. Нужно подготовить упражнения, отобрать их, выполнить обновления и проверить результат. В приложении к работе авторы отдельно сравнивают эффективность при одинаковом числе шагов и время достижения выбранного качества: эти способы подсчёта дают разные выводы. Раздел об эффективности.
Это влияет на возможное устройство продукта. Допустим, технический помощник регулярно получает документацию по новым приборам. Внешний поиск уже позволяет ему обращаться к этим файлам. Если метод закрепления знаний удастся перенести в надёжный рабочий сервис, часть повторяющихся правил и навыков можно будет усваивать в ходе периодических обновлений. Тогда потребуется проверять обе стороны результата: освоена ли новая информация и сохранилось ли качество прежней работы.
Исходные документы при этом продолжат выполнять свою роль. Для точной цитаты, изменившейся характеристики или спорного требования нужен проверяемый источник. Закреплённые навыки могли бы помогать работать с ним, находить связи и выполнять знакомые операции.
Sleep пока показывает исследовательский способ организовать такое накопление опыта. Чтобы он стал повседневной возможностью помощников, предстоит подтвердить его надёжность на длительных рабочих задачах и определить стоимость регулярных обновлений. Именно эти проверки позволят понять, сколько полезного модель действительно сохраняет после очередного периода обучения.