Новости ИИ за неделю 19–25 октября 2026: Kimi K3.1 почти догнала Claude Opus 5.5, а голосовой ИИ Block работает на MacBook
Главные ИИ-модели недели с 19 по 25 октября 2026 года: Kimi K3.1 Pro, MiniMax M3.1 Flash, Carbon-X для анализа ДНК, агент Claude Duet, голосовая Dessa и Fibo 2.0. Что они умеют, сколько стоят и на каком железе запускаются.
Moonshot AI готовит открытые веса модели «класса 3T», и на тесте работы в терминале она отстаёт от Claude Opus 5.5 меньше чем на процентный пункт. Hugging Face выпустила модель, которая читает ДНК почти так же хорошо, как флагман OpenAI, и при этом умещается в 14,8 млрд параметров. Block показала голосовую модель, которая выучила язык, ни разу не увидев текста, и работает на MacBook.
За неделю с 19 по 25 октября 2026 года вышли или были анонсированы почти два десятка моделей, и большинство из них открытые или обещают стать открытыми. Многие разработчики сразу пишут, на каком железе модель запускать, и чаще всего это уже не стойка в дата-центре. Ниже разбор по направлениям. Цифры приведены по данным самих компаний, если не сказано иное: независимых замеров пока почти нет.
Языковые модели: открытые догоняют
Самый крупный релиз сделала Moonshot AI. Kimi K3.1 Pro построена на K3, и компания называет её своей самой сильной открытой моделью «класса 3T», то есть примерно на три триллиона параметров. Точное число и архитектуру Moonshot не раскрывает. Контекст 1 млн токенов. Есть и версия Highspeed, которая, по заявлению, работает в два-три раза быстрее.
На Terminal-Bench 4.0 K3.1 Pro набирает 65,7%. У Claude Opus 5.5 там 66,4%, у GPT-6 Astra 58,2%. На BenchCAD с инструментами разрыв с закрытыми моделями больше: 92,7% против 96,2% у Opus 5.5. На внутреннем стресс-тесте галлюцинаций доля ошибочных утверждений упала с 23,4% до 8,3%. Kimi сама предупреждает, что это не частота ошибок в обычной работе.
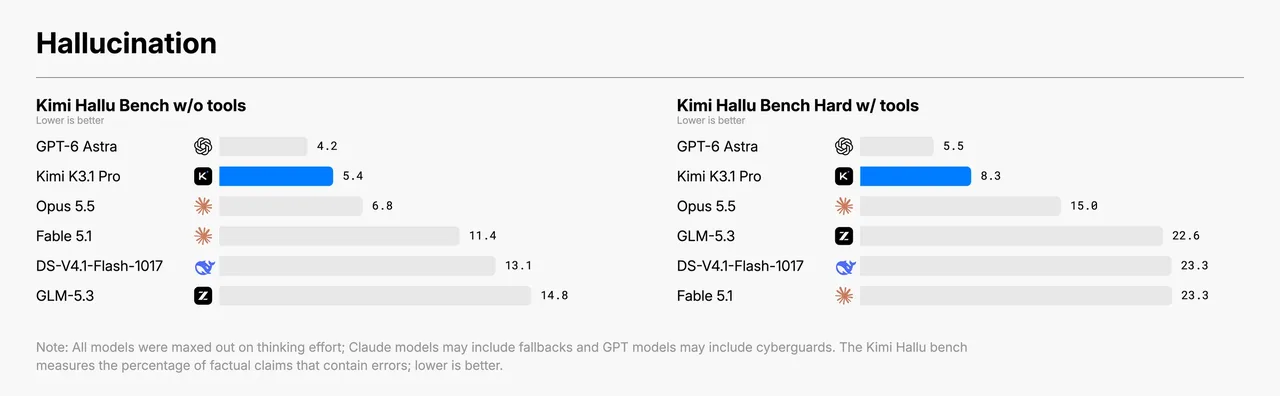 Доля утверждений с ошибками на тестах Kimi, чем меньше, тем лучше. На сложном тесте с инструментами у K3.1 Pro 8,3%, меньше только у GPT-6 Astra. Изображение: Moonshot AI
Отдельно компания пишет о безопасности. Из открытой версии убрали данные по кибербезопасности на этапах дообучения и обучения с подкреплением. Внутренний вариант без этих ограничений набирает на тесте xdev-bench-hard 90,5, публичный 81,0. По оценке Kimi, в киберзадачах открытая модель отстаёт от закрытых флагманов минимум на три месяца. После октябрьской истории с PHP, о которой мы писали в статье «Сайты выключают сами», такая оговорка стала почти обязательной.
Модель уже работает в приложениях Kimi, в Kimi Code и через API. Веса обещаны до 4 ноября, лицензия пока не названа, требований к железу нет. Пока весов нет, слово «открытая» остаётся обещанием.
MiniMax выпустила M3.1 Flash 19 октября и сделала ставку на цену. 1 млн входных токенов стоит $0,15, выходных $0,60, кэшированного входа $0,015. По словам MiniMax, агентные задачи обходятся на 70% дешевле, чем на прошлой версии. Скорость вывода больше 200 токенов в секунду, медиана выше 170. На DeepSWE v1.1 модель набирает 73,7%, на OSWorld V2, где модель управляет компьютером, 61,7. Размер не раскрыт, сказано лишь о «более агрессивной разреженности». Веса обещаны позже.
 MiniMax M3.1 Flash: $0,15 за миллион входных токенов. Изображение: MiniMax
Для агентов цена важнее рекордов. Агент вызывает модель тысячи раз за задачу, и итоговый счёт зависит от стоимости токена, а не от лучшего балла в таблице.
Среди моделей поменьше выделяются три. Alpha-Innovator выложила Sage-A1.5, агентную MoE на 35B параметров с контекстом 256K. Она умеет раздавать работу параллельным субагентам и по желанию проверять себя. Цифр в тексте страницы нет, только картинка со сравнением, зато веса уже на Hugging Face. Модель на 35B можно запустить на мощной рабочей станции.
MemTensor взялась за память агентов. В MemT-1.0 прошлый опыт хранится в самой модели, а не в окне контекста. У версии Nano 36B параметров, из них активны 3B. Состояние памяти имеет постоянный размер, и при истории в 128 тысяч токенов хранилище получается примерно в 66 раз меньше обычного KV-кэша, который и забивает видеопамять. Разработчики честно пишут, что на длинных историях системы с текстовой памятью пока точнее. Лицензия Apache 2.0.
inclusionAI из Ant Group выпустила Ling-3.0-flash-Santé, медицинскую версию своей модели: 124B параметров, из них 5,1B активных, лицензия MIT. Разработчики сразу предупреждают, что это исследовательская модель, а не медицинское изделие. Ставить диагнозы, назначать лечение или сортировать пациентов она не должна.
ИИ для биологии
Carbon-X от Hugging Face Bio читает и пишет ДНК так же, как текст. Модель на 14,8B параметров построена на Qwen3-14B. ДНК разбита на блоки по шесть нуклеотидов и добавлена в общий словарь, отдельного энкодера для последовательностей нет. На дообучение ушло около 302 млрд токенов, из них 55% сырой ДНК, остальное английский текст, биологическая литература и инструкции.
Модель отличает безвредные мутации от патогенных, находит регуляторные участки генов, определяет группу организмов и объясняет свой ответ. Средний балл на наборе тестов 66,7%, у GPT-6.1 Sol (Max) 67,5%. Исходную Qwen3-14B Carbon-X обходит на 27 пунктов. Замеры сделали сами авторы. Лицензия Apache 2.0, в работе участвовали Zhongguancun Academy, Институт Telethon и Неаполитанский университет имени Федерико II.
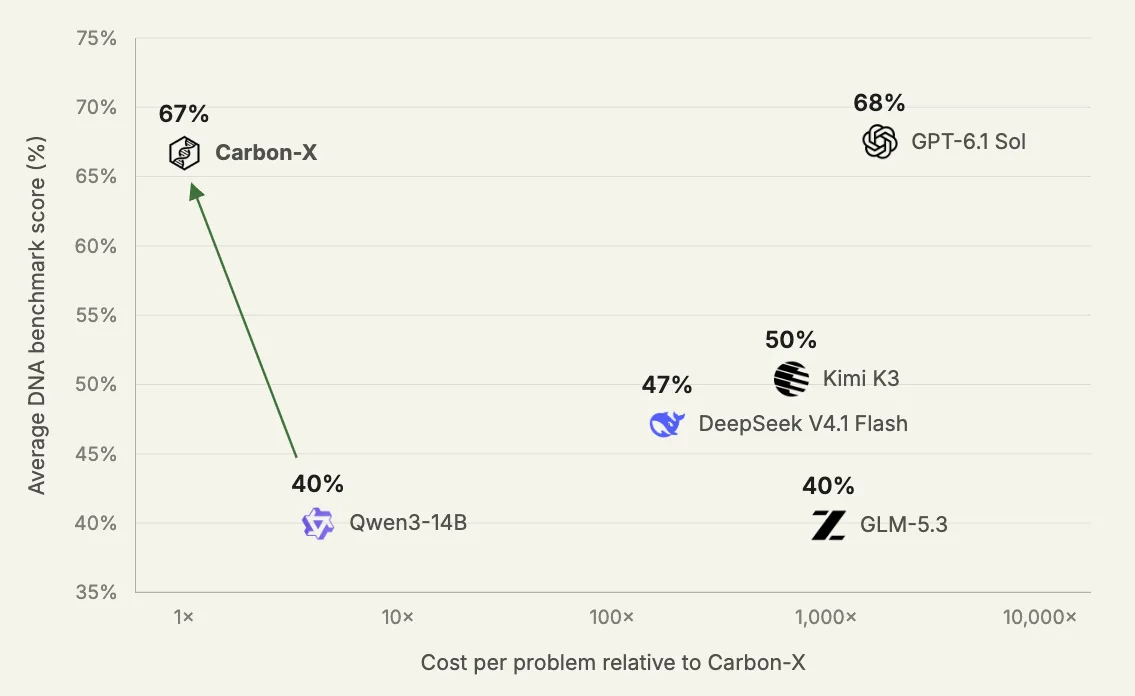 Средний балл на тестах по ДНК и стоимость одной задачи относительно Carbon-X (логарифмическая шкала). Значения на графике округлены, точные приведены в тексте. Изображение: Hugging Face Bio
OpenAI 21 октября показала другой подход, вместе с PerturbAI и Scripps Research: вместо одной большой модели много одинаковых агентов. 1946 копий GPT-Rosalind, модели OpenAI для наук о жизни, получили по одному генетическому нарушению из CRISPR-атласа мозга мыши. Каждый агент изучал изменения в клетках, искал литературу и предлагал объяснение, затем система свела отчёты и ранжировала гипотезы. Весь анализ занял 32 минуты.
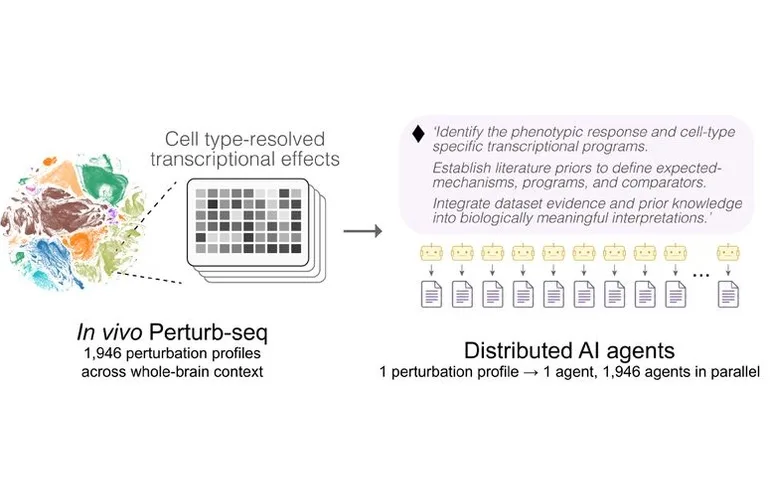 1946 профилей генетических нарушений из атласа мозга мыши, каждый разбирает свой агент. Изображение: R&D World
Агенты собрали 7586 источников, а одиночный агент на тех же данных находил около 11. Текста исходного исследования они не видели, но совпали с ним или уточнили его выводы в 48 случаях из 55. Тридцать биологов со степенью вслепую проверили ранжирование и в целом с ним согласились. Оговорок две. Результаты опубликованы в препринте без рецензии, а сравнение с «месяцами работы людей» посчитано на допущениях, его никто не измерял. Работа изложена по публикации R&D World.
Агент, который работает, пока вы спите
21 октября Anthropic открыла исследовательское превью Claude Duet. Это отдельное приложение-агент на Claude Opus 5.5 для специалистов и малого бизнеса. Duet работает в собственной виртуальной машине с браузером, поэтому ноутбук и телефон можно выключить. Утром он присылает сводку по подключённым сервисам, а днём раз в несколько часов проверяет их и пишет, только когда что-то требует внимания. Коннекторов больше 6000, среди них Gmail, Slack, QuickBooks, Stripe, DocuSign и Shopify.
 Часть сервисов, к которым подключается Claude Duet. Изображение: Anthropic
Интереснее всего здесь правила. Читать и готовить черновики агент может сам. Перед отправкой письма, оплатой, подписью документа или удалением он показывает действие и ждёт подтверждения. Торговать ценными бумагами и переводить деньги между счетами ему нельзя даже с разрешения пользователя, а номера карт и документов он не принимает. Слабые места Anthropic перечисляет сама: агент может неверно понять переписку или ошибиться со срочностью, хуже справляется с личными поручениями и пока не показывает пользователю свой браузер.
Доступ через лист ожидания, сначала для подписчиков Pro и Max в США. О том, откуда взялись личные агенты и чем они различаются, мы писали в статье «От OpenClaw к личным AI-агентам».
Голос: от собеседника до диктофона
Dessa от Block, пожалуй, самая необычная модель последних недель. Это модель «речь в речь» с полным дуплексом, то есть она слушает и говорит одновременно, как человек. Обучали её только на звуках человеческой речи, без текста и без чужих предобученных моделей. Dessa смеётся посреди фразы, поддакивает, слышит сарказм и подсказывает собеседнику забытое слово. По словам Block, модель выучила язык на словах, которых в сотни раз меньше, чем у текстовых моделей.
 Кадр из демонстрационного видео Block: разговор с Dessa. Изображение: Block
Для читателей USB.RU важна строка про железо. Dessa работает локально на MacBook Pro M4 Max или мощнее, а обучение уместилось в одну стойку NVIDIA GB200 NVL72. Разработала её небольшая лаборатория Block из бывших сотрудников торонтского стартапа Dessa, она подчиняется Джеку Дорси. Бенчмарков, списка языков и лицензии нет, доступ через лист ожидания.
Ming-3.0-TTS от inclusionAI решает обратную задачу: синтез речи с открытыми весами. Есть плотная версия на 0,5B и MoE на 7,9B с 1,3B активных параметров. Модель создаёт голос по текстовому описанию или клонирует его по образцу и понимает режиссёрские указания по эмоции и ударению. В рейтинге Artificial Analysis она первая среди открытых моделей по управляемому голосу. Языков семь, русского среди них нет. Клонировать голоса реальных людей без их согласия разработчики запрещают.
Underdog Bark 3.0 распознаёт речь прямо на устройстве. Модель весит 163 МБ, основана на NVIDIA Parakeet и работает только с английским. Средняя ошибка по словам 4,94% на семи наборах Open ASR Leaderboard, примерно как у самого Parakeet. Обзоры называют результат сильным, но не тем «лучшим в мире», о котором говорит компания. Веса открыты под CC-BY-4.0.
Картинки, вектор и видео
Fibo 2.0 от Bria объединяет генерацию и редактирование изображений в одной модели на 8B параметров. Она редактирует по инструкции, с масками и несколькими референсами, и лучше прежних версий рисует текст и анатомию. На 20 октября в Artificial Analysis она первая среди открытых моделей по редактированию. Главный довод Bria в том, что модель обучена только на лицензированных изображениях. Обратная сторона в лицензии CC BY-NC 4.0: бесплатно только для некоммерческих задач, бизнесу нужен договор.
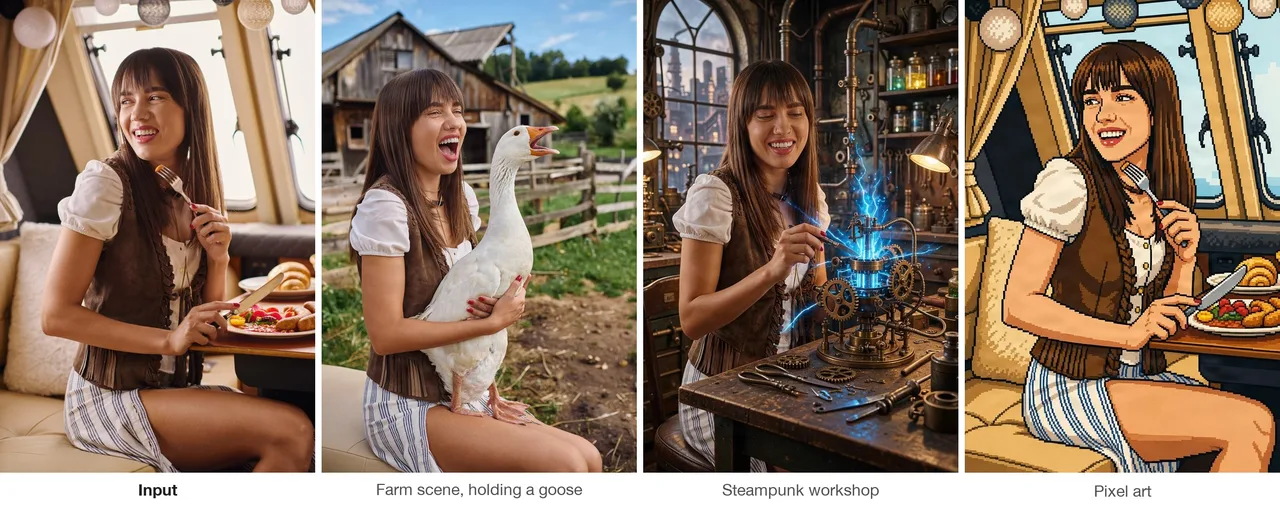 Редактирование в Fibo 2.0: исходный кадр и три правки по текстовым инструкциям. Изображение: Bria
Ideogram Vector сразу выдаёт редактируемый SVG по тексту или переводит готовую картинку в вектор. Это нужно для логотипов, наклеек и печати, где растровая картинка не годится. Векторизация стоит $0,10, генерация с референсами на высшем качестве $0,32.
FastH3 Omni от команды FastVideo из Hao AI Lab (UCSD) представляет собой открытую дистиллированную версию видеомодели MiniMax H3. Она делает ролик со звуком по тексту, картинке, видео и голосу. Шагов генерации 8 вместо 50. Пятисекундный ролик по одной картинке на восьми GB200 получается за 5,67 секунды вместо 35,44. Для домашнего запуска есть чекпоинты NVFP4 под RTX 5090 и DGX Spark и поддержка ComfyUI.
3D и модели мира
JST-2 от Viggle строит трёхмерные сцены, персонажей и движение в одном общем мире. Сцена по промпту или фотографии собирается примерно за секунду на B200 и стоит меньше цента. Персонажи получаются сразу анимированными, без отдельного риггинга. В слепых тестах их предпочли моделям Meshy 7.1 в 58,4% случаев и Tripo H3.1 в 73,2%. Столкновения предметов пока считаются по жёстким правилам, обучаемую физику обещают в JST-3. Попробовать можно бесплатно в браузерном инструменте PINOC.
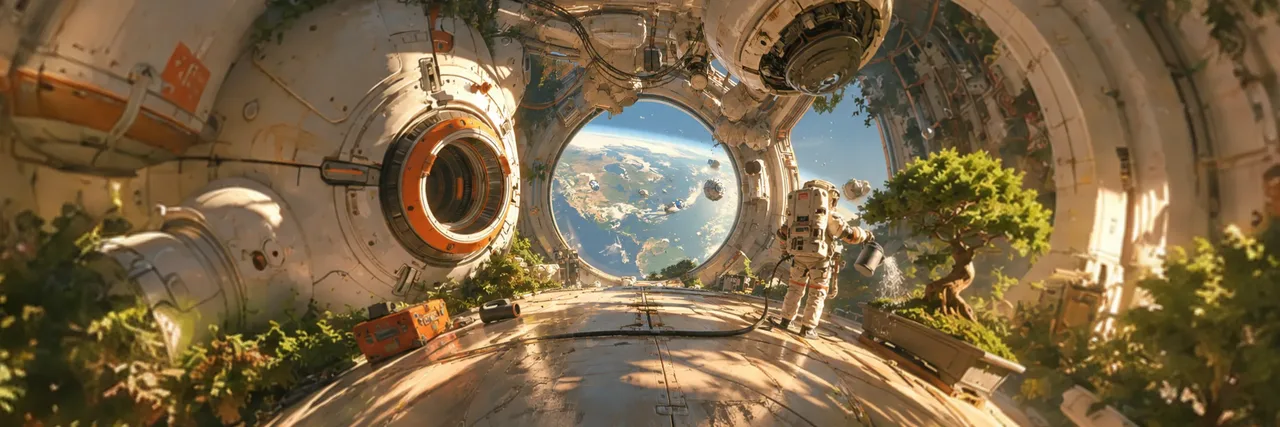 Сцена JST-2: модуль космической станции, где астронавт поливает растения. Изображение: Viggle
Hi3D 1.0, прежде называвшаяся Sparc3D, строит 3D-объект по фотографии и выложена в открытый доступ. Обучена почти на 2 млн отобранных 3D-моделей. Её не стоит путать с версией 3.0: разрешение 2048³ и текстуры 8K относятся именно к ней.
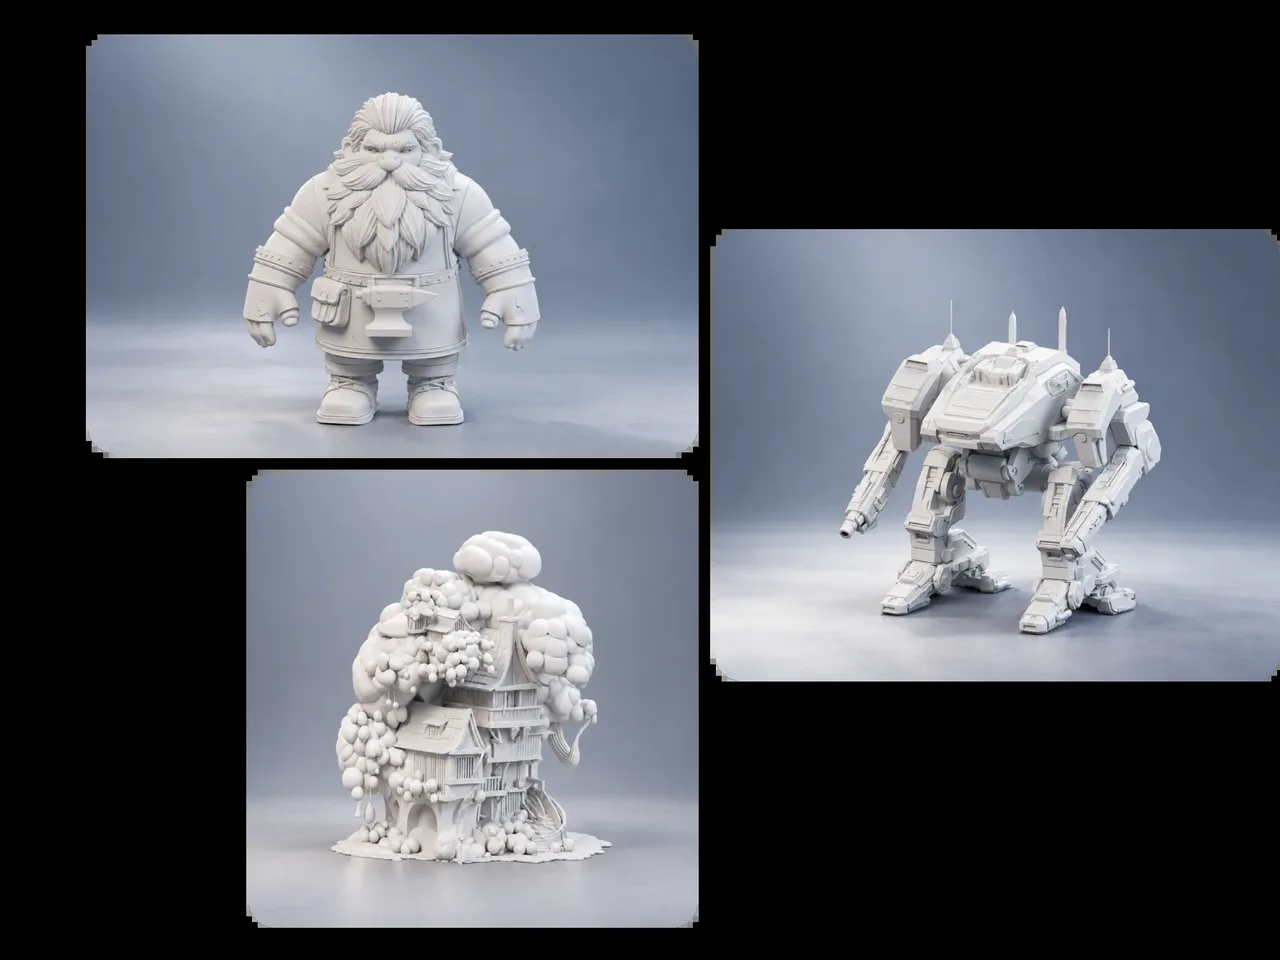 Примеры моделей со страницы открытой Hi3D 1.0. Изображение: Hi3D
PURE из Пекинского университета и HKUST улучшает уже существующие модели 3D-реконструкции VGGT, Depth Anything 3 и Pi3. Их дообучают на обычном видео без 3D-разметки, и на выходе получаются глубина, положение камеры и облако точек.
SKY-001 от Skyfall AI переносит идею модели мира в инженерный дизайн. Модель превращает описание или набросок в пошаговый план для CAD и BIM, разбивая изделие на сборки, детали и эскизы. По тестам компании выигрыш у сравниваемых моделей составляет от 51 до 125 раз по скорости и от 150 до 210 раз по стоимости, но какие это модели, не уточняется. Пока это превью по листу ожидания.
WeVisOne-VL от команды WeChat Vision в Tencent отвечает не только текстом, но и точками, рамками и масками. Модели на 2B и 4B находят объекты по описанию, считают их, читают текст и вырезают фон. Если объекта на картинке нет, модель так и отвечает, а не выдумывает рамку. Лицензия Apache 2.0.
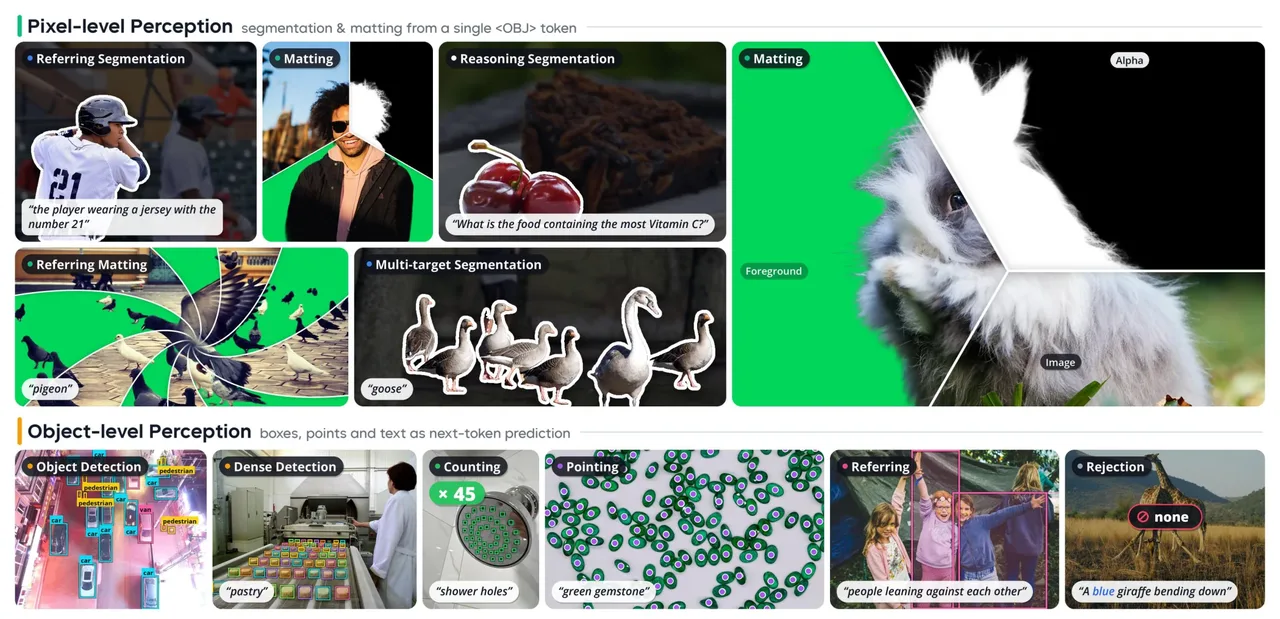 Что умеет WeVisOne-VL: маски, вырезание фона, поиск и подсчёт объектов. Изображение: Tencent WeChat Vision
Что это значит
На тестах открытые модели почти догнали закрытые. Kimi на терминальном тесте отстаёт от Opus 5.5 меньше чем на пункт, Carbon-X на узкой научной задаче держится вровень с GPT-6.1. Но обещание выложить веса и сами веса пока разные вещи. Kimi и MiniMax их ещё не опубликовали, а без весов открытость нельзя проверить.
Второй вывод ближе к теме сайта. Модели всё чаще проектируют под конкретное железо пользователя: MacBook с M4 Max, RTX 5090, DGX Spark, телефон. Обучение по-прежнему требует стоек GB200, но запуск постепенно переезжает на стол. Чтобы понять, какая модель потянет ваш компьютер, начните с руководства «Домашний ИИ» и материала об Ollama. Остальное по теме собрано на странице «ИИ».